Chọn máy chủ AI như thế nào? Hướng dẫn toàn diện về cấu hình phần cứng huấn luyện và suy luận năm 2026
Mở đầu: Vì sao chọn máy chủ AI trở thành môn học bắt buộc của năm 2026
Cấu trúc chi tiêu cho sức mạnh tính toán AI đang thay đổi căn bản. Phân tích do McKinsey công bố tháng 2/2026 chỉ ra rằng đến năm 2030, suy luận (inference) sẽ vượt qua huấn luyện trở thành tải chủ đạo của trung tâm dữ liệu AI, chiếm hơn một nửa tổng sức mạnh tính toán AI và khoảng 30%–40% nhu cầu trung tâm dữ liệu tổng thể. Điều này có nghĩa logic mua máy chủ của doanh nghiệp đang chuyển từ "chất đống card để huấn luyện" sang "tính toán chi li để chạy suy luận" — chọn sai cấu hình, cái giá không phải là mua đắt một lần, mà là mỗi ngày trong ba năm tới đều phải trả tiền điện và tiền thuê cho một kiến trúc sai lầm.
Đồng thời, nhịp đổi mới của sản phẩm GPU tăng nhanh rõ rệt: VRAM 141GB của H200 chưa kịp "ấm chỗ" thì B200 192GB và B300 288GB đã phủ sóng, còn RTX PRO 6000 dùng VRAM 96GB và dạng PCIe chiếm lấy thị trường suy luận tầm trung. Mẫu mã càng nhiều, lựa chọn càng khó. Bài viết này dùng một trục quyết định và hai bảng đối chiếu để nói rõ việc chọn máy chủ AI năm 2026.
Máy chủ huấn luyện và máy chủ suy luận khác nhau ở đâu?
Trả lời nhanh: huấn luyện là công trình một lần "thâm dụng sức mạnh tính toán", suy luận là dịch vụ liên tục "thâm dụng VRAM và băng thông". Máy chủ huấn luyện theo đuổi sức mạnh đỉnh của liên kết đa card (kết nối đầy đủ NVLink/NVSwitch, mật độ công suất cao, tản nhiệt chất lỏng); máy chủ suy luận theo đuổi thông lượng ổn định trên mỗi đơn vị chi phí (VRAM chứa được mô hình, băng thông đẩy ra được token, công suất một card kiểm soát được, tin cậy 7×24).
Đi vào phần cứng, cụm huấn luyện ưu tiên máy nguyên chiếc 8 card dạng SXM và hệ thống mạng IB; triển khai suy luận có lựa chọn rộng hơn — máy trạm một card RTX PRO 6000, máy chủ đa card 2U/4U, thậm chí nút suy luận nhỏ ở biên. Thực tế năm 2026: phần lớn ngân sách AI của doanh nghiệp đổ vào suy luận, vì vậy chọn máy chủ cũng nên "ưu tiên suy luận, huấn luyện theo nhu cầu".
Chọn máy chủ AI, vì sao VRAM quan trọng hơn sức mạnh tính toán?
Trả lời nhanh: mô hình không nhét vừa vào VRAM thì TFLOPS cao đến đâu cũng bằng không. Một mô hình chạy được hay không phụ thuộc vào trọng số + KV Cache + độ dài ngữ cảnh chiếm bao nhiêu VRAM; chỉ sau khi chứa được, băng thông, hỗ trợ FP4/FP8 và giá cả mới có ý nghĩa so sánh.
Quy tắc kinh nghiệm (2026): ở độ chính xác FP16, mô hình 70B cần khoảng 140GB VRAM, một chiếc H200 (141GB) vừa khít, nếu không phải dùng hai chiếc H100; sau lượng tử hóa FP8 nhu cầu giảm một nửa; FP4 lại giảm một nửa nữa, nhưng chỉ kiến trúc Blackwell (B200/B300/RTX PRO 6000) hỗ trợ FP4 nguyên bản. Cửa sổ ngữ cảnh dài gấp đôi, mức chiếm dụng KV Cache tăng gần như tuyến tính — đó là lý do giữa "chứa được" và "phục vụ tốt" còn cách nhau băng thông: H200 là 4.8 TB/s, B200/B300 là 8 TB/s.
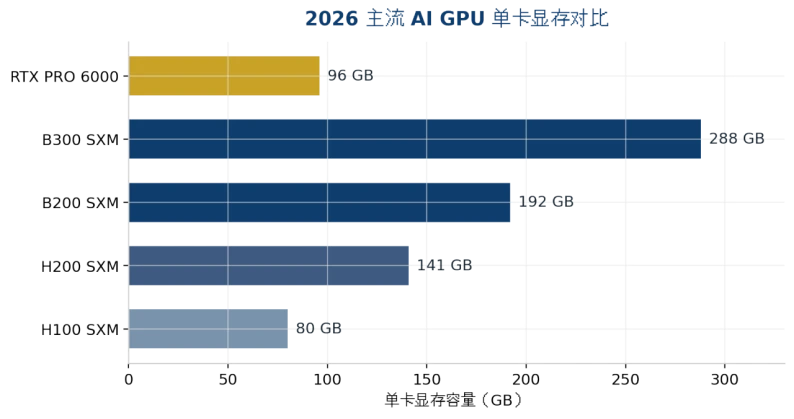
Hình 1: So sánh VRAM trên một card của các GPU AI chủ lực năm 2026 (nguồn dữ liệu xem phụ lục)
Chọn GPU chủ lực năm 2026 như thế nào: so sánh H200, B200, B300, RTX PRO 6000
Trả lời nhanh: mô hình trong vòng 141GB chọn H200 có tính giá-hiệu năng cao nhất; cần FP4 hoặc VRAM lớn hơn chọn B200; một card phải chứa mô hình trên 200GB hoặc áp lực KV Cache lớn chọn B300; suy luận tầm trung và môi trường PCIe chọn RTX PRO 6000.
Chiều | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Kiến trúc | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Băng thông bộ nhớ | 4.8 TB/s | 8 TB/s | 8 TB/s | Khoảng 1.8 TB/s |
Sức mạnh FP4 | Không hỗ trợ | 9 PFLOPS | 15 PFLOPS | Hỗ trợ (cấp một card) |
TDP / Tản nhiệt | 700W / tản khí khả thi | 1000W / khuyến nghị tản chất lỏng | Khoảng 1400W / về cơ bản cần tản chất lỏng | 600W / tản khí |
Định vị điển hình | Suy luận 70B–100B, tinh chỉnh | Suy luận 100B+, huấn luyện | Chứa mô hình lớn tiên phong trên một máy | Suy luận tầm trung, máy trạm/biên |
Tham khảo thuê đám mây 2026 | Khoảng $4.4/GPU·giờ | Khoảng $5–7/GPU·giờ | Khoảng $7.4–8.3/GPU·giờ | Chủ yếu mua nguyên máy |
Bảng 1: So sánh thông số then chốt và định vị của GPU AI chủ lực năm 2026 (giá là giá trị tham khảo thị trường tháng 8/2026, biến động lớn, cần hỏi giá lại trước khi mua)
Còn hai xu hướng dễ bị bỏ qua: thứ nhất, giá thuê đám mây trung vị của H200 đã tăng khoảng 25% từ tháng 8/2025, chênh lệch giá giữa Hopper và Blackwell đang thu hẹp, cửa sổ "mua mẫu cũ cho rẻ" đang khép lại; thứ hai, RTX PRO 6000 ra mắt phiên bản Server 400W, cùng ngân sách công suất có thể lắp nhiều card hơn, thân thiện hơn với nhà cung cấp dịch vụ suy luận tính phí theo token.
Mô hình lớn cỡ nào, máy cấu hình cỡ nào?
Trả lời nhanh: ước tính ngưỡng VRAM tối thiểu theo "trọng số mô hình × 1.2 (chừa dư cho KV Cache)", rồi đối chiếu bảng dưới để xác định số lượng GPU; mô hình vượt quá một nút đơn sẽ đi vào song song đa máy, khi đó mạng quan trọng hơn GPU.
Mô hình mục tiêu (2026) | Kích thước trọng số | Cấu hình tối thiểu | Dạng máy khuyến nghị |
7B–14B (tầm Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 hoặc card máy trạm 48GB | Máy chủ suy luận biên dạng tháp/2U |
32B–70B (lượng tử hóa FP8) | 40–80GB | RTX PRO 6000 ×1–2 hoặc H200 ×1 | Máy chủ GPU 2U/4U |
70B FP16 / ngữ cảnh dài | Khoảng 140GB+ | H200 ×1 (miễn cưỡng) hoặc ×2 (an toàn) | Máy chủ đa card 4U |
DeepSeek V4 Flash (156GB) | Khoảng 156GB | B300 ×1 (dư khoảng 130GB) | Máy chủ tản chất lỏng 4U |
GLM-5.2 FP8 (khoảng 756GB) | Khoảng 756GB | H200 ×8 hoặc B300 ×4 | Máy SXM 8 card |
Kimi K3 (1.56TB MXFP4) | Khoảng 1.56TB | B300 ×8 (tổng VRAM 2.3TB) | Máy flagship tản chất lỏng 8 card |
Bảng 2: Bảng đối chiếu quy mô mô hình với cấu hình máy chủ (trọng số theo checkpoint chính thức, triển khai thực tế cần cộng thêm KV Cache và chi phí runtime)
Bảng này cũng giải thích vì sao khung máy 4U là "thông số ngọt" của máy chủ AI: 8 GPU hai khe, nguồn dự phòng, đường gió tản nhiệt đủ rộng — chỉ không gian 4U mới chứa được đồng thời. 2U phù hợp nút suy luận 2–4 card, 1U chỉ phù hợp một card hoặc làm nút điều phối/lưu trữ phía trước.
Tản nhiệt khí hay tản nhiệt chất lỏng? Định thông số tản nhiệt và rack thế nào?
Trả lời nhanh: một card dưới 700W thì tản khí là đủ; một card trên 1000W hoặc công suất một tủ rack vượt 20kW thì tản chất lỏng từ "điểm cộng" trở thành "ngưỡng cứng". TDP khoảng 1400W của B300 về cơ bản khóa chặt phương án tản chất lỏng.
Thứ tự chọn đúng là: định mô hình và GPU trước, sau đó định công suất nguyên máy, cuối cùng tính ngược ra tản nhiệt và điều kiện phòng máy. Nhiều doanh nghiệp làm ngược — mua máy trước, rồi mới phát hiện điện và điều hòa phòng máy không gánh nổi, buộc phải hạ xung chạy, tương đương bỏ tiền mua một chiếc GPU "mất máu". Trước khi mua phải xác nhận ba điều: điện cấp cho tủ rack (kW), nhiệt độ và lưu lượng gió vào, và không gian nâng cấp cho 2–3 thế hệ GPU tới (sau B300, TDP chỉ cao hơn).
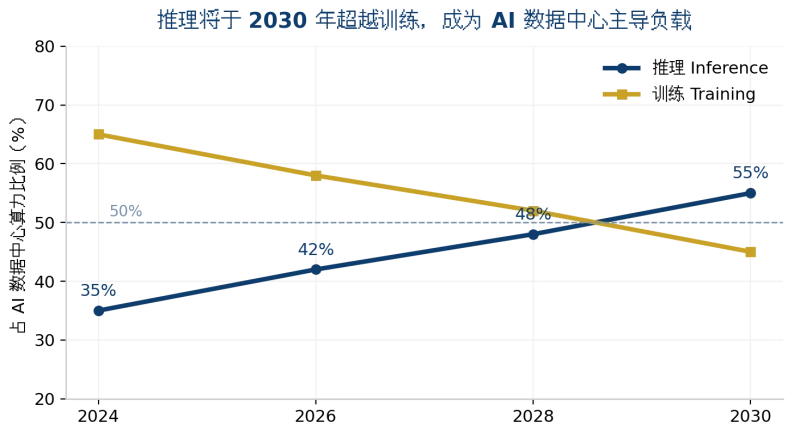
Hình 2: Suy luận sẽ vượt huấn luyện trở thành tải chủ đạo của trung tâm dữ liệu AI vào năm 2030 (minh họa xu hướng, nguồn dữ liệu xem phụ lục)
Thuê đám mây hay tự xây? Tính chi phí thế nào?
Trả lời nhanh: tỷ lệ sử dụng dưới 60% chọn thuê đám mây, tải cao dài hạn chọn tự xây. Theo giá tháng 8/2026, thuê đám mây H200 khoảng 4.4/GPU·giờ, một card chạy đầy tải quanh năm tốn khoảng38.000 tiền thuê — gần bằng chi phí tự mua một card; tỷ lệ sử dụng càng cao, tự xây càng nhanh hoàn vốn.
Phía tự xây còn phải cộng thêm ba khoản: tiền điện phòng máy và vận hành tản nhiệt (chiếm khoảng 20%–30% tổng chi phí sở hữu), khấu hao do GPU đổi thế hệ (năm 2026 H100 đã giảm giá sâu, rủi ro giá trị còn lại là có thật), và tuân thủ dữ liệu — dữ liệu của khách hàng tài chính, y tế, chính doanh không được ra khỏi mạng nội bộ, triển khai riêng tư không phải câu hỏi lựa chọn mà là câu hỏi bắt buộc. Kiến trúc lai đang trở thành chủ lưu: huấn luyện đỉnh lên mây, suy luận thường trú ở tại chỗ.
ChangFan Industrial Computing: máy chủ GPU và phần cứng AI sẵn sàng cho kỷ nguyên suy luận
Cuối cùng, chọn máy chủ AI không phải đấu bảng thông số, mà là "mức độ khớp giữa cấu hình và tình huống". Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) cung cấp máy chủ GPU dạng rack và máy suy luận AI phủ 1U/2U/4U, hỗ trợ mở rộng đa card, nguồn dự phòng và thiết kế nhiệt độ rộng, có thể tùy biến số lượng GPU, cấu hình VRAM và phương án tản nhiệt khí/chất lỏng theo quy mô mô hình mục tiêu, cung cấp nền tảng phần cứng ổn định đáng tin cậy cho các tình huống như triển khai mô hình lớn riêng tư, nút suy luận biên và kho tri thức doanh nghiệp.
Nếu bạn đang đánh giá việc mua và triển khai máy chủ GPU tầm H200/B200/B300 hoặc RTX PRO 6000, hoan nghênh liên hệ ChangFan Industrial Computing để nhận gợi ý cấu hình và phương án nguyên máy cho mô hình mục tiêu (chúng tôi bán phần cứng, làm máy nguyên chiếc, không cung cấp dịch vụ đăng ký phần mềm).
Câu hỏi thường gặp (FAQ)
Hỏi 1: Chạy một mô hình lớn 70B tối thiểu cần cấu hình gì? Đáp: FP16 cần khoảng 140GB VRAM, một chiếc H200 là đáp án kinh tế nhất; sau lượng tử hóa FP8, hai chiếc RTX PRO 6000 (96GB×2) cũng đáp ứng được, chi phí thấp hơn, triển khai linh hoạt hơn.
Hỏi 2: B300 mạnh hơn B200 ở đâu, có đáng chờ không? Đáp: B300 có VRAM nhiều hơn 50% (288GB so với 192GB), sức mạnh FP4 cao gấp 1.5 lần, nhưng băng thông như nhau, TDP tăng lên khoảng 1400W cần tản chất lỏng. Chỉ đáng nâng cấp khi mô hình hoặc KV Cache vượt quá dung lượng nút B200.
Hỏi 3: SME lần đầu mua máy chủ AI nên bắt đầu từ đâu? Đáp: trước hết xác định rõ mô hình cần chạy. Ứng dụng tầm 7B–14B (chăm sóc khách hàng, kho tri thức, kiểm tra chất lượng) chỉ cần một máy chủ suy luận 2U một card là khởi động được; xác định tải cao dài hạn rồi hãy mở rộng lên 4U đa card.
Hỏi 4: Máy chủ AI có bắt buộc dùng tản nhiệt chất lỏng không? Đáp: không. Tình huống một card dưới 700W và phòng máy điều kiện tốt thì tản khí là đủ; một card trên 1000W hoặc triển khai nhiều tủ mật độ cao mới cần tản chất lỏng. Khi chọn nên chừa dư theo xu hướng công suất của 2–3 thế hệ GPU tới.
Hỏi 5: GPU đám mây rẻ vậy, vì sao vẫn phải tự mua máy chủ? Đáp: ba lý do — khi tỷ lệ sử dụng vượt khoảng 60% thì tự xây rẻ hơn; dữ liệu nhạy cảm không được phép ra khỏi mạng nội bộ; suy luận tại chỗ không có độ trễ mạng, SLA tự kiểm soát. Phần lớn doanh nghiệp cuối cùng dùng kiến trúc lai "huấn luyện lên mây, suy luận tại chỗ".