AI服务器怎么选?2026训练与推理场景硬件配置全指南
- 广州长帆智能科技有限公司
- 2026-10-10
引言:为什么AI服务器选型成了2026年的必修课
AI 算力支出的结构正在发生根本变化。麦肯锡 2026 年 2 月发布的分析指出,到 2030 年,推理(inference)将超越训练成为 AI 数据中心的主导负载,占全部 AI 算力的一半以上、约占数据中心总需求的 30%—40%。这意味着企业采购服务器的决策逻辑正在从“堆卡训练”转向“精打细算跑推理”——选错配置,代价不是一次性买贵,而是未来三年每一天都在为错误的架构付电费和租金。
与此同时,GPU 产品的迭代节奏明显加快:H200 的 141GB 显存还没焐热,B200 的 192GB 和 B300 的 288GB 已经铺开,RTX PRO 6000 则以 96GB 显存和 PCIe 形态切走中端推理市场。型号一多,选型反而更难。本文用一条决策轴、两张对照表,把 2026 年 AI 服务器选型讲清楚。
训练服务器和推理服务器到底有什么区别?
一句话答案:训练是“算力密集型”的一次性大工程,推理是“显存与带宽密集型”的持续性服务。训练服务器追求多卡互联的峰值算力(NVLink/NVSwitch 全互联、高功率密度、液冷);推理服务器追求单位成本下的稳定吞吐(显存装得下模型、带宽跑得出 token、单卡功耗可控、7×24 可靠)。
落到硬件上,训练集群优先考虑 SXM 形态的 8 卡整机和 IB 组网;推理部署则有更宽的选项——单卡 RTX PRO 6000 工作站、2U/4U 多卡服务器、甚至边缘侧的小型推理节点。2026 年的现实是:绝大多数企业的 AI 预算花在推理上,服务器选型也应该“推理优先、训练按需”。
选AI服务器,为什么显存比算力更重要?
一句话答案:模型装不进显存,再高的 TFLOPS 都是零。一个模型能否运行,取决于权重 + KV Cache + 上下文长度占用多少显存;只有装下之后,带宽、FP4/FP8 支持、价格才有比较的意义。
经验法则(2026 年):FP16 精度下,70B 模型约需 140GB 显存,单张 H200(141GB)正好装下,否则就要两张 H100;FP8 量化后需求减半;FP4 再减半,但只有 Blackwell 架构(B200/B300/RTX PRO 6000)原生支持 FP4。上下文窗口每拉长一倍,KV Cache 占用近似线性增长——这就是为什么“能装下”和“能服务好”之间还差着带宽:H200 是 4.8 TB/s,B200/B300 是 8 TB/s。
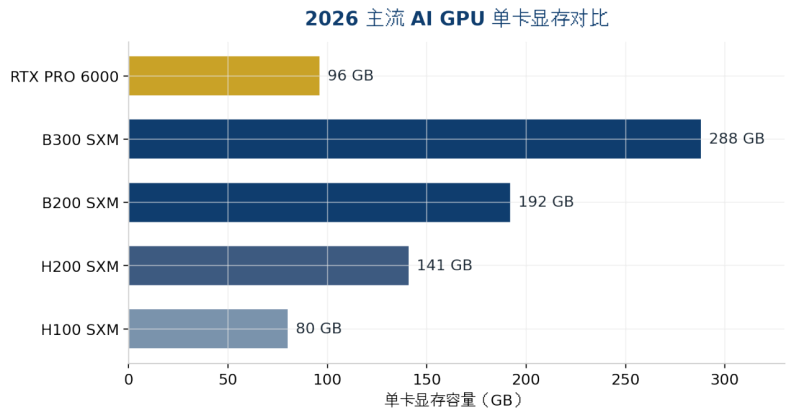
图 1:2026 主流 AI GPU 单卡显存对比(数据来源见附录)
2026年主流GPU怎么选:H200、B200、B300、RTX PRO 6000对比
一句话答案:模型在 141GB 以内选 H200 最具性价比;需要 FP4 或更大显存选 B200;单卡要装 200GB 以上模型或 KV Cache 压力大选 B300;中端推理和 PCIe 环境选 RTX PRO 6000。
维度 | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
架构 | Hopper | Blackwell | Blackwell Ultra | Blackwell |
显存 | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
显存带宽 | 4.8 TB/s | 8 TB/s | 8 TB/s | 约 1.8 TB/s |
FP4 算力 | 不支持 | 9 PFLOPS | 15 PFLOPS | 支持(单卡级) |
TDP / 散热 | 700W / 风冷可行 | 1000W / 建议液冷 | 约 1400W / 基本需液冷 | 600W / 风冷 |
典型定位 | 70B-100B 推理、微调 | 100B+ 推理、训练 | 前沿大模型单机承载 | 中端推理、工作站/边缘 |
2026 云租参考 | 约 $4.4/GPU·时 | 约 $5-7/GPU·时 | 约 $7.4-8.3/GPU·时 | 整机采购为主 |
表 1:2026 主流 AI GPU 关键规格与定位对比(价格为 2026 年 8 月市场参考值,波动大,采购前需重新询价)
还有两个容易被忽略的趋势:其一,H200 的云租中位价自 2025 年 8 月以来已上涨约 25%,Hopper 与 Blackwell 的价差在收窄,“买旧款省钱”的窗口正在关闭;其二,RTX PRO 6000 推出了 400W 的 Server 版本,同功率预算下可以部署更多卡,对按 token 计费的推理服务商更友好。
模型多大,机器配多少?
一句话答案:按“模型权重 × 1.2(留 KV Cache 余量)”估算显存下限,再对照下表确定 GPU 数量;超出单节点的模型进入多机并行,网络比 GPU 更重要。
目标模型(2026) | 权重大小 | 最低配置 | 推荐整机形态 |
7B-14B(Qwen/Phi 级) | 15-30GB(FP16) | RTX PRO 6000 ×1 或 48GB 工作站卡 | 塔式/2U 边缘推理服务器 |
32B-70B(FP8 量化) | 40-80GB | RTX PRO 6000 ×1-2 或 H200 ×1 | 2U/4U GPU 服务器 |
70B FP16 / 长上下文 | 约 140GB+ | H200 ×1(勉强)或 ×2(稳妥) | 4U 多卡服务器 |
DeepSeek V4 Flash(156GB) | 约 156GB | B300 ×1(余量约 130GB) | 4U 液冷服务器 |
GLM-5.2 FP8(约 756GB) | 约 756GB | H200 ×8 或 B300 ×4 | 8 卡 SXM 整机 |
Kimi K3(1.56TB MXFP4) | 约 1.56TB | B300 ×8(2.3TB 总显存) | 8 卡液冷旗舰整机 |
表 2:模型规模与服务器配置对照(权重按官方 checkpoint 口径,实际部署需加 KV Cache 与运行时开销)
这张表也解释了为什么 4U 机箱是 AI 服务器的“甜点规格”:8 张双宽 GPU、冗余电源、足够的散热风道,只有 4U 的空间能同时容纳。2U 适合 2—4 卡的推理节点,1U 只适合单卡或用作前置调度/存储节点。
风冷还是液冷?散热和机架规格怎么定?
一句话答案:单卡 700W 以下风冷够用;单卡 1000W 以上、或单机柜功率超过 20kW,液冷从“加分项”变成“硬门槛”。B300 约 1400W 的 TDP 基本锁定液冷方案。
选型的正确顺序是:先定模型和 GPU,再定整机功率,最后倒推散热与机房条件。很多企业反过来做——先买了机器,才发现机房供电和空调撑不住,被迫降频运行,等于花钱买了张“残血”GPU。采购前务必确认三项:机柜供电(kW)、进风温度与风量、以及未来 2—3 代 GPU 的升级空间(B300 之后 TDP 只会更高)。
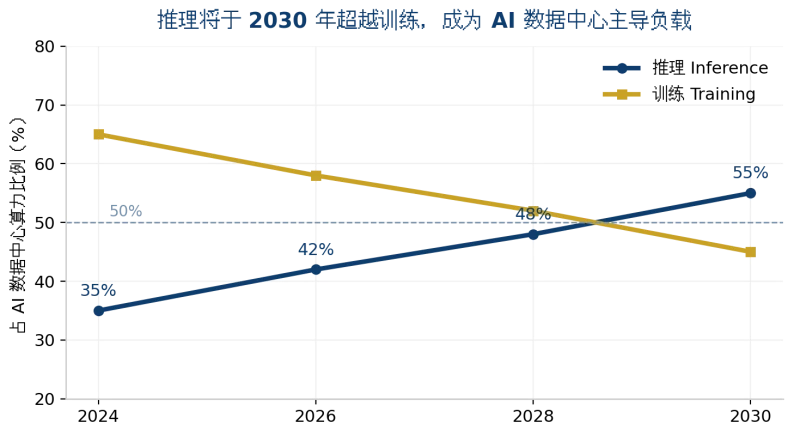
图 2:推理将于 2030 年超越训练成为 AI 数据中心主导负载(趋势示意,数据来源见附录)
云租还是自建?成本怎么算?
一句话答案:利用率低于 60% 选云租,长期高负载选自建。以 2026 年 8 月行情,H200 云租约 4.4/GPU·时,一张卡全年满负荷租金约3.8 万——接近自购一张卡的成本,利用率一高,自建就回本。自建派的账还要加上三件事:机房电费和散热运维(约占总拥有成本 20%—30%)、GPU 迭代折旧(2026 年 H100 已深度折价,残值风险真实存在)、以及数据合规——金融、医疗、政企客户的数据出不了内网,私有化部署不是选择题而是必答题。混合架构正在成为主流:峰值训练上云,常驻推理本地。
长帆工控:为推理时代准备的 GPU 服务器与 AI 硬件
AI 服务器选型最终拼的不是参数表,而是“配置与场景的匹配度”。广州长帆智能科技有限公司(长帆工控 / ChangFan)提供覆盖 1U/2U/4U 的机架式 GPU 服务器与 AI 推理整机,支持多卡扩展、冗余电源与宽温设计,可根据目标模型规模定制 GPU 数量、显存配置与风冷/液冷散热方案,面向私有化大模型部署、边缘推理节点与企业知识库等场景交付稳定可靠的硬件底座。
如果您正在评估 H200/B200/B300 或 RTX PRO 6000 级 GPU 服务器的采购与部署,欢迎联系长帆工控获取针对目标模型的配置建议与整机方案(卖硬件、做整机,不提供软件订阅服务)。
常见问题(FAQ)
Q1:跑一个 70B 大模型至少要什么配置?A:FP16 约需 140GB 显存,单张 H200 是最经济的答案;FP8 量化后两张 RTX PRO 6000(96GB×2)也可胜任,成本更低、部署更灵活。
Q2:B300 比 B200 强在哪,值不值得等?A:B300 显存多 50%(288GB 对 192GB)、FP4 算力高 1.5 倍,但带宽相同、TDP 升至约 1400W 需液冷。模型或 KV Cache 超出 B200 节点容量时才值得升级。
Q3:中小企业第一次买 AI 服务器,推荐什么起步?A:先明确要跑的模型。7B—14B 级应用(客服、知识库、质检)一台 2U 单卡推理服务器即可起步;确定长期高负载再扩到 4U 多卡。
Q4:AI 服务器必须用液冷吗?A:不是。单卡 700W 以下、机房条件良好的场景风冷足够;单卡 1000W 以上或高密度多机柜部署才需要液冷。选型时应按未来 2—3 代 GPU 的功耗趋势预留余量。
Q5:云 GPU 这么便宜,为什么还要自购服务器?A:三个理由——利用率超过约 60% 时自建成本更低;敏感数据不允许出内网;本地推理无网络延迟、SLA 自主可控。多数企业最终采用“训练上云、推理本地”的混合架构。