Hur väljer man en AI-server? Den kompletta hårdvarukonfigurationsguiden 2026 för träning och inferens
Introduktion: därför blev AI-serverval obligatorisk läxa 2026
Strukturen på utgifterna för AI-beräkningar förändras i grunden. En analys från McKinsey publicerad i februari 2026 visar att inferens fram till 2030 kommer att gå om träning som den dominerande arbetslasten i AI-datacenter – med mer än hälften av all AI-beräkning och cirka 30–40 % av datacentrens totala efterfrågan. För företag förskjuts inköpslogiken från att 'stapla kort för träning' till att 'köra inferens med stram kostnadskontroll' – fel konfiguration kostar inte en engångsöverbetalning utan tre år av dagliga el- och hyresräkningar för fel arkitektur.
Samtidigt har GPU:ernas iterationstakt tydligt accelererat: knappt har H200:s 141GB VRAM hunnit landa förrän B200:s 192GB och B300:s 288GB rullas ut, medan RTX PRO 6000 med 96GB och PCIe-format tar marknadsandelar i inferenssegmentet i mellanklassen. Fler modeller gör paradoxalt nog valet svårare. Den här artikeln klargör AI-servervalet 2026 med en beslutsaxel och två jämförelsetabeller.
Vad är egentligen skillnaden mellan en träningsserver och en inferensserver?
Kort svar: träning är ett engångs- 'beräkningsintensivt' megaprojekt; inferens är en 'VRAM- och bandbreddsintensiv' kontinuerlig tjänst. Träningsservern jagar topprestanda i multi-GPU-sammankoppling (full NVLink/NVSwitch-fabric, hög effekttäthet, vätskekylning); inferensservern jagar stabil genomströmning per kostnadsenhet (VRAM som rymmer modellen, bandbredd som levererar tokens, kontrollerad effekt per kort, 7×24-tillförlitlighet).
Hårdvarumässigt föredrar träningskluster 8-GPU-maskiner i SXM-format med InfiniBand-nätverk; inferens har ett mycket bredare utrymme – arbetsstationer med ett enda RTX PRO 6000, multi-GPU-servrar i 2U/4U och till och med kompakta inferensnoder i periferin. Verkligheten 2026: den absoluta merparten av företagens AI-budgetar går till inferens, så servervalet bör följa principen 'inferens först, träning vid behov'.
Varför är VRAM viktigare än beräkningskraft vid val av AI-server?
Kort svar: ryms modellen inte i VRAM är de högsta TFLOPS-värdena noll. Om en modell kan köras beror på hur mycket VRAM vikterna + KV Cache + kontextlängden upptar; först när den ryms blir bandbredd, FP4/FP8-stöd och pris meningsfulla jämförelsepunkter.
Tumregel (2026): vid FP16-precision kräver en 70B-modell cirka 140GB VRAM – ett enda H200 (141GB) rymmer den exakt, annars behövs två H100; FP8-kvantisering halverar behovet; FP4 halverar det igen, men bara Blackwell-arkitekturen (B200/B300/RTX PRO 6000) stödjer FP4 nativt. Varje fördubbling av kontextfönstret ökar KV Cache-användningen nästan linjärt – därför ligger det mellan 'ryms' och 'serverar bra' fortfarande bandbredd: H200 levererar 4,8 TB/s, B200/B300 levererar 8 TB/s.
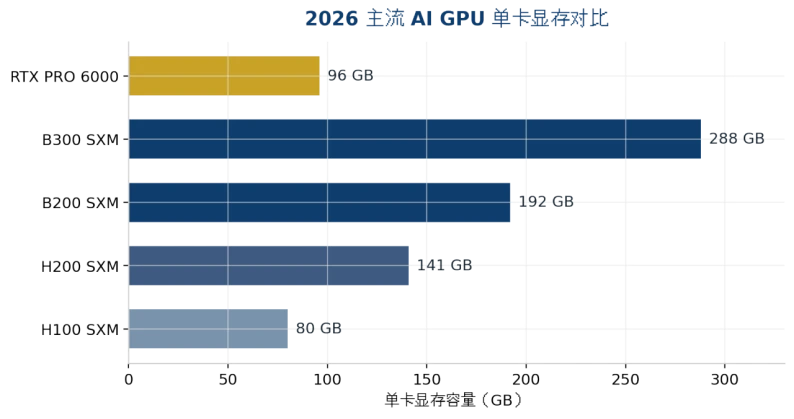
Figur 1: VRAM-jämförelse per kort för de ledande AI-GPU:erna 2026 (datakällor i bilagan)
Hur väljer man bland 2026 års GPU:er: H200 vs B200 vs B300 vs RTX PRO 6000
Kort svar: för modeller upp till 141GB ger H200 bäst prisvärdhet; välj B200 när du behöver FP4 eller mer VRAM; välj B300 när ett enda kort ska rymma en modell över 200GB eller KV Cache-trycket är högt; välj RTX PRO 6000 för inferens i mellanklass och PCIe-miljöer.
Dimension | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arkitektur | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Minnesbandbredd | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
FP4-beräkningskraft | Stöds ej | 9 PFLOPS | 15 PFLOPS | Stöds (enkortsklass) |
TDP / kylning | 700 W / luftkylning möjlig | 1000 W / vätskekylning rekommenderas | ~1400 W / vätskekylning i praktiken krävs | 600 W / luftkylning |
Typisk positionering | 70B–100B-inferens, finjustering | 100B+-inferens, träning | Frontier-LLM:er på en enda nod | Mellanklass-inferens, arbetsstation/edge |
Referens för molnhyrning 2026 | ~$4.4/GPU·tim | ~$5–7/GPU·tim | ~$7.4–8.3/GPU·tim | Främst köp av kompletta system |
Tabell 1: Nyckelspecifikationer och positionering för de ledande AI-GPU:erna 2026 (priser är marknadsreferenser från augusti 2026 och mycket volatila – begär ny offert före köp)
Det finns dessutom två lättförbisedda trender: för det första har medianpriset för molnmhyrning av H200 stigit cirka 25 % sedan augusti 2025, prisgapet mellan Hopper och Blackwell krymper och fönstret att 'spara med förra generationen' håller på att stängas; för det andra finns RTX PRO 6000 nu i en 400W-serverversion som tillåter fler kort inom samma effektbudget – vänligare för inferensleverantörer som debiterar per token.
Hur stor är modellen, hur mycket maskin behövs?
Kort svar: uppskatta VRAM-golvet som 'modellvikter × 1,2 (marginal för KV Cache)' och bestäm sedan antalet GPU:er med tabellen nedan; modeller som överstiger en enda nod går över till multimaskinsparallellism, där nätverket är viktigare än GPU:erna.
Målmodell (2026) | Viktstorlek | Minimikonfiguration | Rekommenderad formfaktor |
7B–14B (Qwen/Phi-klass) | 15–30GB (FP16) | RTX PRO 6000 ×1 eller 48GB-arbetsstationskort | Tower-/2U-edge-inferensserver |
32B–70B (FP8-kvantiserad) | 40–80GB | RTX PRO 6000 ×1–2 eller H200 ×1 | 2U/4U-GPU-server |
70B FP16 / lång kontext | ~140GB+ | H200 ×1 (tight) eller ×2 (säkert) | 4U-multi-GPU-server |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (~130GB marginal) | 4U-server med vätskekylning |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 eller B300 ×4 | 8-GPU-SXM-system |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB total VRAM) | 8-GPU-flaggskepp med vätskekylning |
Tabell 2: Modellstorlek kontra serverkonfiguration (vikter enligt officiella checkpoints; vid faktisk driftsättning ska KV Cache och runtime-omkostnader läggas till)
Den här tabellen förklarar också varför 4U-chassit är 'sweet spot' för AI-servrar: 8 dubbelbreda GPU:er, redundanta nätaggregat och tillräcklig kylluftsföring – bara ett 4U-rack rymmer allt samtidigt. 2U passar för inferensnoder med 2–4 kort; 1U rymmer bara ett kort eller fungerar som frontnoder för schemaläggning/lagring.
Luft- eller vätskekylning? Hur bestämmer man termiska och rack-specifikationer?
Kort svar: under 700 W per kort räcker luftkylning; över 1000 W per kort – eller över 20 kW per rack – går vätskekylning från 'bonus' till 'hårt krav'. B300:s TDP på ~1400 W låser i princip fast vätskekylning.
Rätt urvalsordning är: först modell och GPU, sedan maskinens totala effekt, och först därefter bakåträkning av kylning och rumsförhållanden. Många företag gör tvärtom – köper maskinerna först och upptäcker sedan att strömförsörjning och klimatanläggning inte räcker till, och tvingas nedklocka: som att betala fullpris för en 'kastrerad' GPU. Bekräfta tre saker före köp: rackens strömförsörjning (kW), inloppstemperatur och luftvolym, samt utrymme för de kommande 2–3 GPU-generationerna (efter B300 kommer TDP bara att stiga).
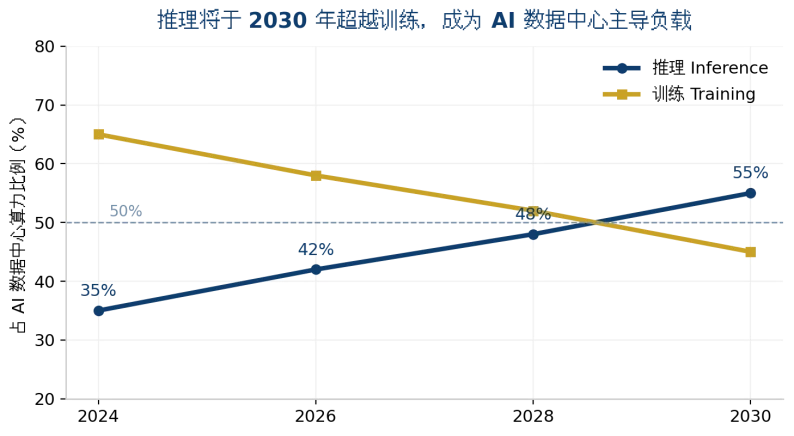
Figur 2: Inferens går om träning som den dominerande arbetslasten i AI-datacenter senast 2030 (trendillustration; datakällor i bilagan)
Molnhyrning eller egen byggnad? Hur räknar man?
Kort svar: under 60 % utnyttjande lönar sig molnhyrning; vid varaktigt hög belastning lönar sig egen infrastruktur. Enligt priserna i augusti 2026 kostar molnhyrning av en H200 cirka 4,4 /GPU·timme – ungefär 38 000 för ett helt år på full last, nära kostnaden för att köpa ett kort. Ju högre utnyttjande, desto snabbare betalar sig den egna infrastrukturen.
Till den egna kalkylen ska tre poster läggas till: el och kylningsdrift (cirka 20–30 % av den totala ägandekostnaden), värdeminskning genom GPU-generationer (H100 är 2026 redan djupt nedsatt – restvärdesrisken är reell) samt dataefterlevnad: för finans-, vård- och myndighetskunder får data inte lämna intranätet, vilket gör privat driftsättning inte till ett val utan ett krav. Hybridarkitekturen blir mainstream: topplast-träning i molnet, permanent inferens lokalt.
ChangFan: GPU-servrar och AI-hårdvara redo för inferens-eran
I slutändan vinner man inte AI-servervalet på specifikationsblad utan på hur väl konfigurationen matchar scenariot. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) erbjuder rackmonterade GPU-servrar och AI-inferenssystem i formaten 1U/2U/4U, med multi-GPU-expansion, redundanta nätaggregat och design för brett temperaturområde. Antal GPU:er, VRAM-konfiguration och luft-/vätskekylning anpassas efter målmodellens storlek – en stabil och pålitlig hårdvarugrund för privat LLM-driftsättning, edge-inferensnoder och företagskunskapsbaser.
Om ni utvärderar köp och driftsättning av GPU-servrar i klassen H200/B200/B300 eller RTX PRO 6000 är ni välkomna att kontakta ChangFan för konfigurationsrådgivning och förslag på kompletta system anpassade till er målmodell (vi säljer hårdvara och bygger kompletta system – vi erbjuder inga mjukvaruabonnemang).
Vanliga frågor (FAQ)
F1: Vilken minimikonfiguration krävs för att köra en 70B-LLM? S: Vid FP16 behövs cirka 140GB VRAM, så ett enda H200 är det mest ekonomiska svaret; efter FP8-kvantisering klarar även två RTX PRO 6000-kort (96GB×2) jobbet – billigare och mer flexibelt att driftsätta.
F2: Hur är B300 bättre än B200 och är det värt att vänta? S: B300 erbjuder 50 % mer VRAM (288GB mot 192GB) och 1,5× FP4-beräkningskraft, men samma bandbredd och en TDP som stigit till ~1400 W och kräver vätskekylning. Uppgradera först när modellen eller KV Cache överstiger kapaciteten hos en B200-nod.
F3: Vad bör ett litet och medelstort företag börja med vid köp av sin första AI-server? S: Definiera först vilken modell som ska köras. För 7B–14B-tillämpningar (kundtjänst, kunskapsbas, kvalitetskontroll) räcker en 2U-inferensserver med ett kort för att börja; skala upp till 4U multi-GPU när varaktigt hög belastning är bekräftad.
F4: Är vätskekylning obligatoriskt för AI-servrar? S: Nej. Under 700 W per kort och med goda rumsförhållanden räcker luft; vätska behövs först över 1000 W per kort eller vid täta multi-rack-installationer. Lämna marginal för effekttrenden hos de kommande 2–3 GPU-generationerna.
F5: Moln-GPU:er är så billiga – varför köpa en egen server? S: Tre skäl – över cirka 60 % utnyttjande är egen infrastruktur billigare; känsliga data får inte lämna intranätet; lokal inferens har ingen nätverkslatens och SLA under egen kontroll. De flesta företag landar i en hybridarkitektur med 'träning i molnet, inferens lokalt'.