Framväxten av Edge AI: Varför små modeller flyttar beräkningskraften bort från molnet
Introduktion: AI:ns tyngdpunkt flyttar från molnet till edgen
De senaste tre åren har företagens standardhållning till AI varit att ”anropa ett moln-API”. 2026 skrivs den hållningen om: Gartner förutspår att 40 % av företagens AI-arbetsbelastningar till 2027 kommer att flytta från stora molnmodeller till små språkmodeller (SLM); branschstatistik visar att 73 % av organisationerna flyttar inferensen till edge-miljöer för energieffektivitetens skull; och den globala edge-AI-marknaden väntas växa från 46,96 miljarder dollar 2026 till 445,75 miljarder dollar 2034, med en CAGR på 32,5 %. Beräkningarnas tyngdpunkt återvänder från ”avlägsna maskinhallar” till ”där data föds”.
Det som driver migrationen är inte stämningen utan tre räkningar: kostnadsräkningen (inferens med små modeller kan sänka kostnaderna med upp till 75 %), latensräkningen (50–200 millisekunder lokalt, molnets tur-och-retur kan inte hänga med) och integritetsräkningen (data lämnar inte fabriken, sjukhuset eller det interna nätverket). Alla tre räkningarna ligger precis på hårdvarutillverkarnas hemmaplan.
Vad är edge-AI? Vad skiljer den i grunden från moln-AI?
Kort svar: edge-AI kör modellinferensen på lokala enheter nära sensorer, maskiner och användare, i stället för att skicka data till molnet och vänta på svaret tillbaka. Den väsentliga skillnaden: data står still, det är modellen som rör sig.
Att ”data står still” ger tre strukturella fördelar: för det första krymper latensen från ”nätverkstur-och-retur + kö” till ren beräkningstid — industriell visuell kvalitetskontroll kan komma ner i 50 millisekunder; för det andra offline-drift: AGV-truckar, fältinspektioner och offshore-plattformar blir inte ”dumma” när nätet darrar; för det tredje förblir känslig data lokal från början till slut, vilket naturligt uppfyller efterlevnadskraven inom vård, finans och offentlig sektor. Moln-AI passar fortfarande för mycket storskalig träning och elastiska toppar, men inferensens ”sista mil” sker allt oftare på edgen.
Varför kan små modeller (SLM) ta huvudrollen 2026?
Kort svar: eftersom ”tillräckliga” modeller har blivit mer än en storleksordning billigare — att serva en SLM i 7B-klassen kostar 10–30 gånger mindre än stora modeller i 70B–175B-klassen, de samlade utgifterna för GPU + moln + energi kan sänkas med upp till 75 %, och den klarar 80–90 % av företagens uppgifter.
Tre symboliska fakta: Microsofts Phi-4 med 14B parametrar närmar sig DeepSeek R1 med 671B i matematiskt resonemang; en juridisk SLM på 7B nådde 94 % träffsäkerhet i avtalsgranskning och passerade GPT-5:s 87 %; i början av 2026 migrerade AT&T den automatiserade kundservicen till ett kluster av finjusterade Mistral/Phi-modeller, sänkte de månatliga API-kostnaderna med 90 % och förbättrade svarshastigheten med 70 %. Företagens standardarkitektur blir ”hybrid” — SLM:n hanterar 80–95 % av rutinförfrågningarna, komplext resonemang dirigeras till moln-LLM:en. Gartners prognos är ännu mer direkt: till 2027 använder företag uppgiftsspecialiserade små modeller 3 gånger oftare än universella stora modeller.
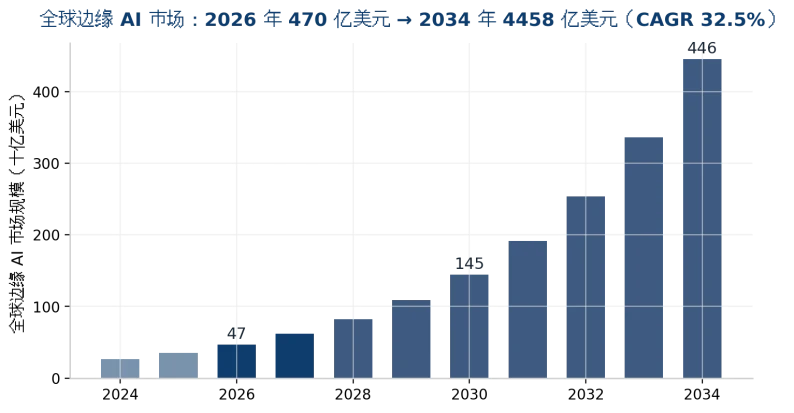
Figur 1: prognos för den globala edge-AI-marknaden (2026–2034, datakällor i bilagan)
Hur väljer man hårdvara för edge-AI?
Kort svar: välj utifrån två axlar — ”modellstorlek + miljöförhållanden”: för lätt vision/NLP under 7B inbyggda moduler i Jetson-klass eller mini-PC med NPU; för 7B–70B x86 industri-PC + ett/två GPU; för humanoida robotar och multimodala stora modeller plattform i Jetson Thor-klass.
Plattformsnivå | Representativ plattform | AI-beräkningskraft | Energiförbrukning | Typiska scenarier |
Lätt edge | Jetson Orin Nano Super | 67 TOPS | 7-25 W | En-/tvåkanalig visuell inspektion, OCR, smarta kameror |
Mellanklass-edge | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Flerkanalig kvalitetskontroll, AGV/AMR, robotarmsvision |
Flaggskepps-edge | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Humanoida robotar, LLM på edgen, multimodal |
x86 industri-PC + GPU | Industri-PC + RTX PRO 6000 (96 GB) | FP4 i enkelkortsklass | Hela systemet 300-700 W | Privat verkstadskunskapsbas, inferens i 70B-klass, blandade vision- + språkbelastningar |
Desktop-AI-box | AI-station med unified memory (128 GB-klass) | ~1 PFLOP (FP4) | 150-300 W | Utveckling och felsökning, privat assistent på avdelningsnivå (referenspris 4 699 USD) |
Tabell 1: jämförelse per nivå av hårdvaruplattformar för edge-AI (2026; beräkningssiffrorna använder olika mått och är inte direkt jämförbara mellan raderna — endast som valreferens)
Det som lätt underskattas är miljöindikatorerna: temperatur, damm, vibration och spänningsvariationer i verkstaden — konsumentenheter tål inte det. Det industriella valet måste kontrollera det breda temperaturområdet (klass -25 °C till 70 °C), den fläktlösa/vibrationståliga konstruktionen, MTBF vid 7×24 kontinuerlig drift samt att I/O-gränssnitten (flera GbE, PoE, CAN, seriella portar) matchar den befintliga linjen.
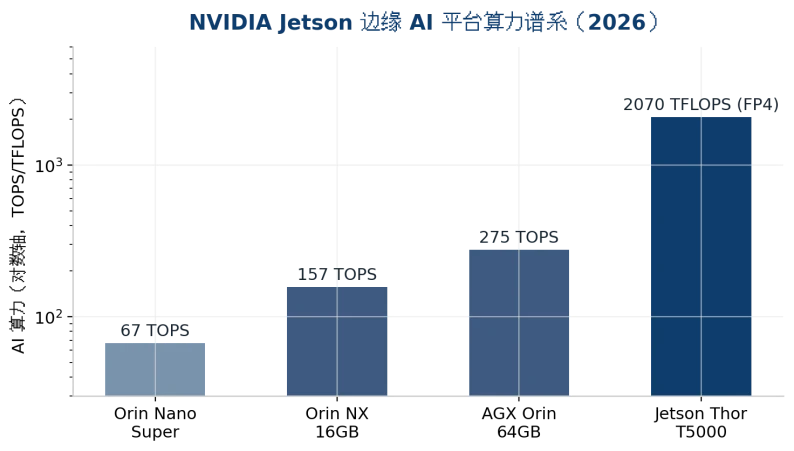
Figur 2: beräkningskraftsortiment för Jetson-plattformarna för edge-AI (logaritmisk axel, 2026)
Vilka scenarier kräver edge-AI?
▪Industriell kvalitetskontroll och prediktivt underhåll: linjens takt mäts i millisekunder, och att felbilderna inte lämnar fabriken är samtidigt hastighet och sekretess.
▪AGV/AMR och robotik: i rörelse är nätet opålitligt; hinderundvikande och ruttplanering måste ske lokalt i realtid.
▪Vård och finans: patientjournaler, bilder och transaktionsdata är bundna av efterlevnad — privat driftsättning är inträdesbiljetten, inte en bonus.
▪Energi och fältarbete: offshore-plattformar, gruvor och inspektioner av elnät lever året om med svagt eller inget nät; lokal intelligens är det enda alternativet.
▪Butikskedjor och filialer: huvudkontoret distribuerar modellerna nedåt, butikerna kör inferensen lokalt — bandbreddskostnader och datareturtryck sjunker samtidigt.
ChangFan Industrial Computing: edge-hårdvara som installerar stora modeller i verkstäder och skåp
Att förverkliga edge-AI handlar till hälften om modellen och till hälften om ”lådan där modellen bor”. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) erbjuder edge computing-hårdvara från lätt till flaggskepp: inbyggda industri-PC och box-PC med brett temperaturområde och vibrationstålighet, edge-AI-allt-i-ett-system med stöd för ett/två GPU, samt 2U/4U GPU-servrar för privat driftsättning på avdelningsnivå — kompatibla med de vanliga lokala inferensstackarna Ollama, vLLM, OpenWebUI och ComfyUI, och anpassningsbara för linjemiljön: brett temperaturområde, fläktlös, flera LAN-portar och PoE.
Oavsett om ni driftsätter en kvalitetskontrollmodell på 7B eller en företagskunskapsbas på 70B kan ChangFan Industrial Computing föreslå en komplett konfiguration enligt ”modellskala × platsmiljö”. Kontakta oss för valrådgivning (hårdvarulösningar och kompletta system; inget programvaruabonnemang).
Vanliga frågor (FAQ)
F1: Räcker en liten modell på 7B verkligen? S: Tillräckligt för 80–90 % av företagens repetitiva uppgifter. Efter domänfinjustering når modeller i 7B-klassen 94 % träffsäkerhet i uppgifter som avtalsgranskning; vanlig praxis är att SLM:n hanterar rutinförfrågningar och dirigerar komplexa frågor till den stora molnmodellen.
F2: Vilken hårdvara behövs för att köra en 7B-modell lokalt? S: Efter kvantisering cirka 8–16 GB VRAM/minne — en mini-PC med NPU eller en enhet i Jetson Orin-klass räcker; för flerkanalig genomströmning rekommenderas en industri-PC med ett GPU från 48 GB.
F3: Är edge-AI och privat driftsättning samma sak? S: Inte riktigt. Privat driftsättning betonar att data inte lämnar företaget (den kan ligga på servrar i datacentret); edge-AI betonar beräkning nära datakällan (verkstad, butik, enhet). De två överlappar ofta: edge-noder + företagets privata moln.
F4: Vad skiljer en industri-PC som kör AI från en konsumentdator? S: Brett temperaturområde (klass -25 °C till 70 °C), vibrationstålighet, dammskydd, 7×24 kontinuerlig drift, lång leveranslivscykel och industriella gränssnitt. Konsumentdatorer går sönder märkbart oftare i linjemiljöer — de dolda kostnaderna överstiger prisskillnaden med råge.
F5: Kommer edge-AI att ersättas av stora molnmodeller? S: Marknadsdata ger det motsatta svaret — edge-AI-marknaden växer med en CAGR på 32,5 % och inferensbelastningarna fortsätter att migrera till lokal nivå. Framtiden är en arbetsfördelning ”träning i molnet, inferens på edgen”, inte en ersättning.