Uç Yapay Zekasının Yükselişi: Küçük Modeller İşlem Yükünü Neden Buluttan Geri Çekiyor?
Kısa yanıt: Uç yapay zeka, model çıkarımının buluta gönderilmeden doğrudan yerel donanımda veya verinin üretildiği yere yakın bir cihazda çalıştırılması anlamına gelir. Küçük modeller (SLM'ler), bu donanımda verimli çalışmak üzere tasarlanmış kompakt dil modelleridir (genellikle 1 ila 14 milyar parametre). İkisinin birleşimi, kuruluşların ağ bağlantısına bağımlı olmadan 50 ila 200 milisaniye gecikmeyle yerelde yapay zeka çıkarımı çalıştırmasına olanak tanır — tam veri egemenliğini koruyarak ve çıkarım maliyetlerini bulut API'lerine kıyasla %75'e kadar azaltarak.
Bu yapısal bir değişimdir, geçici bir moda değil.
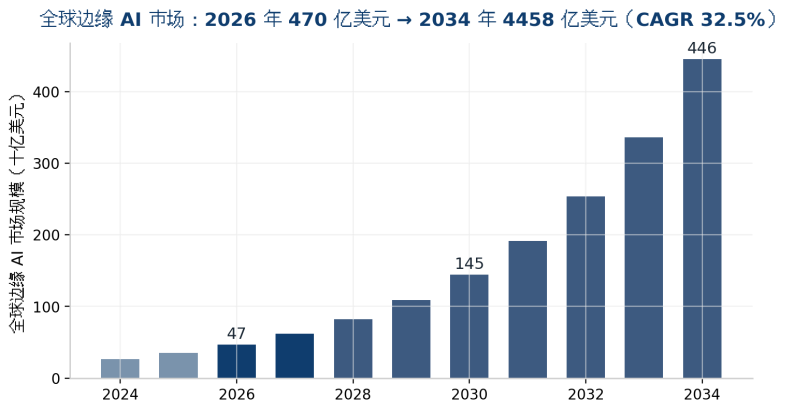
Gartner, 2027 sonuna kadar kuruluşların %40'ının hassas verileri kendi operasyonel ortamlarında işlemek için uç yapay zeka kullanacağını öngörüyor — 2023'te bu oran %5'in altındaydı. Bunun nedeni, ekonomik, düzenleyici ve teknik baskıların yakınsamasıdır.
Bu makale üç temel soruyu yanıtlıyor: küçük modeller neden aniden yeterince iyi hale geldi; uç yapay zeka dağıtımı hangi gerçek sorunları çözüyor; ve kuruluşların 2026'da uç yapay zeka dağıtmak için hangi donanıma ihtiyacı var.
Üç yapısal itici gücün yakınsaması
İlk itici güç ekonomiktir: bulut çıkarım maliyeti son derece değişken ve öngörülemezdir. İkinci itici güç düzenleyicidir: GDPR, HIPAA ve Çin'in veri yerelleştirme yasaları gibi düzenlemeler, birçok kuruluş için hassas verilerin harici bulut altyapısına gönderilmesini zorlaştırmış veya imkansız hale getirmiştir. Üçüncü itici güç tekniktir: küçük modeller artık iki yıl önce devasa LLM'ler gerektiren birçok görevi gerçekleştirebiliyor.
Bu üç itici güç, yalnızca teknoloji devlerine değil, küçük ve orta ölçekli işletmelere de açık bir dağıtım penceresi oluşturdu.
Küçük modeller büyük modellere karşı: Gerçekte ne değişti
SLM'deki «küçük» etiketi yanıltıcıdır. 2026'da 7 ila 14 milyar parametreli bir model «küçük» sayılıyor — ancak Microsoft'un 14 milyar parametreli Phi-4'ü, GSM8K matematik kıyaslamasında %94 doğruluk elde ederken GPT-5 %87'de kalıyor. Bu bir istisna değil: yapılandırılmış verilere sahip uzmanlık alanlarında, ince ayarlanmış küçük modeller, yüz kat daha büyük genel modelleri sürekli olarak geride bırakıyor.
Nedeni basit: alana özgü eğitim. Tıbbi belgeler, yasal sözleşmeler veya ekipman bakım raporları üzerinde eğitilmiş küçük bir model, o alanda büyük genel modelden daha doğrudur — çünkü filtrelenmesi gereken daha az gürültü vardır.
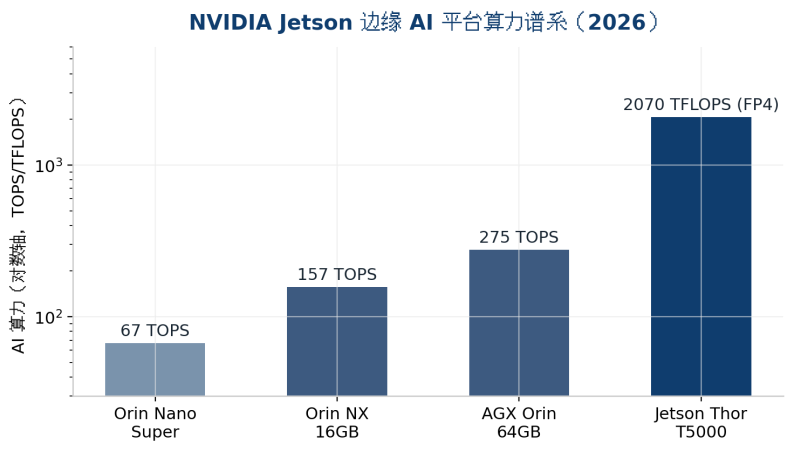
Uç dağıtımı için bu şu anlama gelir: model, Jetson Thor veya endüstriyel bilgisayarda çalışacak kadar küçük; yanıtlar, gerçek zamanlı uygulamaları destekleyecek kadar hızlı; ve çıkarım başına maliyet, bir bulut API çağrısının onda biri ile otuzda biri arasındadır.
Aynı zamanda, küçük modeller her amaç için uygun değildir. Karmaşık çok adımlı akıl yürütme, uzun içerik üretimi ve geniş genel bilgi gerektiren görevlerde büyük modeller hala üstündür. Bu nedenle gelecek hibrittir — ikame değil.
Donanım seviyesi | Temsili platformlar | Güç (TOPS) | Önerilen RAM | Güç tüketimi |
Tahmini fiyat | Birincil uygulama | Kompakt / giriş seviyesi | Jetson Orin Nano / NUC | 67 TOPS |
8 ila 16GB | 15 ila 30W | 400 ila 800 dolar | Sensörler, kameralar | Orta seviye endüstriyel |
Jetson AGX Orin / IPC | 157 ila 275 TOPS | 32 ila 64GB | 30 ila 100W | 1.500 ila 5.000 dolar |
Görsel denetim, robotik | Üst seviye / profesyonel | Jetson Thor / RTX 5090 | 2070 teraflop FP4 | 48GB ve üzeri |
300 ila 700W | 4.699 dolar ve üzeri | Fiziksel yapay zeka, ağır çıkarım | Kurumsal / uç veri merkezi | RTX 6000 Ada / H100 |
Uygulamada hibrit mimari
Hibrit yapay zeka, yerel küçük modellerin veri toplama, ön işleme, gerçek zamanlı görevler ve ilk yanıtları üstlenmesi, bulut LLM'lerin ise karmaşık akıl yürütme, bilgi arama ve yaratıcı işler için kullanılması anlamına gelir. Bu mimari her ikisinin de avantajlarını korur: uçta düşük gecikme ve veri egemenliği, bulutta yüksek hesaplama gücü.
Araştırmalar, üretim çıkarım iş yüklerinin %80 ila %95'inin uçta küçük modellerle yapılabileceğini ve yalnızca %5 ila %20'sinin gerçekten büyük bulut modelleri gerektirdiğini gösteriyor. AT&T, akıllı yönlendirme yoluyla çıkarım maliyetini %90 azalttı ve yanıt hızını %70 artırdı — yalnızca karmaşık sorguları büyük modellere göndererek.
Özel dağıtım: rekabet avantajı olarak veri egemenliği
Üretim, enerji, ulaşım ve finansal hizmetler için özel yapay zeka dağıtımı yalnızca düzenleyici bir gereklilik değil — rekabet avantajıdır. Model kuruluşun ağı içinde çalıştığında, veriler asla dışarı çıkmaz: eğitim için değil, işleme için değil. Bu, veri sızıntısı, gizlilik anlaşmalarının ihlali ve tedarikçi bağımlılığı risklerini ortadan kaldırır.
Maliyet açısından da caziptir: uç dağıtımı tek seferlik bir donanım yatırımıyla gerçekleşir ve ardından çıkarım başına maliyet neredeyse sıfırdır — bulut API'leri ise her çağrıda ücret alır. Sık tekrarlanan uygulamalar (görsel denetim, ekipman izleme, belge işleme) için maliyet farkı birkaç ay içinde belirginleşir.
Fiziksel yapay zekanın yükselişi
Fiziksel yapay zeka — yani robotlarda, araçlarda ve endüstriyel ekipmanlarda çalışan yapay zeka — uç donanımı gerektirir, çünkü fiziksel kararlar bulut gidiş-dönüşünü bekleyemez. 50 milisaniye içinde yanıt vermesi gereken bir robotik kol, 200 milisaniye gecikmeli bir bulut API'sine güvenemez.
Endüstriyel bilgisayarlar burada devreye girer: tüketici dizüstü bilgisayarlarının aksine, zorlu ortamlarda 7/24 çalışma için üretilmişlerdir — -25 ila 70 santigrat derece sıcaklık, fansız, toza ve titreşime dayanıklı. Bu özellikler fiziksel yapay zeka için isteğe bağlı değildir.
Uç yapay zeka donanımı: 2026 satın alma rehberi
ChangFan Industrial Computing, üretim, enerji ve ulaşım ortamları için uç yapay zeka donanım çözümleri sunmaktadır.
Uç donanımı seçimindeki temel soru şudur: hangi modeli, hangi çıkarım hızıyla çalıştırmak istiyorsunuz?
7 ila 14 milyar parametreli modeller (Phi-4, Mistral, nicemlenmiş Llama 3.x) için NVIDIA Jetson AGX Orin (67 TOPS) veya Jetson Thor (157 ila 275 TOPS) yeterlidir. 30 ila 70 milyar parametreli modellerle daha ağır çıkarım için, üst düzey tüketici GPU'lu bir iş istasyonu (RTX 5090, 2070 teraflop FP4) veya kompakt veri merkezi GPU'su (RTX 6000 Ada, yaklaşık 1 petaflop FP4) gerekir.
RAM önemlidir: nicemlenmiş 7 milyar parametreli modeller 8 ila 16GB, 14 milyar parametreli modeller 32 ila 48GB ve nicemlenmiş 70 milyar parametreli modeller 96GB veya daha fazlasını gerektirir. Düşük bellek, birçok uç dağıtımının gerçek darboğazıdır.
Zorlu ortamlar (fabrika zemini, açık alan, araçlar) için geniş sıcaklık aralıklı (-25 ila 70 santigrat derece) ve endüstriyel güç kaynaklı fansız endüstriyel bilgisayarlar zorunludur. Tüketici donanımı bu koşullarda birkaç ay içinde arızalanır.
Sektöre göre pratik uygulamalar
Üretim: üretim hattında gerçek zamanlı görsel denetim, titreşim ve ses analiziyle kestirimci bakım, süreç parametrelerinin optimizasyonu. Uç avantajı: saniyeler değil, milisaniyeler içinde hat durdurma kararları.
Enerji ve altyapı: güvenilir ağ kapsaması olmayan uzak konumlarda ekipman izleme, trafo merkezlerinde anomali tespiti, türbin arızası tahmini. Uç avantajı: internet bağlantısından bağımsız çalışma.