El auge de la IA en el borde: por qué los modelos pequeños devuelven la computación de la nube al entorno local
Introducción: el centro de gravedad de la IA se desplaza de la nube al borde
Durante los últimos tres años, la postura estándar de las empresas ante la IA era «llamar a una API en la nube». En 2026 esa postura se está reescribiendo: Gartner prevé que para 2027 el 40 % de las cargas de trabajo de IA empresariales pasarán de los grandes modelos en la nube a los modelos de lenguaje pequeños (SLM); las estadísticas del sector muestran que el 73 % de las organizaciones trasladan la inferencia a entornos de borde por eficiencia energética; y se espera que el mercado mundial de IA en el borde crezca de 46.960 millones de dólares en 2026 a 445.750 millones en 2034, con una TCAC del 32,5 %. El centro de gravedad de la computación regresa de las «salas de máquinas lejanas» a «donde nacen los datos».
Lo que impulsa esta migración no es el ánimo, sino tres cuentas: la cuenta de costes (la inferencia con modelos pequeños puede reducir los costes hasta un 75 %), la cuenta de la latencia (50–200 milisegundos en local, el viaje de ida y vuelta a la nube no puede competir) y la cuenta de la privacidad (los datos no salen de la fábrica, el hospital o la red interna). Las tres cuentas son precisamente el terreno natural de los fabricantes de hardware.
¿Qué es la IA en el borde? ¿En qué se diferencia fundamentalmente de la IA en la nube?
Respuesta rápida: la IA en el borde ejecuta la inferencia del modelo en dispositivos locales cercanos a sensores, máquinas y usuarios, en lugar de enviar los datos a la nube y esperar el resultado de vuelta. La diferencia esencial: los datos no se mueven, se mueve el modelo.
Que «los datos no se mueven» aporta tres ventajas estructurales: primero, la latencia se comprime de «ida y vuelta por la red + cola» al tiempo de cálculo puro — la inspección visual industrial puede bajar a 50 milisegundos; segundo, funciona sin conexión: los AGV, las inspecciones de campo y las plataformas marinas no «se quedan tontos» cuando la red tiembla; tercero, los datos sensibles permanecen locales de principio a fin, cumpliendo de forma natural los requisitos de cumplimiento en salud, finanzas y sector público. La IA en la nube sigue siendo adecuada para el entrenamiento a gran escala y los picos elásticos, pero la «última milla» de la inferencia ocurre cada vez más en el borde.
¿Por qué los modelos pequeños (SLM) pueden asumir el protagonismo en 2026?
Respuesta rápida: porque los modelos «suficientes» han bajado de precio más de un orden de magnitud — servir un SLM de clase 7B cuesta entre 10 y 30 veces menos que un modelo grande de 70B–175B, los gastos combinados de GPU + nube + energía pueden reducirse hasta un 75 %, y resuelve con solvencia el 80–90 % de las tareas empresariales.
Tres hechos emblemáticos: Phi-4 de Microsoft, con 14B de parámetros, se acerca al DeepSeek R1 de 671B en razonamiento matemático; un SLM jurídico de 7B alcanzó un 94 % de precisión en revisión de contratos, superando el 87 % de GPT-5; a principios de 2026, AT&T migró su atención al cliente automatizada a un clúster de modelos Mistral/Phi ajustados, reduciendo el coste mensual de API un 90 % y mejorando la velocidad de respuesta un 70 %. La arquitectura estándar de las empresas se vuelve «híbrida»: el SLM procesa el 80–95 % de las solicitudes rutinarias y el razonamiento complejo se enruta al LLM en la nube. La predicción de Gartner es aún más directa: para 2027, las empresas usarán modelos pequeños especializados por tarea 3 veces más que los grandes modelos generalistas.
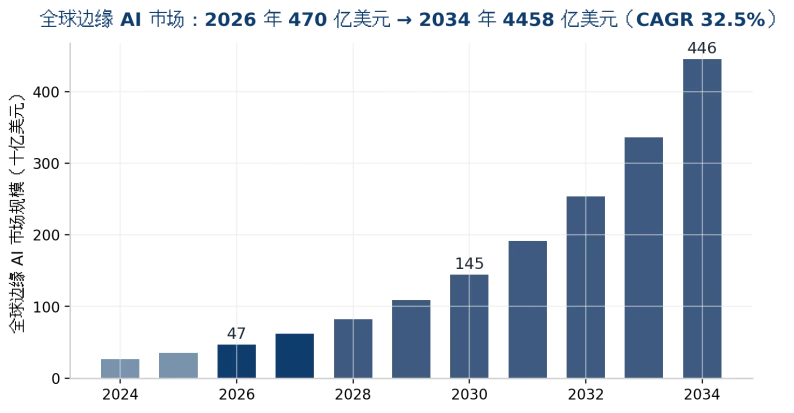
Figura 1: previsión del mercado mundial de IA en el borde (2026–2034, fuentes de datos en el anexo)
¿Cómo elegir el hardware de IA en el borde?
Respuesta rápida: seleccionar según dos ejes — «tamaño del modelo + condiciones del entorno»: para visión/NLP ligera por debajo de 7B, módulos integrados de clase Jetson o mini PC con NPU; para 7B–70B, PC industrial x86 + una/dos GPU; para robots humanoides y grandes modelos multimodales, plataforma de clase Jetson Thor.
Nivel de plataforma | Plataforma representativa | Potencia de cómputo IA | Consumo | Escenarios típicos |
Borde ligero | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Inspección visual de uno/dos canales, OCR, cámaras inteligentes |
Borde de gama media | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Control de calidad multicanal, AGV/AMR, visión de brazos robóticos |
Borde insignia | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Robots humanoides, LLM en el borde, multimodal |
PC industrial x86 + GPU | PC industrial + RTX PRO 6000 (96 GB) | FP4 de clase de una tarjeta | Sistema completo 300-700 W | Base de conocimiento privada de taller, inferencia de clase 70B, cargas mixtas de visión + lenguaje |
Caja de IA de escritorio | Estación de IA de memoria unificada (clase 128 GB) | ~1 PFLOP (FP4) | 150-300 W | Desarrollo y depuración, asistente privado a nivel de departamento (precio de referencia 4.699 $) |
Tabla 1: comparación por niveles de plataformas de hardware de IA en el borde (2026; las cifras de cómputo usan métricas distintas y no son directamente comparables entre filas — solo como referencia de selección)
Lo que se subestima con facilidad son los indicadores ambientales: temperatura, polvo, vibración y fluctuaciones de voltaje en el taller — los dispositivos de consumo no lo soportan. La selección industrial debe verificar el rango de temperatura amplio (clase de -25 °C a 70 °C), el diseño sin ventilador/antivibración, el MTBF en funcionamiento continuo 7×24 y la correspondencia de las E/S (GbE múltiples, PoE, CAN, puertos serie) con la línea existente.
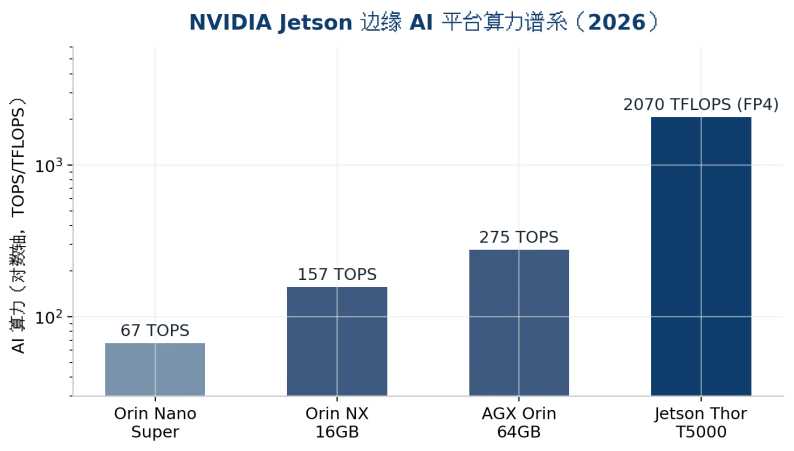
Figura 2: gama de potencia de cómputo de las plataformas Jetson para IA en el borde (eje logarítmico, 2026)
¿Qué escenarios exigen IA en el borde?
▪Control de calidad industrial y mantenimiento predictivo: el takt de la línea se mide en milisegundos, y que las imágenes de defectos no salgan de la fábrica es a la vez velocidad y confidencialidad.
▪AGV/AMR y robótica: en movimiento la red no es fiable; la evitación de obstáculos y la planificación de rutas deben realizarse localmente en tiempo real.
▪Salud y finanzas: historiales médicos, imágenes y datos de transacciones están sujetos a cumplimiento — el despliegue privado es el billete de entrada, no un extra.
▪Energía y trabajos de campo: plataformas marinas, minas e inspecciones de redes eléctricas viven todo el año con red débil o sin ella; la inteligencia local es la única opción.
▪Cadenas de tiendas y sucursales: la central distribuye los modelos, las tiendas ejecutan la inferencia en local — los costes de ancho de banda y la presión de retorno de datos bajan a la vez.
ChangFan Industrial Computing: hardware de borde que instala los grandes modelos en talleres y armarios
Hacer realidad la IA en el borde depende mitad del modelo y mitad de la «caja donde vive el modelo». Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) ofrece hardware de computación en el borde de ligero a insignia: PC industriales y box PC integrados de temperatura amplia y resistentes a vibraciones, sistemas todo en uno de IA en el borde compatibles con una/dos GPU, y servidores GPU 2U/4U para despliegue privado a nivel de departamento — compatibles con las pilas de inferencia locales principales Ollama, vLLM, OpenWebUI y ComfyUI, y personalizables para el entorno de la línea: temperatura amplia, sin ventilador, múltiples puertos LAN y PoE.
Tanto si despliega un modelo de control de calidad de 7B como una base de conocimiento empresarial de 70B, ChangFan Industrial Computing puede proponer una configuración completa según «escala del modelo × entorno del sitio». Contáctenos para asesoramiento de selección (soluciones de hardware y sistemas completos; no se ofrece suscripción de software).
Preguntas frecuentes (FAQ)
P1: ¿De verdad basta un modelo pequeño de 7B? R: Basta para el 80–90 % de las tareas repetitivas de las empresas. Tras el ajuste de dominio, los modelos de clase 7B alcanzan un 94 % de precisión en tareas como la revisión de contratos; la práctica habitual es que el SLM procese las solicitudes rutinarias y enrute las preguntas complejas al modelo grande en la nube.
P2: ¿Qué hardware se necesita para ejecutar un modelo 7B en local? R: Tras la cuantización, unos 8–16 GB de VRAM/memoria — basta un mini PC con NPU o un dispositivo de clase Jetson Orin; para rendimiento multiconcurrente se recomienda un PC industrial con una GPU de 48 GB o más.
P3: ¿IA en el borde y despliegue privado son lo mismo? R: No exactamente. El despliegue privado subraya que los datos no salen de la empresa (pueden residir en servidores del centro de datos); la IA en el borde subraya la computación junto a la fuente de datos (taller, tienda, dispositivo). Ambos se superponen con frecuencia: nodos de borde + nube privada de la empresa.
P4: ¿Qué diferencia hay entre un PC industrial ejecutando IA y un ordenador de consumo? R: Temperatura amplia (clase de -25 °C a 70 °C), resistencia a vibraciones, protección contra el polvo, funcionamiento continuo 7×24, largo ciclo de suministro e interfaces industriales. Las máquinas de consumo fallan con mucha más frecuencia en entornos de línea — los costes ocultos superan con creces la diferencia de precio.
P5: ¿Será la IA en el borde sustituida por los grandes modelos en la nube? R: Los datos del mercado responden lo contrario — el mercado de IA en el borde crece a una TCAC del 32,5 % y las cargas de inferencia siguen migrando a lo local. El futuro es una división del trabajo «entrenamiento en la nube, inferencia en el borde», no una sustitución.