エッジAIの台頭:なぜ小型モデルはクラウドからコンピューティングを呼び戻しているのか
- 広州長帆智能科技有限公司
- 2026-10-12
一言で答えると:エッジAIとは、クラウドに送らず、ローカルハードウェアまたはデータが生成される場所の近くのデバイスでモデル推論を直接実行することを意味します。小規模モデル(SLM)は、このハードウェアで効率的に動作するよう設計されたコンパクトな言語モデル(通常10億〜140億パラメータ)です。この2つの組み合わせにより、組織はネットワーク接続に依存せず、50〜200ミリ秒の遅延でローカルにAI推論を実行でき、完全なデータ主権を維持しながら、クラウドAPIと比較して推論コストを最大75%削減できます。
これは一時的なトレンドではなく、構造的な転換です。
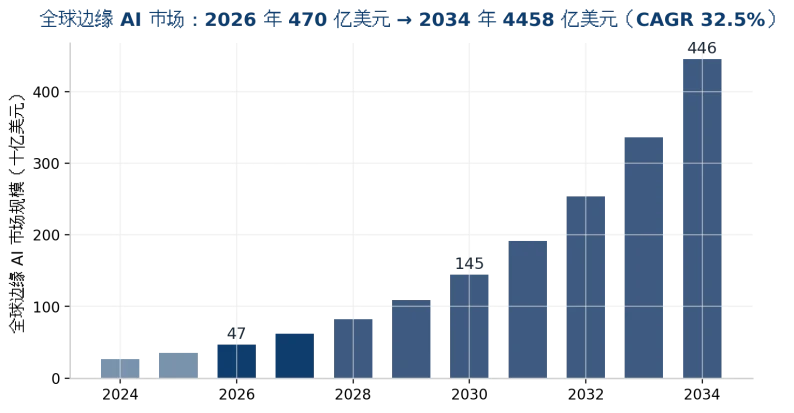
ガートナーは、2027年末までに40%の組織が運用環境で機密データを処理するためにエッジAIを使用すると予測しています — 2023年にはこの割合は5%未満でした。その理由は、経済的、規制的、技術的圧力の収束です。
この記事は3つの重要な質問に答えます:小規模モデルが突然十分に優れたものになった理由、エッジAI導入が解決する実際の問題、そして2026年にエッジAIをデプロイするために組織に必要なハードウェア。
3つの構造的ドライバーの収束
最初のドライバーは経済的です:クラウド推論コストは非常に変動しやすく予測不可能です。2番目のドライバーは規制的です:GDPR、HIPAA、中国のデータローカライゼーション法などの規制により、多くの組織にとって機密データを外部クラウドインフラに送ることが困難または不可能になりました。3番目のドライバーは技術的です:小規模モデルは今や、2年前には巨大なLLMが必要だった多くのタスクを実行できます。
これら3つのドライバーは、技術大手だけでなく中小企業にも開かれたデプロイの機会を生み出しました。
小規模モデル対大規模モデル:実際に何が変わったのか
SLMの「小規模」というラベルは誤解を招きます。2026年には、70億〜140億パラメータのモデルが「小規模」と見なされます — しかし、140億パラメータのマイクロソフトPhi-4はGSM8K数学ベンチマークで94%の精度を達成し、GPT-5は87%にとどまります。これは例外ではありません:構造化データを持つ専門ドメインでは、ファインチューニングされた小規模モデルが、数百倍大きい汎用モデルを一貫して上回ります。
理由は簡単です:ドメイン特化のトレーニング。医療文書、法的契約、または設備保全レポートでトレーニングされた小規模モデルは、そのドメインで大規模な汎用モデルよりも正確です — フィルタリングすべきノイズが少ないからです。
エッジデプロイにとって、これは次を意味します:モデルはJetson Thorや産業用コンピュータで実行できるほど小さく、応答はリアルタイムアプリケーションをサポートできるほど速く、推論あたりのコストはクラウドAPI呼び出しの10分の1から30分の1です。
同時に、小規模モデルは万能ではありません。複雑な多段階推論、長文コンテンツ生成、広範な一般知識を必要とするタスクでは、大規模モデルが依然として優位です。だからこそ、未来はハイブリッドです — 置き換えではありません。
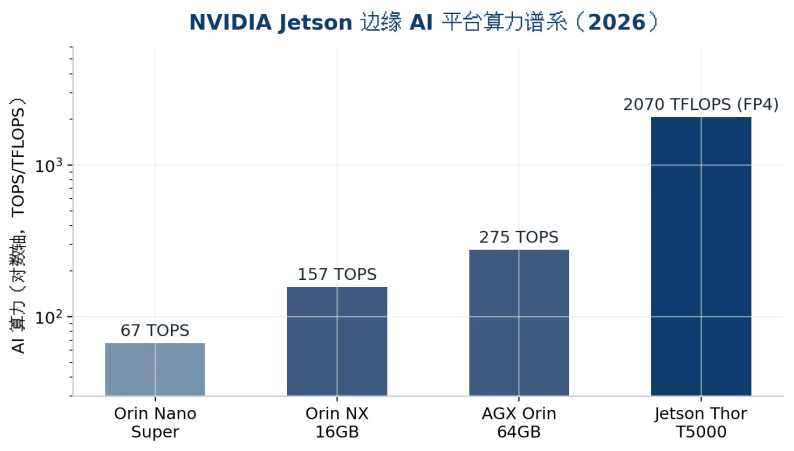
ハードウェアグレード | 代表的なプラットフォーム | 性能 (TOPS) | 推奨RAM | 消費電力 |
想定価格 | 主な用途 | コンパクト / エントリーレベル | Jetson Orin Nano / NUC | 67 TOPS |
8〜16GB | 15〜30W | 400〜800ドル | センサー、カメラ | 中級産業用 |
Jetson AGX Orin / IPC | 157〜275 TOPS | 32〜64GB | 30〜100W | 1,500〜5,000ドル |
ビジョン検査、ロボティクス | ハイエンド / プロフェッショナル | Jetson Thor / RTX 5090 | 2070テラフロップス FP4 | 48GB以上 |
300〜700W | 4,699ドル以上 | フィジカルAI、高負荷推論 | エンタープライズ / エッジデータセンター | RTX 6000 Ada / H100 |
実践におけるハイブリッドアーキテクチャ
ハイブリッドAIとは、ローカルの小規模モデルがデータ収集、前処理、リアルタイムタスク、初期応答を処理し、クラウドLLMは複雑な推論、知識検索、創造的な作業に使用されることを意味します。このアーキテクチャは両方の利点を保持します:エッジでの低遅延とデータ主権、クラウドでの高いコンピューティングパワー。
調査によると、プロダクション推論ワークロードの80〜95%はエッジの小規模モデルで実行でき、実際に大規模クラウドモデルを必要とするのは5〜20%に過ぎません。AT&Tはスマートルーティングにより推論コストを90%削減し、応答速度を70%向上させました — 複雑なクエリのみを大規模モデルに送信することで。
プライベートデプロイ:競争上の優位性としてのデータ主権
製造、エネルギー、運輸、金融サービスにとって、プライベートAIデプロイは単なる規制要件ではありません — 競争上の優位性です。モデルが組織のネットワーク内で実行される場合、データは決して外部に出ません:トレーニングのためでも、処理のためでも。これにより、データ漏洩、機密保持契約違反、ベンダー依存のリスクが排除されます。
コストの観点からも魅力的です:エッジデプロイは1回のハードウェア投資で行われ、その後の推論あたりのコストはほぼゼロです — クラウドAPIは呼び出しごとに課金されます。頻繁に繰り返されるアプリケーション(ビジョン検査、設備監視、文書処理)では、数か月以内にコスト差が明確になります。
フィジカルAIの台頭
フィジカルAI — つまりロボット、車両、産業機器で実行されるAI — はエッジハードウェアを必要とします。物理的な決定はクラウドの往復を待つことができないからです。50ミリ秒以内に応答する必要があるロボットアームは、200ミリ秒の遅延があるクラウドAPIに依存できません。
ここで産業用コンピュータが登場します:消費者向けノートパソコンとは異なり、過酷な環境での24時間365日稼働のために作られています — 摂氏マイナス25度から70度の温度、ファンレス、防塵・耐振動。これらの機能はフィジカルAIにとってオプションではありません。
エッジAIハードウェア:2026年購入ガイド
ChangFan Industrial Computingは、製造、エネルギー、運輸環境向けのエッジAIハードウェアソリューションを提供しています。
エッジハードウェア選択の重要な質問は次のとおりです:どのモデルを、どの推論速度で実行したいか?
70億〜140億パラメータのモデル(Phi-4、Mistral、量子化されたLlama 3.x)の場合、NVIDIA Jetson AGX Orin(67 TOPS)またはJetson Thor(157〜275 TOPS)で十分です。300億〜700億パラメータのモデルでより重い推論を行うには、ハイエンド消費者向けGPUを搭載したワークステーション(RTX 5090、2070テラフロップス FP4)またはコンパクトなデータセンターGPU(RTX 6000 Ada、約1ペタフロップ FP4)が必要です。
RAMは重要です:量子化された70億パラメータモデルには8〜16GB、140億モデルには32〜48GB、量子化された700億モデルには96GB以上が必要です。メモリ不足は多くのエッジデプロイの実際のボトルネックです。
過酷な環境(工場フロア、屋外、車両)では、広い温度範囲(摂氏マイナス25度〜70度)と産業用電源を備えたファンレス産業用コンピュータが必須です。消費者向けハードウェアは、これらの条件下で数か月以内に故障します。
業界別の実用的なアプリケーション
製造:生産ラインでのリアルタイムビジョン検査、振動と音の分析による予知保全、プロセスパラメータの最適化。エッジの利点:秒ではなくミリ秒でのライン停止決定。
エネルギーとインフラ:信頼できるネットワークカバレッジのない遠隔地での設備監視、変電所での異常検出、タービン故障の予測。エッジの利点:インターネット接続から独立した運用。