Kebangkitan AI Pinggir: Mengapa Model Berskala Kecil Membawa Kembali Pemprosesan Data dari Awan
Jawapan ringkas: AI pinggir bermaksud menjalankan inferens model secara langsung pada perkakasan tempatan atau peranti berhampiran tempat data dijana, tanpa menghantarnya ke awan. Model kecil (SLM) ialah model bahasa padat (biasanya 1 hingga 14 bilion parameter) yang direka untuk berjalan cekap pada perkakasan ini. Gabungan kedua-duanya membolehkan organisasi menjalankan inferens AI secara tempatan dengan latensi 50 hingga 200 milisaat, tanpa bergantung pada sambungan rangkaian — sambil mengekalkan kedaulatan data penuh dan memotong kos inferens sehingga 75% berbanding API awan.
Ini ialah peralihan struktural, bukan trend sementara.
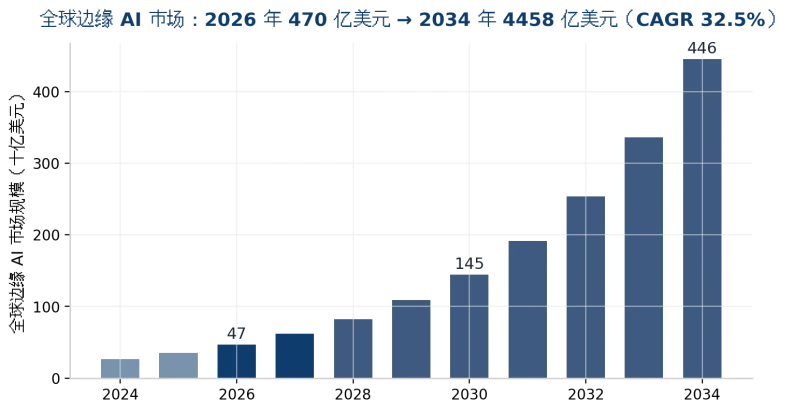
Gartner mengunjurkan bahawa menjelang akhir 2027, 40% organisasi akan menggunakan AI pinggir untuk memproses data sensitif dalam persekitaran operasi mereka — manakala pada 2023 angka ini di bawah 5%. Puncanya ialah penumpuan tekanan ekonomi, peraturan dan teknikal.
Artikel ini menjawab tiga soalan utama: mengapa model kecil tiba-tiba menjadi cukup baik; masalah sebenar apa yang diselesaikan oleh penggunaan AI pinggir; dan perkakasan apa yang diperlukan organisasi pada 2026 untuk menggunakan AI pinggir.
Penumpuan tiga pemacu struktural
Pemacu pertama ialah ekonomi: kos inferens awan sangat berubah-ubah dan sukar diramal. Pemacu kedua ialah peraturan: peraturan seperti GDPR, HIPAA dan undang-undang penyetempatan data China menjadikan penghantaran data sensitif ke infrastruktur awan luaran sukar atau mustahil bagi banyak organisasi. Pemacu ketiga ialah teknikal: model kecil kini boleh melakukan banyak tugas yang dua tahun lalu memerlukan LLM gergasi.
Ketiga-tiga pemacu ini membuka tingkap penggunaan yang bukan sahaja terbuka kepada gergasi teknologi, tetapi juga kepada perniagaan kecil dan sederhana.
Model kecil berbanding model besar: Apa yang sebenarnya berubah
Label «kecil» dalam SLM mengelirukan. Pada 2026, model dengan 7 hingga 14 bilion parameter dianggap «kecil» — tetapi Phi-4 daripada Microsoft, dengan 14 bilion parameter, mencapai ketepatan 94% dalam penanda aras matematik GSM8K, manakala GPT-5 mencapai 87%. Ini bukan pengecualian: dalam domain khusus dengan data berstruktur, model kecil yang ditala secara konsisten mengatasi model umum yang ratusan kali lebih besar.
Sebabnya mudah: latihan khusus domain. Model kecil yang dilatih pada dokumen perubatan, kontrak undang-undang atau laporan penyelenggaraan peralatan lebih tepat daripada model umum besar dalam domain tersebut — kerana kurang hingar yang perlu ditapis.
Untuk penggunaan pinggir, ini bermakna: model cukup kecil untuk berjalan pada Jetson Thor atau komputer industri; respons cukup pantas untuk menyokong aplikasi masa nyata; dan kos setiap inferens hanya satu persepuluh hingga satu per tiga puluh daripada panggilan API awan.
Pada masa yang sama, model kecil bukan untuk semua tujuan. Dalam penaakulan berbilang langkah yang kompleks, penjanaan kandungan panjang dan tugas yang memerlukan pengetahuan umum luas, model besar masih unggul. Itulah sebabnya masa depan ialah hibrid — bukan penggantian.
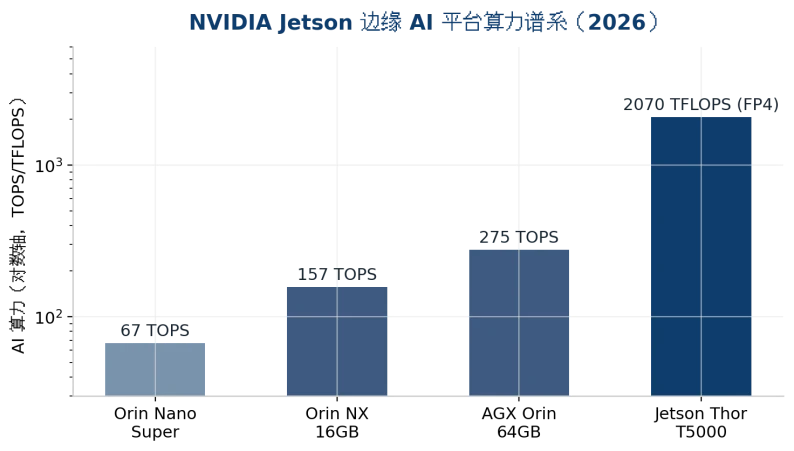
Peringkat perkakasan | Platform wakil | Kuasa (TOPS) | RAM disyorkan | Penggunaan kuasa |
Anggaran harga | Aplikasi utama | Padat / peringkat permulaan | Jetson Orin Nano / NUC | 67 TOPS |
8 hingga 16GB | 15 hingga 30W | 400 hingga 800 dolar | Penderia, kamera | Industri pertengahan |
Jetson AGX Orin / IPC | 157 hingga 275 TOPS | 32 hingga 64GB | 30 hingga 100W | 1,500 hingga 5,000 dolar |
Pemeriksaan visual, robotik | Kelas atas / profesional | Jetson Thor / RTX 5090 | 2070 teraflop FP4 | 48GB ke atas |
300 hingga 700W | 4,699 dolar ke atas | AI fizikal, inferens berat | Perusahaan / pusat data pinggir | RTX 6000 Ada / H100 |
Seni bina hibrid dalam amalan
AI hibrid bermakna model kecil tempatan mengendalikan pengumpulan data, pra-pemprosesan, tugas masa nyata dan respons awal, manakala LLM awan digunakan untuk penaakulan kompleks, carian pengetahuan dan kerja kreatif. Seni bina ini mengekalkan kelebihan kedua-duanya: latensi rendah dan kedaulatan data di pinggir, kuasa pengkomputeran tinggi di awan.
Penyelidikan menunjukkan 80 hingga 95% beban kerja inferens pengeluaran boleh dilakukan oleh model kecil di pinggir, dan hanya 5 hingga 20% yang benar-benar memerlukan model awan besar. AT&T memotong kos inferens 90% dan meningkatkan kelajuan respons 70% melalui penghalaan pintar — hanya menghantar pertanyaan kompleks kepada model besar.
Penggunaan persendirian: kedaulatan data sebagai kelebihan kompetitif
Bagi pembuatan, tenaga, pengangkutan dan perkhidmatan kewangan, penggunaan AI persendirian bukan sekadar keperluan peraturan — ia adalah kelebihan kompetitif. Apabila model berjalan di dalam rangkaian organisasi, data tidak pernah keluar: bukan untuk latihan, bukan untuk pemprosesan. Ini menghapuskan risiko kebocoran data, pelanggaran perjanjian kerahsiaan dan kebergantungan pada vendor.
Dari segi kos juga menarik: penggunaan pinggir dilakukan dengan satu pelaburan perkakasan sahaja dan selepas itu kos setiap inferens hampir sifar — manakala API awan mengenakan bayaran setiap panggilan. Untuk aplikasi yang kerap berulang (pemeriksaan visual, pemantauan peralatan, pemprosesan dokumen), perbezaan kos menjadi jelas dalam beberapa bulan.
Kebangkitan AI fizikal
AI fizikal — iaitu AI yang berjalan pada robot, kenderaan dan peralatan industri — menuntut perkakasan pinggir, kerana keputusan fizikal tidak boleh menunggu perjalanan pergi balik awan. Lengan robotik yang perlu bertindak balas dalam 50 milisaat tidak boleh bergantung pada API awan dengan latensi 200 milisaat.
Di sinilah komputer industri memainkan peranan: tidak seperti komputer riba pengguna, ia dibina untuk beroperasi 24/7 dalam persekitaran lasak — suhu -25 hingga 70 darjah Celsius, tanpa kipas, tahan habuk dan getaran. Ciri-ciri ini bukan pilihan untuk AI fizikal.
Perkakasan AI pinggir: panduan pembelian 2026
ChangFan Industrial Computing menyediakan penyelesaian perkakasan AI pinggir untuk persekitaran pembuatan, tenaga dan pengangkutan.
Soalan utama dalam memilih perkakasan pinggir ialah: model apa yang anda mahu jalankan, dengan kadar inferens berapa?
Untuk model 7 hingga 14 bilion parameter (Phi-4, Mistral, Llama 3.x terkuantum), NVIDIA Jetson AGX Orin (67 TOPS) atau Jetson Thor (157 hingga 275 TOPS) memadai. Untuk inferens lebih berat dengan model 30 hingga 70 bilion parameter, diperlukan stesen kerja dengan GPU pengguna kelas atas (RTX 5090, 2070 teraflop FP4) atau GPU pusat data padat (RTX 6000 Ada, kira-kira 1 petaflop FP4).
RAM penting: model 7 bilion parameter terkuantum memerlukan 8 hingga 16GB, model 14 bilion memerlukan 32 hingga 48GB, dan model 70 bilion terkuantum memerlukan 96GB atau lebih. Memori yang rendah ialah halangan sebenar banyak penggunaan pinggir.
Untuk persekitaran lasak (lantai kilang, luar bangunan, kenderaan), komputer industri tanpa kipas dengan julat suhu lebar (-25 hingga 70 darjah Celsius) dan bekalan kuasa industri adalah wajib. Perkakasan pengguna akan rosak dalam beberapa bulan dalam keadaan ini.
Aplikasi praktikal mengikut industri
Pembuatan: pemeriksaan visual masa nyata pada barisan pengeluaran, penyelenggaraan ramalan dengan analisis getaran dan bunyi, pengoptimuman parameter proses. Kelebihan pinggir: keputusan pemberhentian barisan dalam milisaat, bukan saat.
Tenaga dan infrastruktur: pemantauan peralatan di lokasi terpencil tanpa liputan rangkaian yang boleh dipercayai, pengesanan anomali di pencawang, ramalan kegagalan turbin. Kelebihan pinggir: operasi bebas daripada sambungan internet.