العنوان 1: صعود الذكاء الاصطناعي الطرفي: لماذا تعيد النماذج الصغيرة الحوسبة من السحابة
مقدمة: مركز ثقل الذكاء الاصطناعي ينتقل من السحابة إلى الحافة
على مدى السنوات الثلاث الماضية كان الموقف القياسي للشركات تجاه الذكاء الاصطناعي هو «استدعاء واجهة برمجة تطبيقات سحابية». في عام 2026 يُعاد كتابة هذا الموقف: تتوقع Gartner أن تنتقل 40% من أعباء عمل الذكاء الاصطناعي في المؤسسات بحلول 2027 من النماذج السحابية الكبيرة إلى النماذج اللغوية الصغيرة (SLM)؛ وتُظهر إحصاءات القطاع أن 73% من المؤسسات تنقل الاستدلال إلى بيئات الحافة من أجل كفاءة الطاقة؛ ومن المتوقع أن ينمو سوق الذكاء الاصطناعي الطرفي العالمي من 46.96 مليار دولار في 2026 إلى 445.75 مليار دولار في 2034 بمعدل نمو سنوي مركب قدره 32.5%. مركز ثقل الحوسبة يعود من «قاعات الآلات البعيدة» إلى «حيث تولد البيانات».
ما يدفع هذه الهجرة ليس المزاج بل ثلاثة حسابات: حساب التكلفة (يمكن لاستدلال النماذج الصغيرة أن يخفض التكاليف بنسبة تصل إلى 75%)، وحساب زمن الاستجابة (50–200 ميلي ثانية محليًا، والرحلة السحابية ذهابًا وإيابًا لا تستطيع مجاراته)، وحساب الخصوصية (البيانات لا تغادر المصنع أو المستشفى أو الشبكة الداخلية). الحسابات الثلاثة كلها هي بالضبط أرض الشركات المصنعة للعتاد.
ما الذكاء الاصطناعي الطرفي؟ وبم يختلف جوهريًا عن الذكاء الاصطناعي السحابي؟
إجابة سريعة: الذكاء الاصطناعي الطرفي ينفّذ استدلال النموذج على أجهزة محلية قريبة من المستشعرات والآلات والمستخدمين، بدلًا من إرسال البيانات إلى السحابة وانتظار عودة النتيجة. الفرق الجوهري: البيانات ثابتة لا تتحرك، والذي يتحرك هو النموذج.
«البيانات الثابتة» تجلب ثلاث مزايا هيكلية: أولًا، ينضغط زمن الاستجابة من «رحلة شبكة ذهابًا وإيابًا + طابور» إلى وقت حساب خالص — يمكن للفحص البصري الصناعي للجودة أن ينزل إلى 50 ميلي ثانية؛ ثانيًا، العمل دون اتصال: عربات AGV وعمليات التفتيش الميداني والمنصات البحرية لا «تغبى» عندما تهتزّ الشبكة؛ ثالثًا، تبقى البيانات الحساسة محلية من البداية إلى النهاية، مما يلبي طبيعيًا متطلبات الامتثال في الرعاية الصحية والمالية والقطاع العام. يبقى الذكاء الاصطناعي السحابي مناسبًا للتدريب فائق الحجم والذروات المرنة، لكن «الميل الأخير» للاستدلال يحدث بشكل متزايد عند الحافة.
لماذا تستطيع النماذج الصغيرة (SLM) أن تتولى الدور الرئيسي في 2026؟
إجابة سريعة: لأن النماذج «الكافية» أصبحت أرخص بأكثر من مرتبة واحدة — خدمة نموذج SLM من فئة 7B تكلف أقل بـ10–30 مرة من النماذج الكبيرة من فئة 70B–175B، ويمكن خفض الإنفاق الإجمالي على GPU + السحابة + الطاقة بنسبة تصل إلى 75%، وتحقق بنجاح 80–90% من مهام المؤسسات.
ثلاث حقائق بارزة: Phi-4 من Microsoft بـ14 مليار معامل يقترب من DeepSeek R1 ذي 671 مليارًا في الاستدلال الرياضي؛ نموذج SLM قانوني بـ7 مليارات حقق دقة 94% في مراجعة العقود متجاوزًا GPT-5 بـ87%؛ في مطلع 2026 نقلت AT&T خدمة العملاء الآلية إلى عنقود من نماذج Mistral/Phi المحسّنة، فخفّضت التكاليف الشهرية لواجهة API بنسبة 90% وحسّنت سرعة الاستجابة بنسبة 70%. البنية القياسية للمؤسسات تصبح «هجينة» — يعالج SLM ما بين 80–95% من الطلبات الروتينية، ويُوجَّه الاستدلال المعقد إلى نموذج LLM السحابي. توقع Gartner أكثر مباشرة: بحلول 2027 ستستخدم المؤسسات نماذج صغيرة متخصصة بالمهام بمقدار 3 أضعاف النماذج الكبيرة العامة.
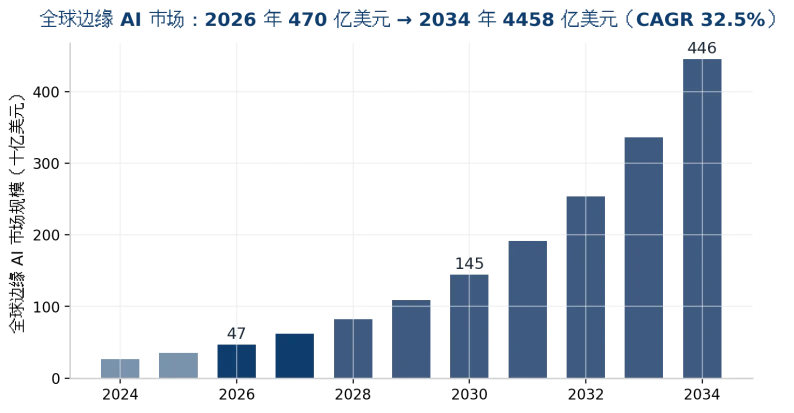
الشكل 1: توقعات سوق الذكاء الاصطناعي الطرفي العالمي (2026–2034، مصادر البيانات في الملحق)
كيف تختار عتاد الذكاء الاصطناعي الطرفي؟
إجابة سريعة: الاختيار وفق محورين — «حجم النموذج + ظروف البيئة»: للرؤية/معالجة اللغة الخفيفة دون 7B وحدات مدمجة من فئة Jetson أو حواسيب صغيرة بمعالج NPU؛ ولـ7B–70B حاسوب صناعي x86 + بطاقة/بطاقتا GPU؛ وللروبوتات البشرية والنماذج الكبيرة متعددة الوسائط منصة من فئة Jetson Thor.
مستوى المنصة | المنصة التمثيلية | القدرة الحسابية للذكاء الاصطناعي | استهلاك الطاقة | السيناريوهات النموذجية |
حافة خفيفة | Jetson Orin Nano Super | 67 TOPS | 7-25 واط | فحص بصري بقناة/قناتين، OCR، كاميرات ذكية |
حافة متوسطة | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 واط | فحص جودة متعدد القنوات، AGV/AMR، رؤية الأذرع الروبوتية |
حافة رائدة | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 واط | روبوتات بشرية، LLM عند الحافة، متعدد الوسائط |
حاسوب صناعي x86 + GPU | حاسوب صناعي + RTX PRO 6000 (96 جيجابايت) | FP4 بفئة بطاقة واحدة | النظام كاملًا 300-700 واط | قاعدة معرفة خاصة بالورشة، استدلال من فئة 70B، أعباء مختلطة رؤية + لغة |
صندوق ذكاء اصطناعي مكتبي | محطة ذكاء اصطناعي بذاكرة موحدة (فئة 128 جيجابايت) | ~1 PFLOP (FP4) | 150-300 واط | تطوير وتصحيح، مساعد خاص على مستوى القسم (سعر مرجعي 4,699 دولارًا) |
الجدول 1: مقارنة مستويات منصات عتاد الذكاء الاصطناعي الطرفي (2026؛ أرقام القدرة الحسابية تستخدم منهجيات مختلفة ولا تُقارن مباشرة بين الصفوف — للمرجع عند الاختيار فقط)
ما يُستهان به بسهولة هو المؤشرات البيئية: الحرارة والغبار والاهتزاز وتقلبات الجهد في الورشة لا تتحملها الأجهزة الاستهلاكية. يجب أن يتحقق الاختيار الصناعي من نطاق الحرارة الواسع (فئة من -25 درجة مئوية إلى 70 درجة مئوية)، والتصميم بلا مروحة/المقاوم للاهتزاز، ومتوسط زمن الأعطال MTBF عند التشغيل المتواصل 7×24، وتطابق واجهات الإدخال/الإخراج (عدة منافذ GbE وPoE وCAN ومنافذ تسلسلية) مع الخط القائم.
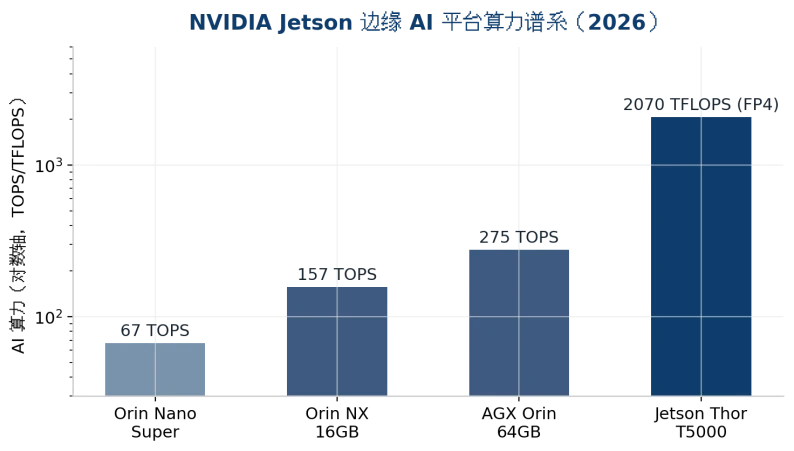
الشكل 2: نطاق قدرة الحوسبة لمنصات Jetson للذكاء الاصطناعي الطرفي (محور لوغاريتمي، 2026)
ما السيناريوهات التي تفرض الذكاء الاصطناعي الطرفي؟
▪فحص الجودة الصناعي والصيانة التنبؤية: إيقاع الخط يُقاس بالميلي ثانية، وعدم خروج صور العيوب من المصنع هو في آن واحد سرعة وسريّة.
▪AGV/AMR والروبوتات: أثناء الحركة تكون الشبكة غير موثوقة؛ يجب أن يتم تفادي العوائق وتخطيط المسار محليًا في الزمن الحقيقي.
▪الرعاية الصحية والمالية: السجلات الطبية والصور وبيانات المعاملات مقيّدة بالامتثال — النشر الخاص هو تذكرة الدخول لا ميزة إضافية.
▪الطاقة والأعمال الميدانية: المنصات البحرية والمناجم وعمليات تفتيش الشبكات الكهربائية تعيش طوال العام بشبكة ضعيفة أو بلا شبكة؛ الذكاء المحلي هو الخيار الوحيد.
▪سلاسل المتاجر والفروع: المقر الرئيسي يوزع النماذج إلى الأسفل، والمتاجر تنفذ الاستدلال محليًا — تكاليف النطاق الترددي وضغط رجوع البيانات ينخفضان معًا.
ChangFan Industrial Computing: عتاد طرفي يضع النماذج الكبيرة في الورش والخزائن
تحقيق الذكاء الاصطناعي الطرفي يعتمد نصفًا على النموذج ونصفًا على «الصندوق الذي يسكن فيه النموذج». تقدم Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) عتاد الحوسبة الطرفية من الخفيف إلى الرائد: حواسيب صناعية مدمجة وصناديق PC بنطاق حرارة واسع ومقاومة للاهتزاز، وأنظمة ذكاء اصطناعي طرفي متكاملة تدعم بطاقة/بطاقتي GPU، وخوادم GPU بمقاس 2U/4U للنشر الخاص على مستوى القسم — متوافقة مع حزم الاستدلال المحلي الرئيسية Ollama وvLLM وOpenWebUI وComfyUI، وقابلة للتخصيص لبيئة الخط: نطاق حرارة واسع، بلا مروحة، منافذ LAN متعددة وPoE.
سواء كنتم تنشرون نموذج فحص جودة بـ7 مليارات أو قاعدة معرفة مؤسسية بـ70 مليارًا، تستطيع ChangFan Industrial Computing اقتراح تكوين كامل وفق «مقياس النموذج × بيئة الموقع». تواصلوا معنا للحصول على استشارة الاختيار (حلول العتاد والأنظمة المتكاملة؛ لا يُقدَّم اشتراك برمجيات).
الأسئلة الشائعة (FAQ)
س1: هل يكفي فعلًا نموذج صغير بـ7 مليارات؟ ج: يكفي لـ80–90% من المهام المتكررة في المؤسسات. بعد التحسين المجالي تحقق نماذج فئة 7B دقة 94% في مهام مثل مراجعة العقود؛ والممارسة الشائعة هي أن يعالج SLM الطلبات الروتينية ويوجه الأسئلة المعقدة إلى النموذج السحابي الكبير.
س2: ما العتاد اللازم لتشغيل نموذج 7B محليًا؟ ج: بعد التكميم نحو 8–16 جيجابايت من ذاكرة الفيديو/الذاكرة — يكفي حاسوب صغير بمعالج NPU أو جهاز من فئة Jetson Orin؛ وللأداء متعدد التزامن يُوصى بحاسوب صناعي ببطاقة GPU من 48 جيجابايت فأكثر.
س3: هل الذكاء الاصطناعي الطرفي والنشر الخاص شيء واحد؟ ج: ليس تمامًا. النشر الخاص يؤكد أن البيانات لا تغادر المؤسسة (وقد تكون على خوادم مركز البيانات)؛ الذكاء الاصطناعي الطرفي يؤكد الحوسبة قرب مصدر البيانات (الورشة، المتجر، الجهاز). ويتداخل الاثنان غالبًا: عقد طرفية + سحابة المؤسسة الخاصة.
س4: ما الفرق بين حاسوب صناعي يشغّل ذكاءً اصطناعيًا وحاسوب استهلاكي؟ ج: نطاق حرارة واسع (فئة من -25 إلى 70 درجة مئوية)، مقاومة الاهتزاز، الحماية من الغبار، تشغيل متواصل 7×24، دورة توريد طويلة، وواجهات صناعية. الحواسيب الاستهلاكية تتعطل بشكل ملحوظ أكثر في بيئات الخطوط — والتكاليف الخفية تتجاوز بكثير فرق السعر.
س5: هل سيُستبدل الذكاء الاصطناعي الطرفي بالنماذج السحابية الكبيرة؟ ج: بيانات السوق تعطي الجواب المعاكس — سوق الذكاء الاصطناعي الطرفي ينمو بمعدل سنوي مركب 32.5%، وأعباء الاستدلال تواصل الهجرة إلى المستوى المحلي. المستقبل لتقسيم العمل «التدريب في السحابة، الاستدلال عند الحافة» لا للاستبدال.