L'essor de l'IA de périphérie : pourquoi les petits modèles ramènent le calcul du cloud vers le local
Introduction : le centre de gravité de l'IA se déplace du cloud vers la périphérie
Ces trois dernières années, la posture standard des entreprises face à l'IA était « appeler une API cloud ». En 2026, cette posture est en train d'être réécrite : Gartner prévoit que d'ici 2027, 40 % des charges de travail IA des entreprises passeront des grands modèles cloud aux petits modèles de langage (SLM) ; les statistiques du secteur montrent que 73 % des organisations déplacent l'inférence vers des environnements de périphérie pour gagner en efficacité énergétique ; et le marché mondial de l'IA de périphérie devrait passer de 46,96 milliards de dollars en 2026 à 445,75 milliards de dollars en 2034, soit un TCAC de 32,5 %. Le centre de gravité du calcul revient des « salles de machines lointaines » vers « l'endroit où naissent les données ».
Ce qui pousse cette migration, ce n'est pas le sentiment mais trois comptes : le compte des coûts (l'inférence des petits modèles peut réduire les coûts jusqu'à 75 %), le compte de la latence (50 à 200 millisecondes en local, l'aller-retour cloud ne peut pas rivaliser) et le compte de la confidentialité (les données ne quittent ni l'usine, ni l'hôpital, ni l'intranet). Ces trois comptes sont précisément le terrain de jeu des fabricants de matériel.
Qu'est-ce que l'IA de périphérie ? Quelle est sa différence fondamentale avec l'IA cloud ?
Réponse rapide : l'IA de périphérie exécute l'inférence des modèles sur des appareils locaux proches des capteurs, des machines et des utilisateurs, au lieu d'envoyer les données vers le cloud et d'attendre le retour des résultats. La différence essentielle : les données ne bougent pas, c'est le modèle qui se déplace.
« Les données ne bougent pas » apporte trois avantages structurels : premièrement, la latence passe d'un « aller-retour réseau + file d'attente » au temps de calcul pur — l'inspection visuelle industrielle peut descendre sous les 50 millisecondes ; deuxièmement, le fonctionnement hors ligne : les AGV, les inspections de terrain et les plateformes offshore ne « perdent pas la tête » en cas de gigue réseau ; troisièmement, les données sensibles restent locales de bout en bout, répondant naturellement aux exigences de conformité de la santé, de la finance et du secteur public. L'IA cloud reste adaptée à l'entraînement à très grande échelle et aux pics élastiques, mais le « dernier kilomètre » de l'inférence se déroule de plus en plus en périphérie.
Pourquoi les petits modèles (SLM) peuvent-ils tenir le haut de l'affiche en 2026 ?
Réponse rapide : parce que les modèles « suffisants » ont vu leur prix chuter de plus d'un ordre de grandeur — servir un SLM de classe 7B coûte 10 à 30 fois moins cher qu'un grand modèle 70B–175B, les dépenses combinées GPU + cloud + énergie peuvent baisser jusqu'à 75 %, et il accomplit 80 à 90 % des tâches d'entreprise.
Trois faits emblématiques : Phi-4 de Microsoft, avec 14B de paramètres, approche le DeepSeek R1 de 671B en raisonnement mathématique ; un SLM juridique de 7B atteint 94 % de précision en revue de contrats, dépassant les 87 % de GPT-5 ; début 2026, AT&T a migré son service client automatisé vers un cluster de modèles Mistral/Phi affinés, réduisant les coûts API mensuels de 90 % et améliorant la vitesse de réponse de 70 %. L'architecture standard des entreprises devient « hybride » — le SLM traite 80 à 95 % des requêtes courantes, le raisonnement complexe est routé vers le LLM cloud. La prédiction de Gartner est encore plus directe : d'ici 2027, les entreprises utiliseront des petits modèles spécialisés par tâche 3 fois plus souvent que les grands modèles généralistes.
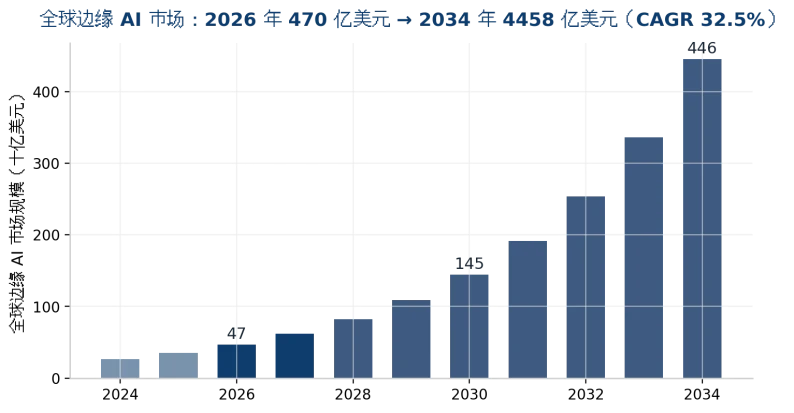
Figure 1 : prévisions du marché mondial de l'IA de périphérie (2026–2034, sources des données en annexe)
Comment choisir le matériel d'IA de périphérie ?
Réponse rapide : sélectionner selon deux axes — « taille du modèle + conditions d'environnement » : pour la vision/NLP légère sous 7B, modules embarqués de classe Jetson ou mini PC à NPU ; pour 7B–70B, PC industriel x86 + un/deux GPU ; pour les robots humanoïdes et les grands modèles multimodaux, plateforme de classe Jetson Thor.
Niveau de plateforme | Plateforme représentative | Puissance de calcul IA | Consommation | Scénarios typiques |
Périphérie légère | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Inspection visuelle mono/bicanal, OCR, caméras intelligentes |
Périphérie milieu de gamme | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Contrôle qualité multicanal, AGV/AMR, vision de bras robotiques |
Périphérie fleuron | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Robots humanoïdes, LLM en périphérie, multimodal |
PC industriel x86 + GPU | PC industriel + RTX PRO 6000 (96 Go) | FP4 de classe mono-carte | Système complet 300-700 W | Base de connaissances privée d'atelier, inférence classe 70B, charges mixtes vision + langage |
Boîtier IA de bureau | Station IA à mémoire unifiée (classe 128 Go) | ~1 PFLOP (FP4) | 150-300 W | Développement et débogage, assistant privé de niveau département (prix de référence 4 699 $) |
Tableau 1 : comparaison par niveau des plateformes matérielles d'IA de périphérie (2026 ; les chiffres de calcul reposent sur des métriques différentes et ne sont pas directement comparables entre lignes — à titre de référence uniquement)
Ce qui est facilement sous-estimé, ce sont les indicateurs environnementaux : température, poussière, vibrations et fluctuations de tension dans l'atelier — les appareils grand public n'y résistent pas. La sélection industrielle doit vérifier la plage de température étendue (classe -25 °C à 70 °C), la conception sans ventilateur/anti-vibration, le MTBF en fonctionnement continu 7×24, et la correspondance des E/S (GbE multiples, PoE, CAN, ports série) avec la ligne existante.
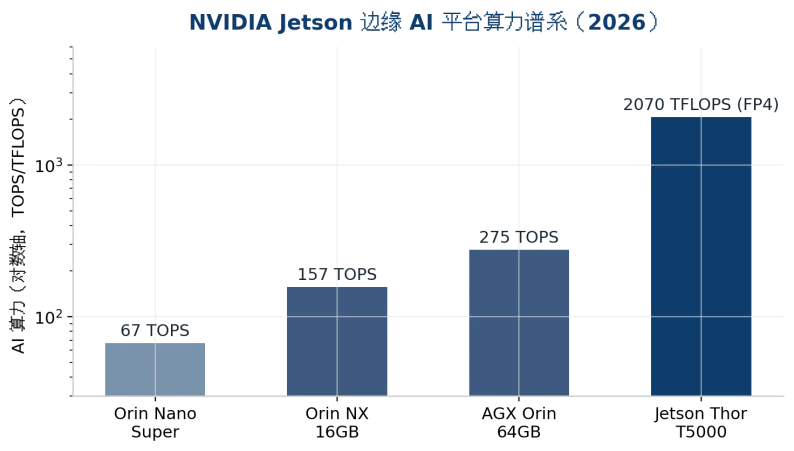
Figure 2 : gamme de puissance de calcul des plateformes Jetson pour l'IA de périphérie (axe logarithmique, 2026)
Quels scénarios imposent l'IA de périphérie ?
▪Contrôle qualité industriel et maintenance prédictive : le takt de la ligne se mesure en millisecondes, et garder les images de défauts dans l'usine relève à la fois de la vitesse et de la confidentialité.
▪AGV/AMR et robotique : en mouvement, le réseau n'est pas fiable ; l'évitement d'obstacles et la planification de trajectoire doivent se faire localement en temps réel.
▪Santé et finance : dossiers médicaux, imagerie et données de transactions sont soumis à la conformité — le déploiement privé est le ticket d'entrée, pas un bonus.
▪Énergie et travaux de terrain : plateformes offshore, mines et inspections de réseaux électriques vivent toute l'année avec un réseau faible ou absent ; l'intelligence locale est la seule option.
▪Chaînes de magasins et succursales : le siège distribue les modèles, les magasins exécutent l'inférence localement — coûts de bande passante et pression de remontée des données baissent ensemble.
ChangFan Industrial Computing : le matériel de périphérie qui installe les grands modèles dans les ateliers et les armoires
La concrétisation de l'IA de périphérie tient pour moitié au modèle et pour moitié au « boîtier qui héberge le modèle ». Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) propose du matériel d'edge computing du léger au fleuron : PC industriels et box PC embarqués à température étendue et résistants aux vibrations, systèmes d'IA de périphérie tout-en-un prenant en charge un/deux GPU, et serveurs GPU 2U/4U pour le déploiement privé au niveau département — compatibles avec les piles d'inférence locales courantes Ollama, vLLM, OpenWebUI et ComfyUI, et personnalisables pour l'environnement de production : température étendue, sans ventilateur, multi-LAN et PoE.
Que vous déployiez un modèle de contrôle qualité 7B ou une base de connaissances d'entreprise 70B, ChangFan Industrial Computing peut proposer une configuration complète selon « taille du modèle × environnement du site ». Contactez-nous pour des conseils de sélection (solutions matérielles et systèmes complets uniquement ; pas d'abonnement logiciel).
Questions fréquentes (FAQ)
Q1 : Un petit modèle 7B est-il vraiment suffisant ? R : Suffisant pour 80 à 90 % des tâches répétitives d'entreprise. Après affinage de domaine, les modèles de classe 7B atteignent 94 % de précision sur des tâches comme la revue de contrats ; la pratique courante est que le SLM traite les requêtes habituelles et route les questions complexes vers le grand modèle cloud.
Q2 : Quel matériel faut-il pour exécuter un modèle 7B en local ? R : Après quantification, environ 8 à 16 Go de VRAM/mémoire — un mini PC avec NPU ou un appareil de classe Jetson Orin suffit ; pour un débit multi-concurrent, un PC industriel avec un GPU de 48 Go ou plus est recommandé.
Q3 : IA de périphérie et déploiement privé, est-ce la même chose ? R : Pas tout à fait. Le déploiement privé insiste sur le fait que les données ne quittent pas l'entreprise (elles peuvent rester sur des serveurs du centre de données) ; l'IA de périphérie insiste sur le calcul au plus près de la source des données (atelier, magasin, appareil). Les deux se combinent souvent : nœuds de périphérie + cloud privé d'entreprise.
Q4 : Quelle différence entre un PC industriel exécutant de l'IA et un ordinateur grand public ? R : Température étendue (classe -25 °C à 70 °C), résistance aux vibrations, protection contre la poussière, fonctionnement continu 7×24, long cycle d'approvisionnement et E/S industrielles. Les machines grand public tombent en panne nettement plus souvent en environnement de production — les coûts cachés dépassent largement l'écart de prix.
Q5 : L'IA de périphérie sera-t-elle remplacée par les grands modèles cloud ? R : Les données du marché répondent le contraire — le marché de l'IA de périphérie croît à un TCAC de 32,5 % et les charges d'inférence migrent vers le local. L'avenir est une répartition du travail « entraînement dans le cloud, inférence en périphérie », et non un remplacement.