Ascensiunea Edge AI: De ce modelele de mici dimensiuni readuc procesarea din cloud
Introducere: centrul de greutate al AI se mută din cloud la margine
În ultimii trei ani, poziția standard a companiilor față de AI era „apelarea unui API cloud”. În 2026, această poziție este rescrisă: Gartner prognozează că până în 2027, 40% din sarcinile de lucru AI ale întreprinderilor vor trece de la modelele mari din cloud la modelele lingvistice mici (SLM); statisticile din industrie arată că 73% dintre organizații mută inferența în medii de margine pentru eficiență energetică; iar piața globală de AI la margine urmează să crească de la 46,96 miliarde USD în 2026 la 445,75 miliarde USD în 2034, cu un CAGR de 32,5%. Centrul de greutate al calculului revine din „sălile de mașini îndepărtate” acolo „unde se nasc datele”.
Această migrație nu este împinsă de dispoziție, ci de trei socoteli: socoteala costurilor (inferența modelelor mici poate reduce costurile cu până la 75%), socoteala latenței (50–200 milisecunde local, drumul dus-întors către cloud nu poate ține pasul) și socoteala confidențialității (datele nu părăsesc fabrica, spitalul, rețeaua internă). Toate cele trei socoteli sunt exact teritoriul de casă al producătorilor de hardware.
Ce este AI-ul la margine? Prin ce diferă fundamental de AI-ul din cloud?
Răspuns scurt: AI-ul la margine execută inferența modelului pe dispozitive locale aproape de senzori, mașini și utilizatori, în loc să trimită datele în cloud și să aștepte rezultatul înapoi. Diferența esențială: datele stau pe loc, modelul se mișcă.
„Datele care stau pe loc” aduc trei avantaje structurale: în primul rând, latența se comprimă de la „drum de rețea dus-întors + coadă” la timpul de calcul pur — inspecția vizuală industrială poate ajunge la 50 de milisecunde; în al doilea rând, funcționarea offline: cărucioarele AGV, inspecțiile de teren și platformele maritime nu „prostesc” când rețeaua tremură; în al treilea rând, datele sensibile rămân locale de la cap la coadă, satisfăcând în mod natural cerințele de conformitate din sănătate, finanțe și sectorul public. AI-ul din cloud rămâne potrivit pentru antrenarea la scară foarte mare și vârfurile elastice, dar „ultima milă” a inferenței are loc tot mai des la margine.
De ce pot modelele mici (SLM) să preia rolul principal în 2026?
Răspuns scurt: pentru că modelele „suficiente” s-au ieftinit cu mai mult de un ordin de mărime — deservirea unui SLM de clasa 7B costă de 10–30 de ori mai puțin decât modelele mari 70B–175B, cheltuielile cumulate pentru GPU + cloud + energie pot scădea cu până la 75%, iar 80–90% din sarcinile de întreprindere le rezolvă cu succes.
Trei fapte emblematice: Phi-4 de la Microsoft, cu 14B parametri, se apropie de DeepSeek R1 cu 671B în raționament matematic; un SLM juridic de 7B a atins 94% acuratețe în revizuirea contractelor, depășind GPT-5 cu 87% al său; la începutul anului 2026, AT&T a migrat serviciul automatizat pentru clienți pe un cluster de modele Mistral/Phi rafinate, reducând costurile lunare API cu 90% și îmbunătățind viteza de răspuns cu 70%. Arhitectura standard a întreprinderilor devine „hibridă” — SLM-ul procesează 80–95% din cererile de rutină, raționamentul complex este rutat către LLM-ul din cloud. Prognoza Gartner este și mai directă: până în 2027, întreprinderile vor folosi modele mici specializate pe sarcini de 3 ori mai mult decât modelele mari universale.
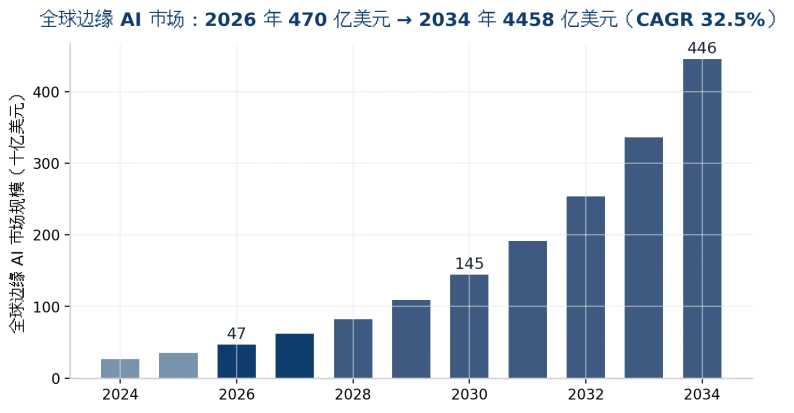
Figura 1: prognoza pieței globale de AI la margine (2026–2034, sursele datelor — în anexă)
Cum se alege hardware-ul pentru AI la margine?
Răspuns scurt: alegerea pe două axe — „dimensiunea modelului + condițiile de mediu”: pentru viziune/NLP ușoară sub 7B, module încorporate de clasa Jetson sau mini PC-uri cu NPU; pentru 7B–70B, PC industrial x86 + unul/două GPU-uri; pentru roboți umanoizi și modele mari multimodale, platformă de clasa Jetson Thor.
Nivel de platformă | Platformă reprezentativă | Putere de calcul AI | Consum de energie | Scenarii tipice |
Margine ușoară | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Inspecție vizuală cu unul/două canale, OCR, camere inteligente |
Margine de gamă medie | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Control al calității multicanal, AGV/AMR, viziune pentru brațe robotice |
Margine emblematică | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Roboți umanoizi, LLM la margine, multimodal |
PC industrial x86 + GPU | PC industrial + RTX PRO 6000 (96 GB) | FP4 de clasă cu o singură placă | Întregul sistem 300-700 W | Bază de cunoștințe privată de atelier, inferență de clasa 70B, sarcini mixte viziune + limbaj |
Cutie AI de birou | Stație AI cu memorie unificată (clasa 128 GB) | ~1 PFLOP (FP4) | 150-300 W | Dezvoltare și depanare, asistent privat la nivel de departament (preț de referință 4 699 USD) |
Tabelul 1: comparație pe niveluri a platformelor hardware pentru AI la margine (2026; cifrele de calcul folosesc metodologii diferite și nu sunt direct comparabile între rânduri — doar ca referință pentru selecție)
Ceea ce este ușor subestimat sunt indicatorii de mediu: temperatura, praful, vibrațiile și fluctuațiile de tensiune din atelier — dispozitivele de consum nu rezistă. Selecția industrială trebuie să verifice intervalul larg de temperatură (clasa -25 °C până la 70 °C), designul fără ventilator/rezistent la vibrații, MTBF la funcționare continuă 7×24 și potrivirea interfețelor I/O (GbE multiple, PoE, CAN, porturi seriale) cu linia existentă.
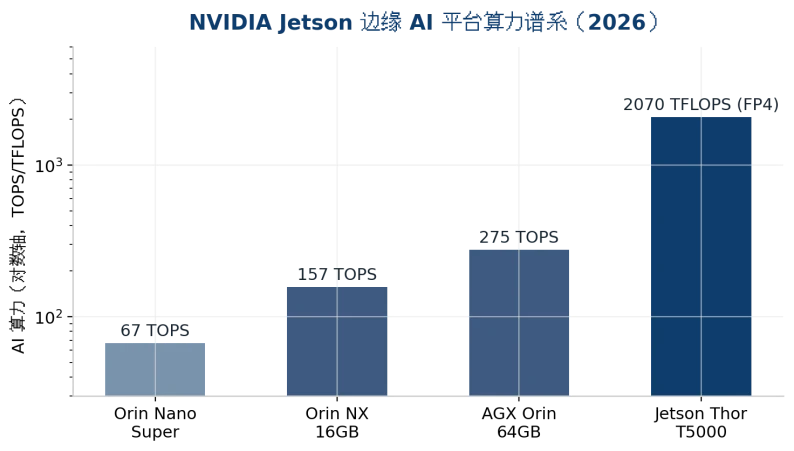
Figura 2: gama de putere de calcul a platformelor Jetson pentru AI la margine (axă logaritmică, 2026)
Ce scenarii impun AI-ul la margine?
▪Controlul calității industriale și mentenanța predictivă: tactul liniei se măsoară în milisecunde, iar păstrarea imaginilor de defecte în interiorul fabricii este în același timp viteză și secret.
▪AGV/AMR și robotică: în mișcare, rețeaua nu este de încredere; evitarea obstacolelor și planificarea traseului trebuie să aibă loc local, în timp real.
▪Sănătate și finanțe: istoricele medicale, imaginile și datele tranzacțiilor sunt legate de conformitate — implementarea privată este biletul de intrare, nu un bonus.
▪Energie și lucrări de teren: platformele maritime, minele și inspecțiile rețelelor electrice trăiesc tot anul cu rețea slabă sau fără rețea; inteligența locală este singura opțiune.
▪Lanțuri de magazine și sucursale: sediul central distribuie modelele în jos, magazinele execută inferența local — costurile de bandă și presiunea returului de date scad simultan.
ChangFan Industrial Computing: hardware de margine care instalează modelele mari în ateliere și dulapuri
Realizarea AI-ului la margine ține pe jumătate de model și pe jumătate de „cutia în care locuiește modelul”. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) oferă hardware de edge computing de la ușor la emblematic: PC-uri industriale și box PC-uri încorporate cu interval larg de temperatură și rezistență la vibrații, sisteme AI de margine all-in-one cu suport pentru unul/două GPU-uri, precum și servere GPU 2U/4U pentru implementare privată la nivel de departament — compatibile cu principalele stive de inferență locală Ollama, vLLM, OpenWebUI, ComfyUI și personalizabile pentru mediul liniei: interval larg de temperatură, fără ventilator, mai multe porturi LAN și PoE.
Fie că implementați un model de control al calității de 7B sau o bază de cunoștințe de întreprindere de 70B, ChangFan Industrial Computing poate propune o configurație completă după formula „scara modelului × mediul locației”. Contactați-ne pentru consultanță de selecție (soluții hardware și sisteme complete; nu se oferă abonament software).
Întrebări frecvente (FAQ)
Î1: Este într-adevăr suficient un model mic de 7B? R: Suficient pentru 80–90% din sarcinile repetitive ale întreprinderilor. După rafinarea de domeniu, modelele de clasa 7B ating 94% acuratețe în sarcini precum revizuirea contractelor; practica curentă este ca SLM-ul să proceseze cererile de rutină și să ruteze întrebările complexe către modelul mare din cloud.
Î2: Ce hardware este necesar pentru a rula local un model de 7B? R: După cuantizare, aproximativ 8–16 GB VRAM/memorie — este suficient un mini PC cu NPU sau un dispozitiv de clasa Jetson Orin; pentru debit multiconcurent se recomandă un PC industrial cu un GPU de la 48 GB în sus.
Î3: AI-ul la margine și implementarea privată sunt același lucru? R: Nu chiar. Implementarea privată subliniază că datele nu părăsesc întreprinderea (pot fi pe serverele centrului de date); AI-ul la margine subliniază calculul aproape de sursa datelor (atelier, magazin, dispozitiv). Cele două se suprapun adesea: noduri de margine + cloudul privat al întreprinderii.
Î4: Cu ce diferă un PC industrial care rulează AI de un computer de consum? R: Interval larg de temperatură (clasa -25 °C până la 70 °C), rezistență la vibrații, protecție la praf, funcționare continuă 7×24, ciclu lung de aprovizionare și interfețe industriale. Computerele de consum se defectează vizibil mai des în mediile de linie — costurile ascunse depășesc cu mult diferența de preț.
Î5: Va fi AI-ul la margine înlocuit de modelele mari din cloud? R: Datele pieței dau răspunsul opus — piața de AI la margine crește cu un CAGR de 32,5%, sarcinile de inferență continuă să migreze la nivel local. Viitorul aparține diviziunii muncii „antrenare în cloud, inferență la margine”, nu înlocuirii unuia cu celălalt.