Cum alegi un server AI? Ghidul complet 2026 de configurare hardware pentru antrenare și inferență
Introducere: de ce alegerea serverului AI a devenit disciplină obligatorie în 2026
Structura cheltuielilor pentru calculul AI se schimbă fundamental. O analiză publicată de McKinsey în februarie 2026 arată că, până în 2030, inferența va depăși antrenarea ca sarcină dominantă în centrele de date AI — cu mai mult de jumătate din tot calculul AI și circa 30–40% din cererea totală a centrelor de date. Pentru companii, logica achiziției de servere trece de la „stivuirea de plăci pentru antrenare” la „rularea inferenței cu control strict al costurilor” — o configurație greșită nu costă o supraplată unică, ci trei ani de facturi zilnice de curent și chirie pentru arhitectura greșită.
În același timp, ritmul de iterare al GPU-urilor a accelerat vizibil: cei 141GB VRAM ai H200 nu s-au așezat bine că deja se desfășoară cei 192GB ai B200 și 288GB ai B300, iar RTX PRO 6000 cu 96GB și format PCIe taie din piața de inferență de clasă medie. Cu cât mai multe modele, cu atât alegerea e mai grea. Acest articol clarifică alegerea serverelor AI în 2026 cu o axă de decizie și două tabele comparative.
Care este, de fapt, diferența dintre un server de antrenare și unul de inferență?
Răspuns scurt: antrenarea este un mega-proiect unic, „intensiv în calcul”; inferența este un serviciu continuu, „intensiv în VRAM și lățime de bandă”. Serverul de antrenare urmărește performanța de vârf a interconexiunii multi-GPU (fabric NVLink/NVSwitch completă, densitate mare de putere, răcire lichidă); serverul de inferență urmărește un debit stabil pe unitate de cost (VRAM care găzduiește modelul, lățime de bandă care livrează tokenuri, consum pe placă sub control, fiabilitate 7×24).
La nivel hardware, clusterele de antrenare preferă mașinile cu 8 GPU în format SXM cu rețea InfiniBand; inferența are un spectru mult mai larg de opțiuni — stații de lucru cu un singur RTX PRO 6000, servere multi-GPU 2U/4U și chiar noduri compacte de inferență la margine. Realitatea din 2026: marea majoritate a bugetelor AI ale companiilor merg spre inferență, așa că serverele trebuie alese după principiul „inferența pe primul loc, antrenarea la cerere”.
De ce contează VRAM mai mult decât puterea de calcul la alegerea unui server AI?
Răspuns scurt: dacă modelul nu încape în VRAM, cele mai mari TFLOPS valorează zero. Dacă un model poate rula depinde de cât VRAM ocupă greutățile + KV Cache + lungimea contextului; abia după ce încape au sens comparațiile de lățime de bandă, suport FP4/FP8 și preț.
Regulă practică (2026): la precizie FP16, un model 70B necesită aproximativ 140GB VRAM — un singur H200 (141GB) îl găzduiește exact, altfel sunt necesare două H100; cuantizarea FP8 reduce la jumătate necesarul; FP4 îl reduce din nou la jumătate, dar numai arhitectura Blackwell (B200/B300/RTX PRO 6000) suportă FP4 nativ. Fiecare dublare a ferestrei de context crește utilizarea KV Cache aproape liniar — de aceea între „încape” și „servește bine” rămâne lățimea de bandă: H200 oferă 4,8 TB/s, B200/B300 oferă 8 TB/s.
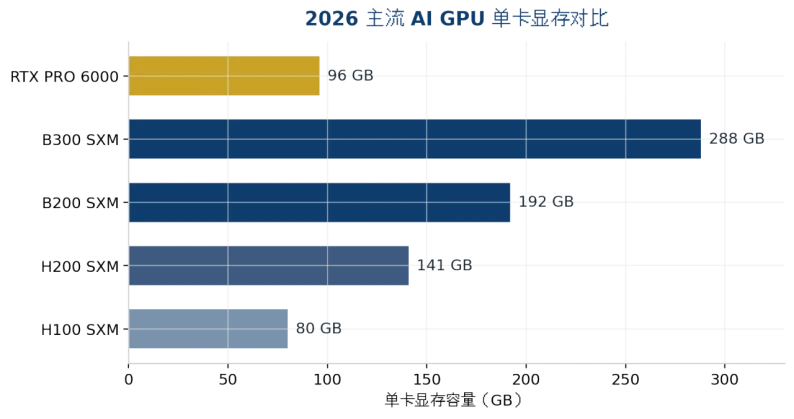
Figura 1: Comparația VRAM pe placă a principalelor GPU AI în 2026 (sursele datelor în anexă)
Cum alegi dintre GPU-urile anului 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Răspuns scurt: pentru modele de până la 141GB, H200 oferă cel mai bun raport calitate-preț; alege B200 când ai nevoie de FP4 sau de mai mult VRAM; alege B300 când o singură placă trebuie să găzduiască un model de peste 200GB sau presiunea KV Cache este mare; alege RTX PRO 6000 pentru inferență de clasă medie și medii PCIe.
Dimensiune | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arhitectură | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Lățime de bandă memorie | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Putere FP4 | Neacceptată | 9 PFLOPS | 15 PFLOPS | Acceptată (clasă single-GPU) |
TDP / răcire | 700W / aer posibil | 1000W / lichid recomandat | ~1400W / lichid practic obligatoriu | 600W / aer |
Poziționare tipică | Inferență 70B–100B, fine-tuning | Inferență 100B+, antrenare | LLM de frontieră pe un singur nod | Inferență clasă medie, stație/margine |
Referință închiriere cloud 2026 | ~$4.4/GPU·h | ~$5–7/GPU·h | ~$7.4–8.3/GPU·h | Predominant achiziție de sisteme complete |
Tabelul 1: Specificații cheie și poziționare a principalelor GPU AI în 2026 (prețurile sunt valori de referință de piață din august 2026, foarte volatile — solicitați o ofertă nouă înainte de achiziție)
Mai există două tendințe ușor de trecut cu vederea: în primul rând, prețul median al închirierii cloud a H200 a crescut cu circa 25% din august 2025, diferența de preț dintre Hopper și Blackwell se îngustează, iar fereastra de „economisire cu generația veche” se închide; în al doilea rând, RTX PRO 6000 are acum o versiune Server de 400W, care permite mai multe plăci în același buget de putere — mai prietenos pentru furnizorii de inferență care facturează pe token.
Cât de mare este modelul, atâta mașină îi trebuie?
Răspuns scurt: estimați pragul inferior de VRAM ca „greutăți model × 1,2 (rezervă pentru KV Cache)”, apoi determinați numărul de GPU cu tabelul de mai jos; modelele care depășesc un singur nod trec la paralelism multi-mașină, unde rețeaua contează mai mult decât GPU-urile.
Model țintă (2026) | Dimensiunea greutăților | Configurație minimă | Format recomandat |
7B–14B (clasa Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 sau placă stație 48GB | Server de inferență edge tower/2U |
32B–70B (cuantizare FP8) | 40–80GB | RTX PRO 6000 ×1–2 sau H200 ×1 | Server GPU 2U/4U |
70B FP16 / context lung | ~140GB+ | H200 ×1 (la limită) sau ×2 (sigur) | Server multi-GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (rezervă ~130GB) | Server 4U cu răcire lichidă |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 sau B300 ×4 | Sistem SXM cu 8 GPU |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB VRAM total) | Sistem flagship cu 8 GPU și răcire lichidă |
Tabelul 2: Dimensiunea modelului versus configurația serverului (greutăți conform checkpointurilor oficiale; la implementarea reală trebuie adăugate KV Cache și supraîncărcarea runtime)
Acest tabel explică și de ce șasiul 4U este „punctul optim” al serverelor AI: 8 GPU dual-width, surse redundante și canale de aer de răcire suficiente — doar spațiul de 4U le găzduiește pe toate simultan. 2U se potrivește nodurilor de inferență cu 2–4 plăci; 1U încape o singură placă sau servește ca nod frontal de planificare/stocare.
Răcire cu aer sau cu lichid? Cum se stabilesc specificațiile termice și de rack?
Răspuns scurt: sub 700W pe placă, aerul este suficient; peste 1000W pe placă — sau peste 20kW pe rack — răcirea lichidă trece de la „bonus” la „cerință strictă”. TDP-ul de ~1400W al B300 blochează practic răcirea lichidă ca soluție unică.
Ordinea corectă de selecție este: întâi modelul și GPU-ul, apoi puterea totală a mașinii și abia la final calculul invers al răcirii și condițiilor sălii. Multe companii fac invers — cumpără mai întâi mașinile și descoperă apoi că alimentarea și climatizarea nu fac față, fiind nevoite să reducă frecvența: ca și cum ai plăti preț întreg pentru un GPU „castrat”. Înainte de achiziție, confirmați trei lucruri: alimentarea rackului (kW), temperatura și volumul aerului de admisie și rezerva pentru următoarele 2–3 generații de GPU (după B300, TDP-urile nu fac decât să crească).
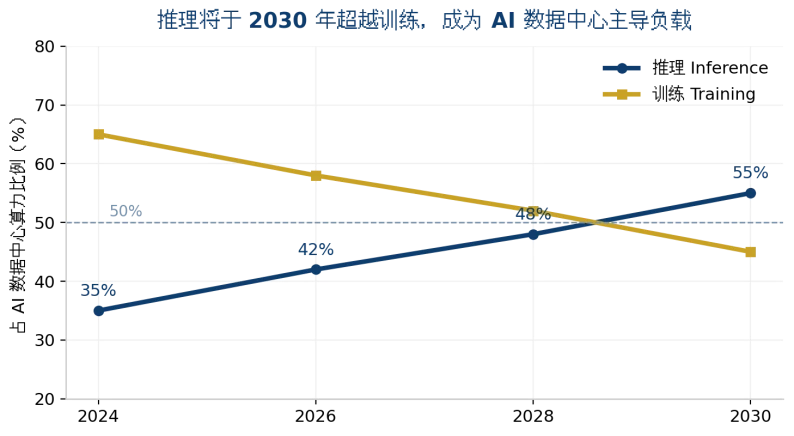
Figura 2: Inferența va depăși antrenarea ca sarcină dominantă a centrelor de date AI până în 2030 (ilustrație de trend; sursele datelor în anexă)
Închiriere cloud sau construcție proprie? Cum faci calculele?
Răspuns scurt: sub 60% utilizare, închirierea cloud e mai avantajoasă; la sarcini ridicate și susținute, construcția proprie. La prețurile din august 2026, închirierea cloud a unui H200 costă circa 4,4 /GPU·oră — aproximativ 38.000 pentru un an întreg la sarcină maximă, aproape de costul achiziției unei plăci. Cu cât utilizarea e mai mare, cu atât construcția proprie se amortizează mai repede.
La calculul construcției proprii se mai adaugă trei poziții: curentul și operarea răcirii (circa 20–30% din costul total de proprietate), deprecierea prin generațiile de GPU (în 2026, H100 este deja puternic devalorizată — riscul valorii reziduale este real) și conformitatea datelor: pentru clienții din finanțe, sănătate și administrație publică, datele nu părăsesc intranetul, deci implementarea privată nu este o opțiune, ci o obligație. Arhitectura hibridă devine mainstream: antrenare de vârf în cloud, inferență permanentă local.
ChangFan: servere GPU și hardware AI pregătite pentru era inferenței
În cele din urmă, alegerea serverului AI nu se câștigă pe fișele de specificații, ci pe potrivirea dintre configurație și scenariu. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) oferă servere GPU rack și sisteme de inferență AI în formatele 1U/2U/4U, cu extindere multi-GPU, surse redundante și design pentru temperaturi extinse. Numărul de GPU, configurația VRAM și răcirea (aer/lichid) se personalizează în funcție de dimensiunea modelului țintă — o bază hardware stabilă și fiabilă pentru implementarea privată de LLM, noduri de inferență la margine și baze de cunoștințe de întreprindere.
Dacă evaluați achiziția și implementarea de servere GPU din clasa H200/B200/B300 sau RTX PRO 6000, contactați ChangFan pentru consultanță de configurare și oferte de sisteme complete adaptate modelului dvs. țintă (vindem hardware și construim sisteme complete — nu oferim servicii de abonament software).
Întrebări frecvente (FAQ)
Î1: Care este configurația minimă pentru a rula un LLM de 70B? R: La FP16 aveți nevoie de aproximativ 140GB VRAM, deci un singur H200 este răspunsul cel mai economic; după cuantizarea FP8, două plăci RTX PRO 6000 (96GB×2) rezolvă și ele sarcina, mai ieftin și mai flexibil la implementare.
Î2: Cu ce este B300 mai bună decât B200 și merită așteptarea? R: B300 oferă cu 50% mai mult VRAM (288GB față de 192GB) și de 1,5× puterea FP4, dar aceeași lățime de bandă și un TDP crescut la ~1400W care necesită răcire lichidă. Merita upgrade-ul abia când modelul sau KV Cache depășesc capacitatea unui nod cu B200.
Î3: Cu ce ar trebui să înceapă un IMM la achiziția primului server AI? R: Definiți mai întâi modelul care va rula. Pentru aplicații 7B–14B (servicii clienți, baze de cunoștințe, control calitate), un server de inferență 2U cu o singură placă ajunge pentru start; extindeți la 4U multi-GPU după confirmarea unei sarcini ridicate susținute.
Î4: Este răcirea lichidă obligatorie pentru serverele AI? R: Nu. Sub 700W pe placă și cu o sală în condiții bune, aerul ajunge; lichidul este necesar abia peste 1000W pe placă sau în instalări dense multi-rack. La selecție, lăsați rezervă pentru tendința de consum a următoarelor 2–3 generații de GPU.
Î5: GPU-urile cloud sunt atât de ieftine — de ce să cumperi un server propriu? R: Trei motive — peste ~60% utilizare, construcția proprie costă mai puțin; datele sensibile nu pot părăsi intranetul; inferența locală nu are latență de rețea, iar SLA-ul este sub control propriu. Majoritatea companiilor ajung la arhitectura hibridă „antrenare în cloud, inferență local”.