Bagaimana Memilih Pelayan AI? Panduan Lengkap Konfigurasi Perkakasan Latihan dan Inferens 2026
Pengenalan: Mengapa Pemilihan Pelayan AI Menjadi Pelajaran Wajib Tahun 2026
Struktur perbelanjaan pengkomputeran AI sedang berubah secara mendasar. Analisis yang diterbitkan McKinsey pada Februari 2026 menunjukkan bahawa menjelang 2030, inferens (inference) akan mengatasi latihan menjadi beban dominan pusat data AI, merangkumi lebih daripada separuh keseluruhan pengkomputeran AI dan kira-kira 30%–40% daripada jumlah permintaan pusat data. Ini bermakna logik keputusan perolehan pelayan perusahaan sedang beralih daripada "menyusun kad untuk latihan" kepada "mengira teliti untuk menjalankan inferens" — salah pilih konfigurasi, harganya bukan sekadar beli mahal sekali, tetapi membayar elektrik dan sewa untuk seni bina yang salah setiap hari selama tiga tahun akan datang.
Pada masa yang sama, rentak iterasi produk GPU jelas semakin pantas: VRAM 141GB H200 belum sempat "panas", B200 192GB dan B300 288GB sudah dilancarkan, manakala RTX PRO 6000 dengan VRAM 96GB dan bentuk PCIe memotong pasaran inferens pertengahan. Semakin banyak model, pemilihan semakin sukar. Artikel ini menggunakan satu paksi keputusan dan dua jadual perbandingan untuk menjelaskan pemilihan pelayan AI 2026 dengan jelas.
Apakah sebenarnya perbezaan antara pelayan latihan dan pelayan inferens?
Jawapan ringkas: latihan ialah projek satu kali yang "intensif pengkomputeran", manakala inferens ialah perkhidmatan berterusan yang "intensif VRAM dan lebar jalur". Pelayan latihan mengejar pengkomputeran puncak sambungan berbilang kad (sambungan penuh NVLink/NVSwitch, ketumpatan kuasa tinggi, penyejukan cecair); pelayan inferens mengejar daya pemprosesan stabil pada kos seunit (VRAM mampu memuatkan model, lebar jalur mampu mengeluarkan token, penggunaan kuasa satu kad terkawal, boleh dipercayai 7×24).
Dari segi perkakasan, kluster latihan mengutamakan mesin lengkap 8 kad bentuk SXM dan rangkaian IB; penyebaran inferens mempunyai pilihan lebih luas — stesen kerja satu kad RTX PRO 6000, pelayan berbilang kad 2U/4U, malah nod inferens kecil di pinggir. Realiti 2026: kebanyakan belanjawan AI perusahaan dibelanjakan untuk inferens, jadi pemilihan pelayan juga harus "utamakan inferens, latihan mengikut keperluan".
Memilih pelayan AI, mengapa VRAM lebih penting daripada kuasa pengkomputeran?
Jawapan ringkas: jika model tidak muat dalam VRAM, TFLOPS setinggi mana pun bernilai sifar. Sama ada sesuatu model boleh berjalan bergantung pada berapa banyak VRAM yang digunakan oleh pemberat + KV Cache + panjang konteks; hanya selepas ia termuat, lebar jalur, sokongan FP4/FP8 dan harga baharu bermakna untuk dibandingkan.
Peraturan praktikal (2026): pada ketepatan FP16, model 70B memerlukan kira-kira 140GB VRAM — satu H200 (141GB) muat dengan tepat, jika tidak perlukan dua H100; selepas pengkuantitan FP8 keperluan berkurang separuh; FP4 berkurang separuh lagi, tetapi hanya seni bina Blackwell (B200/B300/RTX PRO 6000) menyokong FP4 secara asli. Setiap kali tetingkap konteks dipanjangkan dua kali ganda, penggunaan KV Cache meningkat hampir linear — itulah sebabnya antara "boleh muat" dan "boleh berkhidmat dengan baik" masih ada jurang lebar jalur: H200 ialah 4.8 TB/s, B200/B300 ialah 8 TB/s.
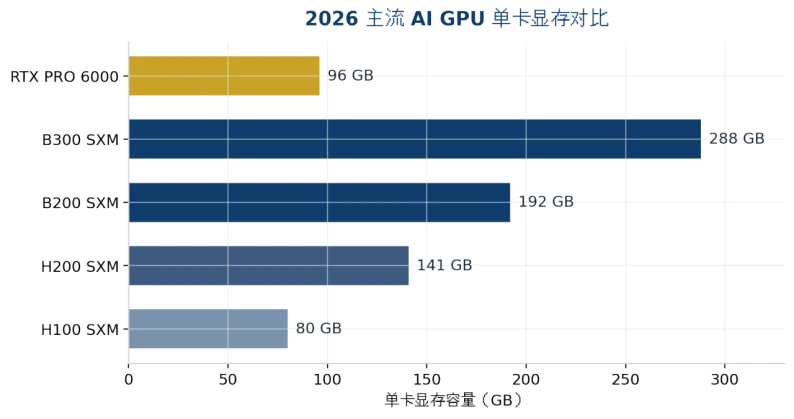
Rajah 1: Perbandingan VRAM setiap kad GPU AI arus perdana 2026 (sumber data lihat lampiran)
Bagaimana memilih GPU arus perdana 2026: perbandingan H200, B200, B300, RTX PRO 6000
Jawapan ringkas: model dalam lingkungan 141GB pilih H200 paling menjimatkan; perlukan FP4 atau VRAM lebih besar pilih B200; satu kad perlu memuatkan model melebihi 200GB atau tekanan KV Cache besar pilih B300; inferens pertengahan dan persekitaran PCIe pilih RTX PRO 6000.
Dimensi | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Seni bina | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Lebar jalur memori | 4.8 TB/s | 8 TB/s | 8 TB/s | Kira-kira 1.8 TB/s |
Pengkomputeran FP4 | Tidak disokong | 9 PFLOPS | 15 PFLOPS | Disokong (peringkat satu kad) |
TDP / Penyejukan | 700W / penyejukan udara boleh dilaksanakan | 1000W / disyorkan penyejukan cecair | Kira-kira 1400W / pada asasnya memerlukan penyejukan cecair | 600W / penyejukan udara |
Kedudukan tipikal | Inferens 70B–100B, penalaan halus | Inferens 100B+, latihan | Menampung model besar sempadan dalam satu mesin | Inferens pertengahan, stesen kerja/pinggir |
Rujukan sewa awan 2026 | Kira-kira $4.4/GPU·jam | Kira-kira $5–7/GPU·jam | Kira-kira $7.4–8.3/GPU·jam | Terutamanya pembelian mesin lengkap |
Jadual 1: Perbandingan spesifikasi utama dan kedudukan GPU AI arus perdana 2026 (harga ialah nilai rujukan pasaran Ogos 2026, sangat turun naik, perlu minta sebut harga semula sebelum perolehan)
Terdapat dua lagi trend yang mudah diabaikan: pertama, harga sewa awan median H200 telah meningkat kira-kira 25% sejak Ogos 2025, jurang harga Hopper dan Blackwell semakin mengecil, tetingkap "beli model lama untuk berjimat" sedang tertutup; kedua, RTX PRO 6000 melancarkan versi Server 400W — dengan belanjawan kuasa yang sama lebih banyak kad boleh dipasang, lebih mesra kepada penyedia perkhidmatan inferens yang mengenakan bayaran mengikut token.
Model sebesar mana, mesin dikonfigurasi sebagaimana?
Jawapan ringkas: anggar had bawah VRAM dengan "pemberat model × 1.2 (memperuntukkan ruang KV Cache)", kemudian bandingkan jadual di bawah untuk menentukan bilangan GPU; model yang melebihi satu nod masuk ke pemprosesan selari berbilang mesin, di mana rangkaian lebih penting daripada GPU.
Model sasaran (2026) | Saiz pemberat | Konfigurasi minimum | Bentuk mesin yang disyorkan |
7B–14B (peringkat Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 atau kad stesen kerja 48GB | Pelayan inferens pinggir menara/2U |
32B–70B (pengkuantitan FP8) | 40–80GB | RTX PRO 6000 ×1–2 atau H200 ×1 | Pelayan GPU 2U/4U |
70B FP16 / konteks panjang | Kira-kira 140GB+ | H200 ×1 (cukup-cukup) atau ×2 (lebih selamat) | Pelayan berbilang kad 4U |
DeepSeek V4 Flash (156GB) | Kira-kira 156GB | B300 ×1 (lebihan kira-kira 130GB) | Pelayan penyejukan cecair 4U |
GLM-5.2 FP8 (kira-kira 756GB) | Kira-kira 756GB | H200 ×8 atau B300 ×4 | Mesin SXM 8 kad |
Kimi K3 (1.56TB MXFP4) | Kira-kira 1.56TB | B300 ×8 (jumlah VRAM 2.3TB) | Mesin utama penyejukan cecair 8 kad |
Jadual 2: Jadual perbandingan skala model dan konfigurasi pelayan (pemberat mengikut checkpoint rasmi, penyebaran sebenar perlu menambah KV Cache dan overhed runtime)
Jadual ini juga menjelaskan mengapa casis 4U ialah "spesifikasi titik manis" pelayan AI: 8 GPU dua slot, bekalan kuasa berlebihan dan saluran udara penyejukan yang mencukupi hanya dapat ditampung oleh ruang 4U serentak. 2U sesuai untuk nod inferens 2–4 kad, manakala 1U hanya sesuai untuk satu kad atau sebagai nod penjadual/penyimpanan hadapan.
Penyejukan udara atau cecair? Bagaimana menentukan spesifikasi penyejukan dan rak?
Jawapan ringkas: satu kad di bawah 700W penyejukan udara memadai; satu kad melebihi 1000W, atau kuasa satu kabinet melebihi 20kW, penyejukan cecair berubah daripada "kelebihan tambahan" kepada "ambang mandatori". TDP kira-kira 1400W B300 pada asasnya mengunci penyelesaian penyejukan cecair.
Urutan pemilihan yang betul: tentukan model dan GPU dahulu, kemudian kuasa keseluruhan mesin, akhir sekali kira songsang penyejukan dan keadaan bilik pelayan. Banyak perusahaan melakukannya secara terbalik — membeli mesin dahulu, kemudian baharu menyedari bekalan elektrik dan penyaman udara bilik pelayan tidak mampu menampung, terpaksa beroperasi dengan frekuensi diturunkan, bersamaan membayar untuk GPU yang "tidak berkuasa penuh". Sebelum perolehan pastikan tiga perkara: bekalan kuasa kabinet (kW), suhu dan isipadu udara masuk, serta ruang naik taraf untuk 2–3 generasi GPU akan datang (selepas B300, TDP hanya akan lebih tinggi).
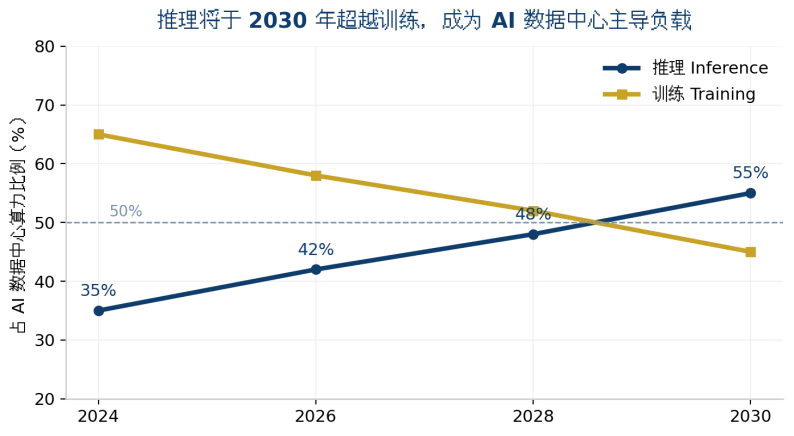
Rajah 2: Inferens akan mengatasi latihan menjadi beban dominan pusat data AI menjelang 2030 (ilustrasi trend, sumber data lihat lampiran)
Sewa awan atau bina sendiri? Bagaimana mengira kos?
Jawapan ringkas: penggunaan di bawah 60% pilih sewa awan, beban tinggi jangka panjang pilih bina sendiri. Berdasarkan harga pasaran Ogos 2026, sewa awan H200 kira-kira 4.4/GPU·jam, satu kad beroperasi penuh sepanjang tahun menelan kos sewa kira-kira38,000 — hampir menyamai kos membeli satu kad sendiri; apabila penggunaan tinggi, membina sendiri akan pulang modal.
Pihak bina sendiri masih perlu menambah tiga perkara: elektrik bilik pelayan dan penyelenggaraan penyejukan (kira-kira 20%–30% daripada jumlah kos pemilikan), susut nilai iterasi GPU (pada 2026 H100 sudah didiskaun mendalam, risiko nilai sisa memang wujud), serta pematuhan data — data pelanggan kewangan, perubatan dan kerajaan tidak boleh keluar daripada rangkaian dalaman, penyebaran persendirian bukan soal pilihan tetapi kewajipan. Seni bina hibrid sedang menjadi arus perdana: latihan puncak di awan, inferens kekal di tempat sendiri.
ChangFan Industrial Computing: Pelayan GPU dan Perkakasan AI yang Sedia untuk Era Inferens
Pemilihan pelayan AI pada akhirnya bukan pertandingan jadual parameter, tetapi "tahap kesepadanan konfigurasi dengan senario". Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) menyediakan pelayan GPU jenis rak dan mesin inferens AI merangkumi 1U/2U/4U, menyokong pengembangan berbilang kad, bekalan kuasa berlebihan dan reka bentuk suhu luas, serta boleh menyesuaikan bilangan GPU, konfigurasi VRAM dan penyelesaian penyejukan udara/cecair mengikut skala model sasaran — menyampaikan asas perkakasan yang stabil dan boleh dipercayai untuk senario seperti penyebaran model besar persendirian, nod inferens pinggir dan pangkalan pengetahuan perusahaan.
Jika anda sedang menilai perolehan dan penyebaran pelayan GPU kelas H200/B200/B300 atau RTX PRO 6000, sila hubungi ChangFan Industrial Computing untuk mendapatkan cadangan konfigurasi dan penyelesaian mesin lengkap untuk model sasaran anda (kami menjual perkakasan dan menghasilkan mesin lengkap, tidak menyediakan perkhidmatan langganan perisian).
Soalan Lazim (FAQ)
S1: Apakah konfigurasi minimum untuk menjalankan model besar 70B? J: FP16 memerlukan kira-kira 140GB VRAM, satu H200 ialah jawapan paling ekonomi; selepas pengkuantitan FP8, dua RTX PRO 6000 (96GB×2) juga berupaya, dengan kos lebih rendah dan penyebaran lebih fleksibel.
S2: Di manakah kekuatan B300 berbanding B200, berbaloi untuk ditunggu? J: B300 mempunyai VRAM 50% lebih banyak (288GB berbanding 192GB), pengkomputeran FP4 1.5 kali lebih tinggi, tetapi lebar jalur sama dan TDP meningkat kepada kira-kira 1400W memerlukan penyejukan cecair. Hanya berbaloi dinaik taraf apabila model atau KV Cache melebihi kapasiti nod B200.
S3: PKS membeli pelayan AI buat kali pertama, apa yang disyorkan untuk bermula? J: tentukan dahulu model yang hendak dijalankan. Aplikasi peringkat 7B–14B (khidmat pelanggan, pangkalan pengetahuan, pemeriksaan kualiti) boleh bermula dengan satu pelayan inferens 2U satu kad; selepas disahkan beban tinggi jangka panjang baharulah dikembangkan kepada 4U berbilang kad.
S4: Adakah pelayan AI mesti menggunakan penyejukan cecair? J: tidak. Senario satu kad di bawah 700W dengan keadaan bilik pelayan yang baik memadai dengan penyejukan udara; satu kad melebihi 1000W atau penyebaran berbilang kabinet berketumpatan tinggi baharu memerlukan penyejukan cecair. Semasa pemilihan, peruntukkan margin mengikut trend penggunaan kuasa 2–3 generasi GPU akan datang.
S5: GPU awan semurah ini, mengapa masih perlu membeli pelayan sendiri? J: tiga sebab — apabila penggunaan melebihi kira-kira 60%, membina sendiri lebih murah; data sensitif tidak dibenarkan keluar rangkaian dalaman; inferens tempatan tiada kependaman rangkaian dan SLA boleh dikawal sendiri. Kebanyakan perusahaan akhirnya mengguna pakai seni bina hibrid "latihan di awan, inferens di tempat sendiri".