Come scegliere un server AI? La guida completa 2026 alla configurazione hardware per training e inferenza
Introduzione: perché la scelta del server AI è diventata materia obbligatoria nel 2026
La struttura della spesa per il calcolo AI sta cambiando radicalmente. Un'analisi pubblicata da McKinsey a febbraio 2026 indica che entro il 2030 l'inferenza supererà il training come carico dominante nei data center AI, coprendo più della metà di tutto il calcolo AI e circa il 30%–40% della domanda totale dei data center. Per le imprese, la logica di acquisto dei server passa da «accumulare schede per il training» a «far girare l'inferenza con costi misurati»: sbagliare configurazione non costa un sovrapprezzo una tantum, ma tre anni di bollette elettriche e affitti pagati ogni giorno per l'architettura sbagliata.
Allo stesso tempo, il ritmo di evoluzione delle GPU è nettamente accelerato: i 141GB di VRAM della H200 non si erano ancora assestati che già si diffondono i 192GB della B200 e i 288GB della B300, mentre la RTX PRO 6000 conquista il mercato dell'inferenza di fascia media con 96GB e formato PCIe. Più modelli ci sono, più la scelta si complica. Questo articolo chiarisce la selezione dei server AI nel 2026 con un asse decisionale e due tabelle comparative.
Qual è esattamente la differenza tra un server di training e un server di inferenza?
Risposta rapida: il training è un mega-progetto una tantum «intensivo in calcolo», l'inferenza un servizio continuativo «intensivo in VRAM e banda». Il server di training insegue la potenza di picco dell'interconnessione multi-GPU (fabric NVLink/NVSwitch completa, alta densità di potenza, raffreddamento a liquido); il server di inferenza insegue un throughput stabile per unità di costo (VRAM che ospita il modello, banda che eroga token, consumo per scheda controllato, affidabilità 7×24).
Sul piano hardware, i cluster di training privilegiano macchine a 8 GPU in formato SXM con rete InfiniBand; per l'inferenza le opzioni sono molto più ampie: workstation single-GPU con RTX PRO 6000, server multi-GPU 2U/4U, fino a piccoli nodi di inferenza all'edge. La realtà del 2026: la stragrande maggioranza dei budget AI delle imprese va all'inferenza, quindi la selezione dei server deve seguire il principio «inferenza prima di tutto, training su richiesta».
Perché la VRAM conta più della potenza di calcolo nella scelta di un server AI?
Risposta rapida: se il modello non entra nella VRAM, anche i TFLOPS più alti valgono zero. La possibilità di eseguire un modello dipende da quanta VRAM occupano pesi + KV Cache + lunghezza del contesto; solo quando il modello è ospitato hanno senso i confronti su banda, supporto FP4/FP8 e prezzo.
Regola pratica (2026): in precisione FP16, un modello 70B richiede circa 140GB di VRAM — una singola H200 (141GB) lo contiene esattamente, altrimenti servono due H100; la quantizzazione FP8 dimezza il fabbisogno; FP4 lo dimezza di nuovo, ma solo l'architettura Blackwell (B200/B300/RTX PRO 6000) supporta FP4 nativamente. Ogni raddoppio della finestra di contesto fa crescere il KV Cache quasi linearmente — ecco perché tra «ci sta» e «serve bene» resta la banda: la H200 offre 4,8 TB/s, le B200/B300 offrono 8 TB/s.
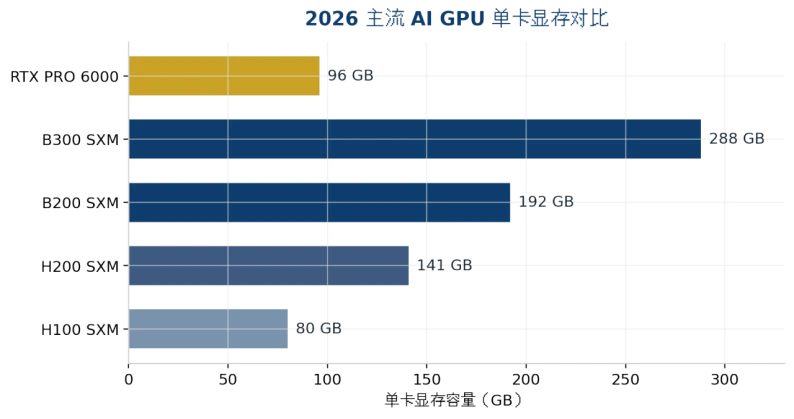
Figura 1: Confronto della VRAM per scheda delle principali GPU AI nel 2026 (fonti dei dati in appendice)
Come scegliere tra le GPU del 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Risposta rapida: per modelli entro 141GB, la H200 offre il miglior rapporto qualità-prezzo; scegliete la B200 se servono FP4 o più VRAM; scegliete la B300 se una singola scheda deve ospitare un modello oltre 200GB o la pressione del KV Cache è elevata; scegliete la RTX PRO 6000 per l'inferenza di fascia media e gli ambienti PCIe.
Dimensione | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architettura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Larghezza di banda memoria | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Potenza FP4 | Non supportata | 9 PFLOPS | 15 PFLOPS | Supportata (classe single-GPU) |
TDP / raffreddamento | 700W / aria possibile | 1000W / liquido consigliato | ~1400W / liquido praticamente obbligatorio | 600W / aria |
Posizionamento tipico | Inferenza 70B–100B, fine-tuning | Inferenza 100B+, training | LLM di frontiera su un solo nodo | Inferenza fascia media, workstation/edge |
Riferimento noleggio cloud 2026 | ~$4.4/GPU·h | ~$5–7/GPU·h | ~$7.4–8.3/GPU·h | Acquisto di sistemi completi soprattutto |
Tabella 1: Specifiche chiave e posizionamento delle principali GPU AI nel 2026 (prezzi di riferimento di mercato di agosto 2026, molto volatili — richiedere un preventivo aggiornato prima dell'acquisto)
Ci sono poi due tendenze facili da trascurare: primo, il prezzo mediano del noleggio cloud della H200 è cresciuto di circa il 25% da agosto 2025, il divario di prezzo tra Hopper e Blackwell si sta riducendo e la finestra «risparmiare con la vecchia generazione» si sta chiudendo; secondo, la RTX PRO 6000 è ora disponibile in versione Server da 400W, che permette di installare più schede a parità di budget energetico — più conveniente per i fornitori di inferenza che fatturano a token.
Quanto è grande il modello, quanta macchina serve?
Risposta rapida: stimate il limite inferiore di VRAM come «pesi del modello × 1,2 (margine per il KV Cache)», poi determinate il numero di GPU con la tabella seguente; i modelli che superano un singolo nodo passano al parallelismo multi-macchina, dove la rete conta più delle GPU.
Modello obiettivo (2026) | Dimensione dei pesi | Configurazione minima | Formato consigliato |
7B–14B (classe Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 o scheda workstation 48GB | Server di inferenza edge tower/2U |
32B–70B (quantizzazione FP8) | 40–80GB | RTX PRO 6000 ×1–2 o H200 ×1 | Server GPU 2U/4U |
70B FP16 / contesto lungo | ~140GB+ | H200 ×1 (stretto) o ×2 (sicuro) | Server multi-GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (margine ~130GB) | Server 4U con raffreddamento a liquido |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 o B300 ×4 | Sistema SXM a 8 GPU |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB di VRAM totale) | Sistema flagship a 8 GPU con raffreddamento a liquido |
Tabella 2: Corrispondenza tra dimensione del modello e configurazione del server (pesi secondo i checkpoint ufficiali; nel deployment reale aggiungere KV Cache e overhead di runtime)
Questa tabella spiega anche perché il telaio 4U è il «punto ottimale» dei server AI: 8 GPU dual-width, alimentatori ridondanti e un flusso d'aria di raffreddamento adeguato trovano posto contemporaneamente solo in un 4U. Il 2U è adatto a nodi di inferenza da 2–4 schede; l'1U accetta una sola scheda o funge da nodo frontale di scheduling/archiviazione.
Raffreddamento ad aria o a liquido? Come definire le specifiche termiche e di rack?
Risposta rapida: sotto i 700W per scheda l'aria è sufficiente; oltre i 1000W per scheda — o oltre 20kW per armadio — il raffreddamento a liquido passa da «plus» a «requisito vincolante». Il TDP di ~1400W della B300 impone di fatto il raffreddamento a liquido.
La sequenza di selezione corretta è: prima il modello e la GPU, poi la potenza totale della macchina, infine il calcolo a ritroso di raffreddamento e condizioni della sala. Molte aziende fanno il contrario: comprano prima le macchine e scoprono dopo che alimentazione e climatizzazione non reggono, ritrovandosi a dover ridurre le frequenze — è come pagare a prezzo pieno una GPU «castrata». Prima dell'acquisto verificate tre cose: alimentazione dell'armadio (kW), temperatura e portata dell'aria in ingresso, e margine per le prossime 2–3 generazioni di GPU (dopo la B300 i TDP non faranno che salire).
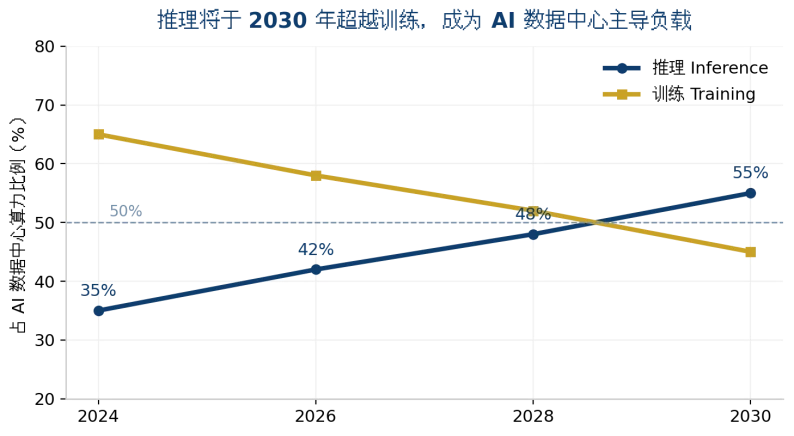
Figura 2: Entro il 2030 l'inferenza supererà il training come carico dominante dei data center AI (illustrazione di tendenza; fonti dei dati in appendice)
Noleggio cloud o infrastruttura propria? Come fare i conti?
Risposta rapida: sotto il 60% di utilizzo conviene il noleggio cloud; con carichi elevati e duraturi conviene l'infrastruttura propria. Ai prezzi di agosto 2026, il noleggio cloud di una H200 costa circa 4,4 /GPU·ora — circa 38.000 per un anno intero a pieno carico, cifra vicina al costo d'acquisto di una scheda. Più alto l'utilizzo, più veloce il rientro dell'infrastruttura propria.
Il bilancio dell'infrastruttura propria deve aggiungere tre voci: elettricità e gestione del raffreddamento (circa il 20%–30% del costo totale di possesso), il deprezzamento legato alle generazioni di GPU (nel 2026 la H100 è già fortemente svalutata — il rischio del valore residuo è reale) e la compliance dei dati: per i clienti finanziari, sanitari e della pubblica amministrazione i dati non escono dalla intranet, quindi il deployment privato non è una scelta ma un obbligo. L'architettura ibrida sta diventando la norma: training di picco nel cloud, inferenza permanente in locale.
ChangFan: server GPU e hardware AI pronti per l'era dell'inferenza
In definitiva, la scelta del server AI non si vince sulle schede tecniche, ma sull'aderenza tra configurazione e scenario. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) offre server GPU rack e sistemi di inferenza AI nei formati 1U/2U/4U, con espansione multi-GPU, alimentatori ridondanti e design a temperatura estesa. Numero di GPU, configurazione VRAM e raffreddamento (aria/liquido) sono personalizzabili in base alla dimensione del modello obiettivo: una base hardware stabile e affidabile per il deployment privato di LLM, nodi di inferenza edge e knowledge base aziendali.
Se state valutando l'acquisto e il deployment di server GPU di classe H200/B200/B300 o RTX PRO 6000, contattate ChangFan per una consulenza sulla configurazione e proposte di sistemi completi su misura per il vostro modello obiettivo (vendiamo hardware e realizziamo sistemi completi — non offriamo servizi software in abbonamento).
Domande frequenti (FAQ)
D1: Qual è la configurazione minima per eseguire un LLM 70B? R: In FP16 servono circa 140GB di VRAM, quindi una singola H200 è la risposta più economica; dopo la quantizzazione FP8, anche due RTX PRO 6000 (96GB×2) sono sufficienti, con costi inferiori e maggiore flessibilità di deployment.
D2: In cosa la B300 è superiore alla B200 e vale la pena aspettare? R: La B300 offre il 50% di VRAM in più (288GB contro 192GB) e 1,5× la potenza FP4, ma la stessa banda e un TDP salito a ~1400W che richiede il raffreddamento a liquido. L'upgrade conviene solo quando il modello o il KV Cache superano la capacità di un nodo B200.
D3: Da cosa dovrebbe partire una PMI al primo acquisto di un server AI? R: Definite prima il modello da eseguire. Per applicazioni 7B–14B (customer service, knowledge base, controllo qualità) per iniziare basta un server di inferenza 2U con una scheda; espandete a 4U multi-GPU quando il carico elevato e continuativo è confermato.
D4: Il raffreddamento a liquido è obbligatorio per i server AI? R: No. Sotto i 700W per scheda e con una sala in buone condizioni l'aria basta; il liquido serve solo oltre i 1000W per scheda o in installazioni multi-armadio ad alta densità. In fase di scelta, lasciate margine per l'andamento dei consumi delle prossime 2–3 generazioni di GPU.
D5: Le GPU cloud costano così poco, perché comprare un server proprio? R: Tre motivi — oltre ~60% di utilizzo l'infrastruttura propria costa meno; i dati sensibili non possono uscire dalla intranet; l'inferenza locale non ha latenza di rete e l'SLA è sotto il proprio controllo. La maggior parte delle aziende finisce con un'architettura ibrida «training nel cloud, inferenza in locale».