Wie wählt man einen KI-Server? Der vollständige Hardware-Konfigurationsleitfaden 2026 für Training und Inferenz
Einleitung: Warum die KI-Server-Auswahl 2026 zur Pflichtlektüre wurde
Die Struktur der KI-Rechenausgaben verändert sich grundlegend. Einer im Februar 2026 veröffentlichten McKinsey-Analyse zufolge wird die Inferenz bis 2030 das Training als dominante Last in KI-Rechenzentren überholen – mit mehr als der Hälfte aller KI-Berechnungen und etwa 30–40 % des Gesamtbedarfs der Rechenzentren. Für Unternehmen verschiebt sich die Beschaffungslogik von „Karten fürs Training stapeln“ zu „Inferenz mit kalkulierten Kosten betreiben“ – eine falsche Konfiguration kostet nicht einmalig zu viel, sondern drei Jahre lang jeden Tag Strom- und Mietkosten für die falsche Architektur.
Gleichzeitig hat sich der GPU-Generationsrhythmus deutlich beschleunigt: Kaum haben sich die 141GB VRAM der H200 etabliert, rollen bereits die 192GB der B200 und die 288GB der B300 aus, während die RTX PRO 6000 mit 96GB und PCIe-Formfaktor das mittlere Inferenzsegment besetzt. Mehr Modelle machen die Auswahl paradoxerweise schwerer. Dieser Artikel erklärt die KI-Server-Auswahl 2026 anhand einer Entscheidungsachse und zweier Vergleichstabellen.
Was genau ist der Unterschied zwischen einem Trainings- und einem Inferenzserver?
Kurzantwort: Training ist ein einmaliges, „rechenintensives“ Megaprojekt, Inferenz ein „VRAM- und bandbreitenintensiver“ Dauerbetrieb. Der Trainingsserver strebt nach Spitzenleistung der Multi-GPU-Vernetzung (vollständige NVLink/NVSwitch-Fabric, hohe Leistungsdichte, Flüssigkühlung); der Inferenzserver nach stabilem Durchsatz pro Kosteneinheit (VRAM fasst das Modell, Bandbreite liefert Tokens, Leistungsaufnahme pro Karte im Griff, 7×24-Zuverlässigkeit).
Hardwareseitig setzen Trainingscluster auf 8-GPU-Maschinen im SXM-Format mit InfiniBand-Vernetzung; bei der Inferenz ist die Auswahl deutlich breiter – Single-GPU-Workstations mit RTX PRO 6000, Multi-GPU-Server in 2U/4U bis hin zu kompakten Inferenzknoten am Edge. Die Realität 2026: Der überwiegende Teil der Unternehmens-KI-Budgets fließt in die Inferenz – die Serverauswahl sollte daher dem Prinzip „Inferenz zuerst, Training nach Bedarf“ folgen.
Warum ist VRAM bei der KI-Server-Auswahl wichtiger als Rechenleistung?
Kurzantwort: Passt das Modell nicht in den VRAM, sind selbst die höchsten TFLOPS null. Ob ein Modell läuft, hängt davon ab, wie viel VRAM Gewichte + KV Cache + Kontextlänge belegen; erst wenn es passt, werden Bandbreite, FP4/FP8-Unterstützung und Preis zu sinnvollen Vergleichsgrößen.
Faustregel (2026): Bei FP16-Präzision benötigt ein 70B-Modell etwa 140GB VRAM – eine einzelne H200 (141GB) fasst es genau, sonst braucht es zwei H100; FP8-Quantisierung halbiert den Bedarf; FP4 halbiert ihn erneut, doch nur die Blackwell-Architektur (B200/B300/RTX PRO 6000) unterstützt FP4 nativ. Jede Verdopplung des Kontextfensters lässt den KV Cache nahezu linear wachsen – darum liegt zwischen „passt hinein“ und „bedient gut“ noch die Bandbreite: Die H200 liefert 4,8 TB/s, die B200/B300 liefern 8 TB/s.
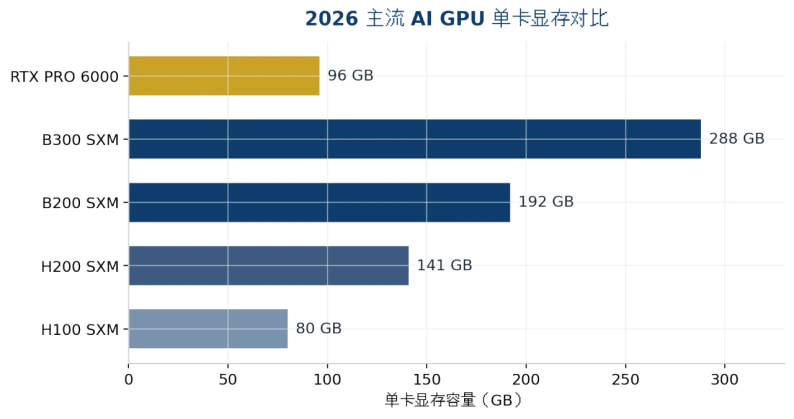
Abbildung 1: VRAM-Vergleich pro Karte bei den führenden KI-GPUs 2026 (Datenquellen im Anhang)
Die richtige Wahl unter den GPUs des Jahres 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Kurzantwort: Für Modelle bis 141GB bietet die H200 das beste Preis-Leistungs-Verhältnis; wer FP4 oder mehr VRAM braucht, wählt die B200; wenn eine einzelne Karte ein 200GB+-Modell fassen oder hohem KV-Cache-Druck standhalten muss, die B300; für mittlere Inferenz und PCIe-Umgebungen die RTX PRO 6000.
Dimension | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architektur | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Speicherbandbreite | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
FP4-Rechenleistung | Nicht unterstützt | 9 PFLOPS | 15 PFLOPS | Unterstützt (Single-GPU-Klasse) |
TDP / Kühlung | 700 W / Luftkühlung möglich | 1000 W / Flüssigkühlung empfohlen | ~1400 W / Flüssigkühlung praktisch erforderlich | 600 W / Luftkühlung |
Typische Positionierung | 70B–100B Inferenz, Fine-Tuning | 100B+ Inferenz, Training | Frontier-LLMs auf einem Knoten | Mittlere Inferenz, Workstation/Edge |
Cloud-Mietreferenz 2026 | ~$4.4/GPU·Std. | ~$5–7/GPU·Std. | ~$7.4–8.3/GPU·Std. | Überwiegend Komplettsystem-Kauf |
Tabelle 1: Schlüsselspezifikationen und Positionierung der führenden KI-GPUs 2026 (Preise = Marktreferenzwerte August 2026, stark schwankend – vor dem Kauf neu anfragen)
Zwei leicht übersehene Trends: Erstens ist der mittlere Cloud-Mietpreis der H200 seit August 2025 um etwa 25 % gestiegen, der Preisabstand zwischen Hopper und Blackwell schrumpft – das Fenster „mit der alten Generation sparen“ schließt sich; zweitens gibt es die RTX PRO 6000 jetzt in einer 400-W-Server-Version, mit der sich im gleichen Leistungsbudget mehr Karten betreiben lassen – vorteilhaft für Inferenzanbieter mit Abrechnung pro Token.
Wie groß ist das Modell – und wie viel Maschine braucht es?
Kurzantwort: Schätzen Sie die VRAM-Untergrenze als „Modellgewichte × 1,2 (Reserve für KV Cache)“ und bestimmen Sie dann anhand der folgenden Tabelle die GPU-Anzahl; Modelle, die einen einzelnen Knoten sprengen, gehen in den Multi-Maschinen-Parallelbetrieb – dort ist das Netzwerk wichtiger als die GPUs.
Zielmodell (2026) | Gewichtsgröße | Mindestkonfiguration | Empfohlene Bauform |
7B–14B (Qwen/Phi-Klasse) | 15–30GB (FP16) | RTX PRO 6000 ×1 oder 48GB-Workstation-Karte | Tower-/2U-Edge-Inferenzserver |
32B–70B (FP8-quantisiert) | 40–80GB | RTX PRO 6000 ×1–2 oder H200 ×1 | 2U/4U-GPU-Server |
70B FP16 / langer Kontext | ~140GB+ | H200 ×1 (knapp) oder ×2 (solide) | 4U-Multi-GPU-Server |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (~130GB Reserve) | 4U-Server mit Flüssigkühlung |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 oder B300 ×4 | 8-GPU-SXM-System |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB Gesamt-VRAM) | 8-GPU-Flaggschiff mit Flüssigkühlung |
Tabelle 2: Modellgröße vs. Serverkonfiguration (Gewichte gemäß offiziellen Checkpoints; im realen Einsatz KV Cache und Laufzeit-Overhead hinzurechnen)
Diese Tabelle erklärt auch, warum das 4U-Gehäuse der „Sweet Spot“ der KI-Server ist: 8 Dual-Width-GPUs, redundante Netzteile und ausreichende Kühlluftführung finden nur in 4U gleichzeitig Platz. 2U eignet sich für Inferenzknoten mit 2–4 Karten; 1U nimmt nur eine einzelne Karte auf oder dient als vorgelagerter Scheduling-/Speicherknoten.
Luft- oder Flüssigkühlung? Wie legt man Thermik- und Rack-Spezifikationen fest?
Kurzantwort: Unter 700 W pro Karte reicht Luftkühlung; über 1000 W pro Karte – oder über 20 kW pro Schrank – wird Flüssigkühlung vom „Pluspunkt“ zur „harten Anforderung“. Die TDP von ~1400 W der B300 legt die Flüssigkühlung praktisch fest.
Die richtige Auswahlreihenfolge lautet: zuerst Modell und GPU festlegen, dann die Gesamtleistung der Maschine, erst danach Kühlung und Raumbedingungen rückrechnen. Viele Unternehmen machen es umgekehrt – kaufen erst die Maschinen und stellen dann fest, dass Stromversorgung und Klimatisierung nicht mithalten; sie müssen drosseln und haben damit zum Vollpreis eine „kastrierte“ GPU gekauft. Vor dem Kauf unbedingt drei Dinge klären: Schrank-Stromversorgung (kW), Einlasstemperatur und Luftvolumenstrom sowie Reserve für die nächsten 2–3 GPU-Generationen (nach der B300 werden die TDP-Werte nur steigen).
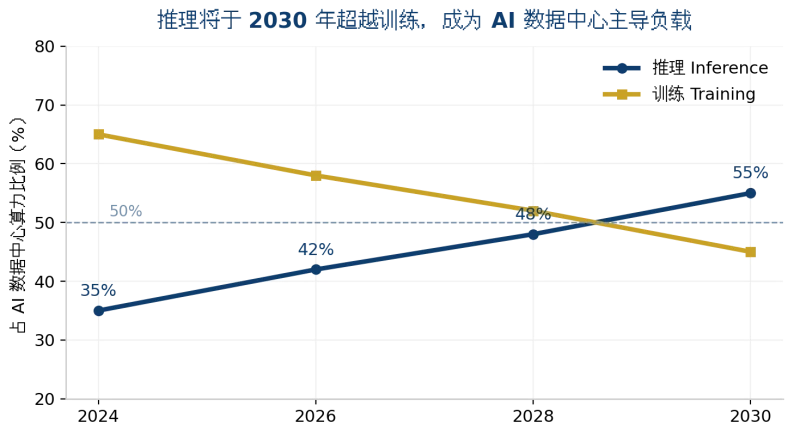
Abbildung 2: Bis 2030 überholt die Inferenz das Training als dominante Last der KI-Rechenzentren (Trendillustration; Datenquellen im Anhang)
Cloud-Miete oder Eigenbau? Wie rechnet sich das?
Kurzantwort: Unter 60 % Auslastung lohnt die Cloud-Miete, bei dauerhaft hoher Last der Eigenbau. Nach Marktlage August 2026 kostet die Cloud-Miete einer H200 etwa 4,4 /GPU·Stunde – rund 38.000 für ein ganzes Jahr Volllast, fast so viel wie der Kauf einer Karte. Je höher die Auslastung, desto schneller amortisiert sich der Eigenbau.
In die Eigenbaurechnung gehören drei weitere Posten: Strom und Kühlungsbetrieb (etwa 20–30 % der Gesamtbetriebskosten), der Wertverlust durch GPU-Generationen (2026 ist die H100 bereits tief abgewertet – das Restwertrisiko ist real) sowie Daten-Compliance: Bei Finanz-, Gesundheits- und Behördenkunden dürfen Daten das Intranet nicht verlassen – private Bereitstellung ist keine Option, sondern Pflicht. Die Hybridarchitektur wird zum Mainstream: Spitzen-Training in der Cloud, permanente Inferenz vor Ort.
ChangFan: GPU-Server und KI-Hardware für das Zeitalter der Inferenz
Letztlich entscheidet bei der KI-Server-Auswahl nicht das Datenblatt, sondern die Passung zwischen Konfiguration und Szenario. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) bietet Rack-GPU-Server und KI-Inferenzsysteme in 1U/2U/4U-Bauformen – mit Multi-GPU-Erweiterung, redundanten Netzteilen und erweitertem Temperaturbereich. GPU-Anzahl, VRAM-Konfiguration und Luft-/Flüssigkühlung werden auf die Zielmodellgröße zugeschnitten – eine stabile, zuverlässige Hardware-Basis für private LLM-Bereitstellung, Edge-Inferenzknoten und Unternehmens-Wissensdatenbanken.
Wenn Sie Kauf und Bereitstellung von GPU-Servern der Klasse H200/B200/B300 oder RTX PRO 6000 evaluieren, kontaktieren Sie ChangFan für Konfigurationsberatung und Komplettsystem-Angebote passend zu Ihrem Zielmodell (wir verkaufen Hardware und bauen Komplettsysteme – Software-Abonnements bieten wir nicht an).
Häufige Fragen (FAQ)
F1: Welche Mindestkonfiguration braucht ein 70B-LLM? A: Bei FP16 sind etwa 140GB VRAM nötig – eine einzelne H200 ist die wirtschaftlichste Antwort; nach FP8-Quantisierung schaffen es auch zwei RTX PRO 6000 (96GB×2) – günstiger und flexibler im Einsatz.
F2: Wie ist die B300 besser als die B200, und lohnt das Warten? A: Die B300 bietet 50 % mehr VRAM (288GB vs. 192GB) und 1,5× die FP4-Leistung, aber gleiche Bandbreite und eine auf ~1400 W gestiegene TDP, die Flüssigkühlung erfordert. Das Upgrade lohnt nur, wenn Modell oder KV Cache die Kapazität eines B200-Knotens überschreiten.
F3: Womit sollte ein KMU beim ersten KI-Server starten? A: Zuerst das auszuführende Modell festlegen. Für 7B–14B-Anwendungen (Kundenservice, Wissensdatenbank, Qualitätsprüfung) genügt zum Start ein 2U-Inferenzserver mit einer Karte; bei bestätigter Dauerhochlast auf 4U Multi-GPU erweitern.
F4: Ist Flüssigkühlung für KI-Server Pflicht? A: Nein. Unter 700 W pro Karte und bei guten Raumbedingungen reicht Luft; Flüssigkühlung ist erst über 1000 W pro Karte oder bei hochdichten Multi-Schrank-Installationen nötig. Planen Sie Reserve für den Leistungstrend der nächsten 2–3 GPU-Generationen ein.
F5: Cloud-GPUs sind so günstig – warum einen eigenen Server kaufen? A: Drei Gründe – ab etwa 60 % Auslastung ist Eigenbau günstiger; sensible Daten dürfen das Intranet nicht verlassen; lokale Inferenz hat keine Netzwerklatenz und ein selbst kontrolliertes SLA. Die meisten Unternehmen landen bei der Hybridarchitektur „Training in der Cloud, Inferenz vor Ort“.