Hoe kies je een AI-server? De complete hardwareconfiguratiegids 2026 voor training en inferentie
Inleiding: waarom AI-serverkeuze in 2026 verplichte kost werd
De structuur van de uitgaven aan AI-rekenkracht verandert fundamenteel. Uit een analyse van McKinsey van februari 2026 blijkt dat inferentie in 2030 training zal inhalen als dominante workload in AI-datacenters — goed voor meer dan de helft van alle AI-rekenwerk en circa 30–40% van de totale datacentervraag. Voor bedrijven verschuift de aankooplogica van servers van 'kaarten stapelen voor training' naar 'inferentie draaien met strakke kostenbeheersing' — een verkeerde configuratie kost geen eenmalige meerprijs, maar drie jaar lang elke dag stroom- en huurkosten voor de verkeerde architectuur.
Tegelijkertijd is het iteratietempo van GPU's duidelijk versneld: de 141GB VRAM van de H200 was nog niet eens ingeburgerd of de 192GB van de B200 en de 288GB van de B300 rollen al uit, terwijl de RTX PRO 6000 met 96GB en een PCIe-vormfactor de markt voor middensegment-inferentie inpikt. Meer modellen maken de keuze juist lastiger. Dit artikel maakt de AI-serverkeuze van 2026 helder met één beslissingsas en twee vergelijkingstabellen.
Wat is precies het verschil tussen een trainingsserver en een inferentieserver?
Kort antwoord: training is een eenmalig, 'rekenintensief' megaproject; inferentie is een 'VRAM- en bandbreedte-intensieve' doorlopende dienst. De trainingsserver jaagt op piekrekenkracht van multi-GPU-interconnect (volledige NVLink/NVSwitch-fabric, hoge vermogensdichtheid, vloeistofkoeling); de inferentieserver op stabiele doorvoer per kosteneenheid (VRAM die het model herbergt, bandbreedte die tokens levert, beheerst opgenomen vermogen per kaart, 7×24-betrouwbaarheid).
In hardwaretermen geven trainingsclusters de voorkeur aan 8-GPU-machines in SXM-formaat met InfiniBand-netwerken; voor inferentie is het optieveld veel breder — single-GPU-werkstations met RTX PRO 6000, multi-GPU-servers in 2U/4U en zelfs compacte inferentienodes aan de edge. De realiteit van 2026: het overgrote deel van de AI-budgetten van bedrijven gaat naar inferentie, dus serverkeuze hoort het principe 'inferentie eerst, training op aanvraag' te volgen.
Waarom is VRAM belangrijker dan rekenkracht bij de keuze van een AI-server?
Kort antwoord: past het model niet in de VRAM, dan zijn de hoogste TFLOPS nul waard. Of een model kan draaien, hangt af van hoeveel VRAM de gewichten + KV Cache + contextlengte innemen; pas als het past, worden bandbreedte, FP4/FP8-ondersteuning en prijs zinvolle vergelijkingspunten.
Vuistregel (2026): bij FP16-precisie heeft een 70B-model circa 140GB VRAM nodig — een enkele H200 (141GB) herbergt het precies, anders heb je twee H100's nodig; FP8-quantisering halveert de behoefte; FP4 halveert die opnieuw, maar alleen de Blackwell-architectuur (B200/B300/RTX PRO 6000) ondersteunt FP4 native. Elke verdubbeling van het contextvenster laat het KV Cache-gebruik vrijwel lineair groeien — daarom ligt er tussen 'het past' en 'het serveert goed' nog bandbreedte: de H200 levert 4,8 TB/s, de B200/B300 leveren 8 TB/s.
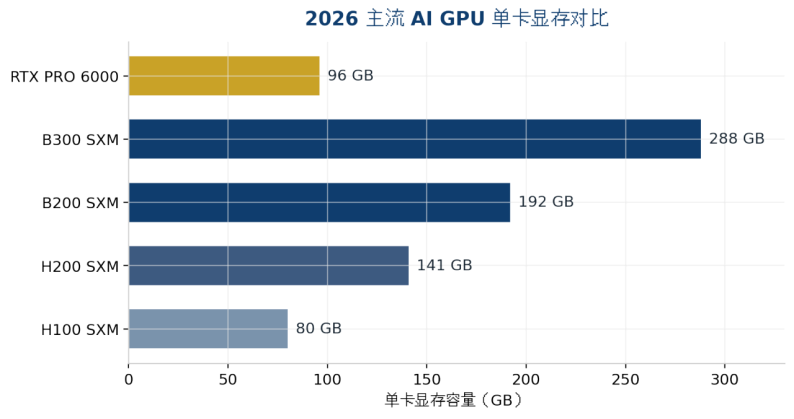
Figuur 1: VRAM-vergelijking per kaart van de belangrijkste AI-GPU's in 2026 (databronnen in de bijlage)
Hoe kies je tussen de GPU's van 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Kort antwoord: voor modellen tot 141GB biedt de H200 de beste prijs-kwaliteitverhouding; kies de B200 als je FP4 of meer VRAM nodig hebt; kies de B300 als één kaart een model van meer dan 200GB moet herbergen of de KV Cache-druk hoog is; kies de RTX PRO 6000 voor inferentie in het middensegment en PCIe-omgevingen.
Dimensie | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architectuur | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Geheugenbandbreedte | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
FP4-rekenkracht | Niet ondersteund | 9 PFLOPS | 15 PFLOPS | Ondersteund (single-GPU-klasse) |
TDP / koeling | 700W / luchtkoeling mogelijk | 1000W / vloeistofkoeling aanbevolen | ~1400W / vloeistofkoeling vrijwel vereist | 600W / luchtkoeling |
Typische positionering | 70B–100B-inferentie, fine-tuning | 100B+-inferentie, training | Frontier-LLM's op één node | Middensegment-inferentie, werkstation/edge |
Cloudhuurreferentie 2026 | ~$4.4/GPU·u | ~$5–7/GPU·u | ~$7.4–8.3/GPU·u | Voornamelijk aanschaf van complete systemen |
Tabel 1: Sleutelspecificaties en positionering van de belangrijkste AI-GPU's in 2026 (prijzen zijn marktreferenties van augustus 2026 en zeer volatiel — vraag voor aankoop een actuele offerte)
Er zijn nog twee gemakkelijk over het hoofd geziene trends: ten eerste is de mediane cloudhuurprijs van de H200 sinds augustus 2025 met circa 25% gestegen, het prijsverschil tussen Hopper en Blackwell wordt kleiner en het venster 'besparen met de vorige generatie' sluit; ten tweede is er nu een 400W-serverversie van de RTX PRO 6000, waarmee binnen hetzelfde vermogensbudget meer kaarten kunnen draaien — gunstiger voor inferentieaanbieders die per token factureren.
Hoe groot is het model, hoeveel machine is er nodig?
Kort antwoord: schat de VRAM-ondergrens als 'modelgewichten × 1,2 (marge voor KV Cache)' en bepaal daarna met onderstaande tabel het aantal GPU's; modellen die één node te boven gaan, schakelen over op multi-machine-parallellisme, waar het netwerk belangrijker is dan de GPU's.
Doelmodel (2026) | Gewichtsomvang | Minimale configuratie | Aanbevolen systeemvorm |
7B–14B (Qwen/Phi-klasse) | 15–30GB (FP16) | RTX PRO 6000 ×1 of 48GB-werkstationkaart | Tower-/2U-edge-inferentieserver |
32B–70B (FP8-gekwantiseerd) | 40–80GB | RTX PRO 6000 ×1–2 of H200 ×1 | 2U/4U-GPU-server |
70B FP16 / lange context | ~140GB+ | H200 ×1 (krap) of ×2 (zeker) | 4U-multi-GPU-server |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (~130GB marge) | 4U-server met vloeistofkoeling |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 of B300 ×4 | 8-GPU-SXM-systeem |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB totale VRAM) | 8-GPU-vlaggenschip met vloeistofkoeling |
Tabel 2: Modelgrootte versus serverconfiguratie (gewichten volgens officiële checkpoints; bij feitelijke inzet moeten KV Cache en runtime-overhead worden opgeteld)
Deze tabel verklaart ook waarom het 4U-chassis de 'sweet spot' van AI-servers is: 8 dual-width GPU's, redundante voedingen en voldoende koelluchtkanalen — alleen een 4U behuist dit alles tegelijk. 2U is geschikt voor inferentienodes met 2–4 kaarten; 1U past slechts één kaart of dient als front-end scheduling-/opslagnode.
Lucht- of vloeistofkoeling? Hoe bepaal je thermische en rackspecificaties?
Kort antwoord: onder 700W per kaart is luchtkoeling voldoende; boven 1000W per kaart — of boven 20kW per rack — verandert vloeistofkoeling van 'pre' in 'harde eis'. De TDP van ~1400W van de B300 legt vloeistofkoeling feitelijk vast.
De juiste selectievolgorde is: eerst het model en de GPU vastleggen, dan het totale systeemvermogen en pas daarna koeling en ruimteomstandigheden terugrekenen. Veel bedrijven doen het andersom — ze kopen eerst de machines en ontdekken dan dat stroomtoevoer en airconditioning het niet bijhouden, waarna ze gedwongen moeten downclocken: alsof je de volle prijs betaalt voor een 'gecastreerde' GPU. Bevestig vóór aankoop drie zaken: rackvoeding (kW), inlaattemperatuur en luchtvolume, en ruimte voor de komende 2–3 GPU-generaties (na de B300 gaan de TDP's alleen maar omhoog).
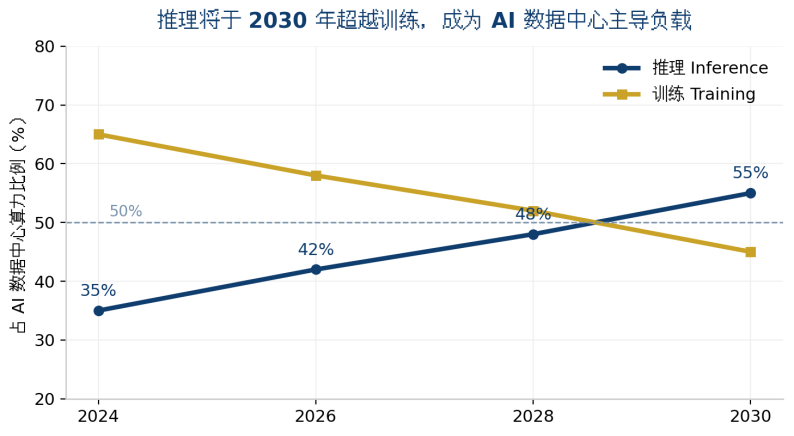
Figuur 2: In 2030 haalt inferentie training in als dominante workload van AI-datacenters (trendillustratie; databronnen in de bijlage)
Cloud huren of zelf bouwen? Hoe reken je dat uit?
Kort antwoord: onder 60% benutting is cloudhuur voordeliger, bij duurzaam hoge belasting loont zelfbouw. Tegen de tarieven van augustus 2026 kost cloudhuur van een H200 circa 4,4/GPU·uur — zo'n38.000 voor een heel jaar op volle belasting, bijna evenveel als de aanschaf van één kaart. Hoe hoger de benutting, hoe sneller zelfbouw zich terugverdient.
Bij de zelfbouwbegroting komen nog drie posten: stroom en koelingsbeheer (circa 20–30% van de totale eigendomskosten), afschrijving door GPU-generaties (de H100 is in 2026 al diep afgeprijsd — restwaarderisico is reëel) en datacompliance: bij financiële, medische en overheidsklanten mogen data het intranet niet verlaten, waardoor private inzet geen keuze maar een verplichting is. De hybride architectuur wordt mainstream: piektraining in de cloud, permanente inferentie on-premises.
ChangFan: GPU-servers en AI-hardware klaar voor het inferentietijdperk
Uiteindelijk wordt de AI-serverkeuze niet gewonnen op specificatiebladen, maar op de match tussen configuratie en scenario. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) levert rack-GPU-servers en AI-inferentiesystemen in de vormfactoren 1U/2U/4U, met multi-GPU-uitbreiding, redundante voedingen en een ontwerp voor een breed temperatuurbereik. Aantal GPU's, VRAM-configuratie en lucht-/vloeistofkoeling worden op maat gemaakt voor de doelmodelgrootte — een stabiele en betrouwbare hardwarebasis voor private LLM-implementatie, edge-inferentienodes en zakelijke kennisbanken.
Evalueert u de aanschaf en inzet van GPU-servers van het niveau H200/B200/B300 of RTX PRO 6000, neem dan contact op met ChangFan voor configuratieadvies en voorstellen voor complete systemen op maat van uw doelmodel (wij verkopen hardware en bouwen complete systemen — wij bieden geen software-abonnementen aan).
Veelgestelde vragen (FAQ)
V1: Wat is de minimale configuratie om een 70B-LLM te draaien? A: Bij FP16 heb je circa 140GB VRAM nodig, dus een enkele H200 is het meest economische antwoord; na FP8-quantisering volstaan ook twee RTX PRO 6000-kaarten (96GB×2) — goedkoper en flexibeler in te zetten.
V2: Waarin is de B300 beter dan de B200 en is het de moeite waard om te wachten? A: De B300 biedt 50% meer VRAM (288GB versus 192GB) en 1,5× de FP4-rekenkracht, maar dezelfde bandbreedte en een TDP die is gestegen naar ~1400W en vloeistofkoeling vereist. Upgraden loont alleen als uw model of KV Cache de capaciteit van een B200-node ontgroeit.
V3: Waarmee moet een mkb'er beginnen bij de aanschaf van een eerste AI-server? A: Bepaal eerst welk model u gaat draaien. Voor 7B–14B-toepassingen (klantenservice, kennisbank, kwaliteitscontrole) is één 2U-inferentieserver met één kaart voldoende om te starten; breid uit naar 4U multi-GPU zodra duurzame hoge belasting is bevestigd.
V4: Is vloeistofkoeling verplicht voor AI-servers? A: Nee. Onder 700W per kaart en bij goede ruimteomstandigheden volstaat lucht; vloeistofkoeling is pas nodig boven 1000W per kaart of bij dichte multi-rack-installaties. Houd bij de keuze marge voor het vermogenstrend van de komende 2–3 GPU-generaties.
V5: Cloud-GPU's zijn zo goedkoop — waarom een eigen server kopen? A: Drie redenen — boven circa 60% benutting is zelfbouw goedkoper; gevoelige data mogen het intranet niet verlaten; en lokale inferentie kent geen netwerklatentie en een SLA onder eigen beheer. De meeste bedrijven komen uiteindelijk uit op een hybride architectuur 'trainen in de cloud, inferentie lokaal'.