Як обрати AI-сервер? Повний посібник 2026 року з апаратної конфігурації для навчання та інференсу
Вступ: чому вибір AI-сервера став обов'язковим навиком 2026 року
Структура витрат на AI-обчислення докорінно змінюється. Згідно з аналітикою McKinsey, опублікованою в лютому 2026 року, до 2030 року інференс випередить навчання і стане домінантним навантаженням у AI-дата-центрах — понад половина всіх AI-обчислень і приблизно 30–40% загального попиту дата-центрів. Логіка закупівлі серверів зміщується від «набрати більше карт під навчання» до «економно крутити інференс» — помилка в конфігурації коштує не разової переплати, а трьох років щоденних рахунків за електроенергію та оренду неправильної архітектури.
Водночас помітно прискорився цикл оновлення GPU: 141 ГБ відеопам'яті H200 ще не встигли «освоїтися», як уже розгортаються 192 ГБ у B200 та 288 ГБ у B300, а RTX PRO 6000 з 96 ГБ і форм-фактором PCIe відвойовує ринок інференсу середнього рівня. Чим більше моделей, тим складніше обирати. У цій статті ми зводимо вибір AI-сервера 2026 року до однієї осі прийняття рішень і двох порівняльних таблиць.
Чим насправді відрізняється сервер навчання від сервера інференсу?
Коротка відповідь: навчання — це разовий «обчислювально-ємний» мегапроєкт, інференс — безперервний сервіс, «ємний за відеопам'яттю та пропускною здатністю». Сервер навчання прагне пікової продуктивності багатокартної зв'язки (повна зв'язність NVLink/NVSwitch, висока щільність потужності, рідинне охолодження); сервер інференсу — стабільної пропускної здатності на одиницю вартості (модель поміщається у відеопам'ять, пропускна здатність видає токени, енергоспоживання карти під контролем, надійність 7×24).
У залізі це виглядає так: для кластерів навчання кращі 8-карткові машини форм-фактора SXM з мережею InfiniBand; у інференсу вибір ширший — однокарткові робочі станції на RTX PRO 6000, багатокарткові сервери 2U/4U і навіть компактні вузли інференсу на периферії. Реальність 2026 року: переважна більшість корпоративних AI-бюджетів йде на інференс, тож і сервери варто обирати за принципом «інференс у пріоритеті, навчання — за потребою».
Чому під час вибору AI-сервера відеопам'ять важливіша за обчислювальну потужність?
Коротка відповідь: якщо модель не поміщається у відеопам'ять, будь-які TFLOPS дорівнюють нулю. Чи зможе модель працювати, визначається тим, скільки відеопам'яті займають ваги + KV Cache + довжина контексту; лише після цього мають сенс порівняння за пропускною здатністю, підтримкою FP4/FP8 та ціною.
Емпіричне правило (2026 рік): у точності FP16 моделі 70B потрібно близько 140 ГБ відеопам'яті — одна H200 (141 ГБ) вміщує її впритул, інакше потрібні дві H100; квантування у FP8 скорочує потребу вдвічі; FP4 — ще вдвічі, але нативно FP4 підтримує лише архітектура Blackwell (B200/B300/RTX PRO 6000). З кожним подвоєнням контекстного вікна обсяг KV Cache зростає майже лінійно — тому між «поміщається» та «добре обслуговує» стоїть пропускна здатність: у H200 це 4,8 ТБ/с, у B200/B300 — 8 ТБ/с.
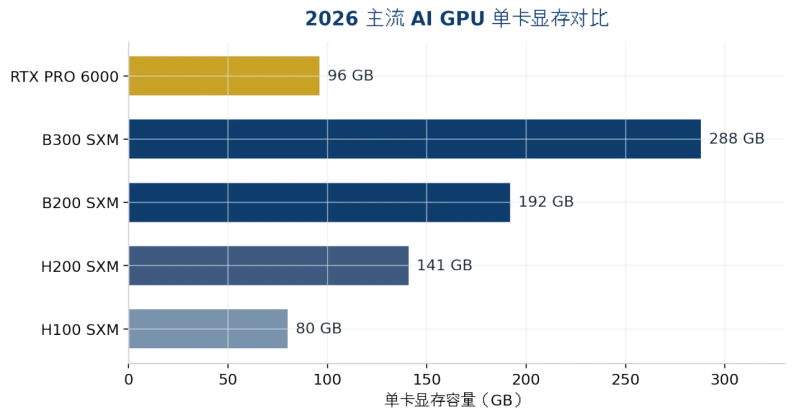
Рис. 1: Порівняння відеопам'яті однієї карти в основних AI-GPU 2026 року (джерела даних — у додатку)
Як обрати серед основних GPU 2026 року: порівняння H200, B200, B300 і RTX PRO 6000
Коротка відповідь: для моделей у межах 141 ГБ найвигідніший варіант — H200; якщо потрібні FP4 або більше відеопам'яті — B200; якщо одна карта має вміщувати модель понад 200 ГБ або великий тиск KV Cache — B300; для інференсу середнього рівня та PCIe-середовищ — RTX PRO 6000.
Параметр | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Архітектура | Hopper | Blackwell | Blackwell Ultra | Blackwell |
Відеопам'ять | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Пропускна здатність пам'яті | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Продуктивність FP4 | Не підтримується | 9 PFLOPS | 15 PFLOPS | Підтримується (клас однієї карти) |
TDP / охолодження | 700 Вт / можливе повітряне | 1000 Вт / рекомендоване рідинне | ~1400 Вт / практично обов'язкове рідинне | 600 Вт / повітряне |
Типове позиціонування | Інференс 70B–100B, донавчання | Інференс 100B+, навчання | Фронтирні LLM на одному вузлі | Інференс середнього рівня, робочі станції/периферія |
Орієнтир хмарної оренди 2026 | ~$4.4/GPU·год | ~$5–7/GPU·год | ~$7.4–8.3/GPU·год | Переважно закупівля цілих машин |
Таблиця 1: Ключові характеристики та позиціонування основних AI-GPU 2026 року (ціни — ринкові орієнтири на серпень 2026 року, дуже мінливі; перед закупівлею запитайте актуальну ціну)
Є й дві тенденції, які легко пропустити: по-перше, медіанна ціна хмарної оренди H200 з серпня 2025 року зросла приблизно на 25%, розрив у ціні між Hopper і Blackwell скорочується, і вікно «заощадити на попередньому поколінні» закривається; по-друге, у RTX PRO 6000 з'явилася серверна версія на 400 Вт — у той самий енергобюджет поміщається більше карт, що вигідно провайдерам інференсу з тарифікацією за токен.
Якого розміру модель — такої й машини потрібно?
Коротка відповідь: оцініть нижню межу відеопам'яті як «ваги моделі × 1,2 (запас під KV Cache)», потім за таблицею нижче визначте кількість GPU; моделі, що не вміщуються в один вузол, переходять на багатомашинний паралелізм — і там мережа важливіша за GPU.
Цільова модель (2026) | Розмір ваг | Мінімальна конфігурація | Рекомендований форм-фактор |
7B–14B (клас Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 або робоча станція 48 ГБ | Напольний/2U периферійний сервер інференсу |
32B–70B (квантування FP8) | 40–80GB | RTX PRO 6000 ×1–2 або H200 ×1 | GPU-сервер 2U/4U |
70B FP16 / довгий контекст | ~140GB+ | H200 ×1 (впритул) або ×2 (із запасом) | Багатокартковий сервер 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (запас ~130 ГБ) | Сервер 4U з рідинним охолодженням |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 або B300 ×4 | 8-карткова машина SXM |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (сумарно 2,3 ТБ відеопам'яті) | Флагманська 8-карткова машина з рідинним охолодженням |
Таблиця 2: Відповідність розміру моделі та конфігурації сервера (ваги — за офіційними checkpoint; при реальному розгортанні додайте KV Cache та накладні витрати середовища виконання)
Ця таблиця також пояснює, чому корпус 4U — «золота середина» AI-серверів: 8 двослотових GPU, резервовані блоки живлення та достатні вентиляційні канали одночасно поміщаються лише в 4U. Формат 2U підходить для вузлів інференсу на 2–4 карти, а 1U — лише для однієї карти або в ролі фронтального вузла планування/зберігання.
Повітряне чи рідинне охолодження? Як визначити тепловий та стійковий бюджет?
Коротка відповідь: до 700 Вт на карту достатньо повітряного охолодження; понад 1000 Вт на карту — або при потужності стійки більше 20 кВт — рідинне охолодження з «бонуса» перетворюється на «жорстку вимогу». TDP B300 близько 1400 Вт практично однозначно означає рідинне охолодження.
Правильна послідовність вибору: спочатку модель і GPU, потім потужність усієї машини, і лише потім зворотний розрахунок охолодження та умов машинного залу. Багато компаній роблять навпаки — спочатку купують залізо, а потім з'ясовують, що електроживлення та кондиціювання не витримують, і змушені працювати на зниженій частоті: фактично за повну ціну куплено «кастровану» GPU. Перед закупівлею обов'язково підтвердьте три речі: живлення стійки (кВт), температуру та об'єм припливного повітря, а також запас під 2–3 наступні покоління GPU (після B300 TDP лише зростатиме).
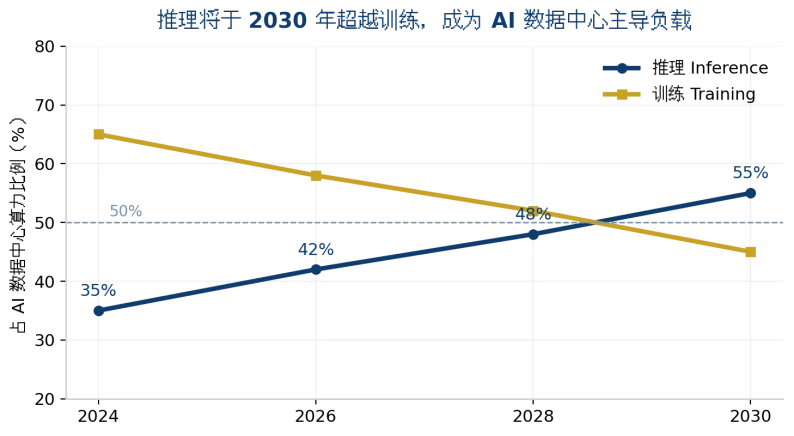
Рис. 2: До 2030 року інференс випередить навчання як домінантне навантаження AI-дата-центрів (ілюстрація тренду; джерела даних — у додатку)
Хмарна оренда чи власна інфраструктура? Як рахувати економіку?
Коротка відповідь: при завантаженні нижче 60% вигідніша хмарна оренда, при стабільно високому навантаженні — власне залізо. За цінами серпня 2026 року оренда H200 у хмарі коштує близько 4,4 за GPU·год — приблизно38 тис. за повний рік цілодобової роботи, що близько до вартості купівлі однієї карти. Чим вище завантаження, тим швидше окупається власний сервер.
До розрахунку власної інфраструктури потрібно додати ще три статті: електроенергія та експлуатація охолодження (близько 20–30% сукупної вартості володіння), амортизація від зміни поколінь GPU (у 2026 році H100 уже глибоко здешевила — ризик залишкової вартості реальний), а також комплаєнс щодо даних: у фінансових, медичних та державних замовників дані не залишають внутрішній контур, тому приватне розгортання — не вибір, а необхідність. Мейнстрімом стає гібридна архітектура: пікове навчання — у хмарі, постійний інференс — локально.
ChangFan: GPU-сервери та AI-обладнання для епохи інференсу
Зрештою, вибір AI-сервера виграється не в таблицях характеристик, а у відповідності конфігурації сценарію. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) пропонує стійкові GPU-сервери та машини AI-інференсу у форм-факторах 1U/2U/4U з підтримкою багатокарткового розширення, резервованим живленням і широким температурним діапазоном. Кількість GPU, обсяг відеопам'яті та схема охолодження (повітряна/рідинна) налаштовуються під цільовий розмір моделі — стабільна та надійна апаратна основа для приватного розгортання LLM, периферійних вузлів інференсу та корпоративних баз знань.
Якщо ви оцінюєте закупівлю та розгортання GPU-серверів класу H200/B200/B300 або RTX PRO 6000, звертайтеся до ChangFan — підберемо конфігурацію та готове машинне рішення під вашу цільову модель (ми продаємо обладнання та збираємо цілі машини; послуг за підпискою на ПЗ не надаємо).
Поширені запитання (FAQ)
П1: Яка мінімальна конфігурація потрібна для запуску моделі 70B? В: У FP16 потрібно близько 140 ГБ відеопам'яті, тому одна H200 — найекономніша відповідь; після квантування у FP8 завдання вирішують і дві RTX PRO 6000 (96 ГБ × 2) — дешевше й гнучкіше в розгортанні.
П2: Чим B300 краща за B200 і чи варто чекати? В: У B300 на 50% більше відеопам'яті (288 ГБ проти 192 ГБ) і в 1,5 раза вища продуктивність FP4, але пропускна здатність та сама, а TDP зросла до ~1400 Вт і потребує рідинного охолодження. Переходити варто, лише якщо модель або KV Cache переростають ємність вузла на B200.
П3: Що порадите малому та середньому бізнесу для першого AI-сервера? В: Спочатку визначте, яку модель запускатимете. Для застосунків рівня 7B–14B (клієнтська підтримка, бази знань, контроль якості) для старту достатньо одного сервера інференсу 2U з однією картою; за підтвердженого постійного високого навантаження розширюйтеся до багатокарткового 4U.
П4: Чи обов'язкове рідинне охолодження для AI-сервера? В: Ні. До 700 Вт на карту за хороших умов машинного залу достатньо повітряного; рідинне потрібне понад 1000 Вт на карту або за щільного розміщення кількох стійок. Під час вибору закладайте запас під енергоспоживання 2–3 наступних поколінь GPU.
П5: Хмарні GPU такі дешеві — навіщо купувати власний сервер? В: Три причини: при завантаженні вище ~60% власне залізо дешевше; чутливі дані не можуть залишати внутрішній контур; локальний інференс — без мережевих затримок і з власним SLA. Більшість компаній зрештою приходять до гібридної схеми «навчання в хмарі, інференс локально».