عنوان اول: سرور هوش مصنوعی را چگونه انتخاب کنیم؟ راهنمای کامل 2026 پیکربندی سختافزار برای آموزش و استنتاج
مقدمه: چرا انتخاب سرور هوش مصنوعی در 2026 به درسی اجباری تبدیل شده است
ساختار هزینههای محاسبات هوش مصنوعی در حال دگرگونی بنیادین است. تحلیلی که مکینزی در فوریه 2026 منتشر کرده نشان میدهد تا سال 2030، استنتاج (inference) از آموزش پیشی میگیرد و به بار غالب در مراکز داده هوش مصنوعی تبدیل میشود — بیش از نیمی از کل محاسبات هوش مصنوعی و حدود 30 تا 40 درصد از تقاضای کل مراکز داده. این یعنی منطق خرید سرور برای سازمانها از «انبار کردن کارت برای آموزش» به «اجرای استنتاج با صرفهجویی دقیق» تغییر میکند — انتخاب پیکربندی اشتباه، هزینهاش یک پرداخت اضافه یکباره نیست، بلکه سه سال پرداخت روزانه قبض برق و اجاره برای معماری اشتباه است.
همزمان، ریتم بهروزرسانی GPUها بهوضوح شتاب گرفته است: حافظه ویدئویی 141GB مدل H200 هنوز جا نیفتاده که 192GB مدل B200 و 288GB مدل B300 در حال گسترشاند و RTX PRO 6000 نیز با 96GB و فرمفاکتور PCIe بازار استنتاج میانرده را میرباید. هرچه مدلها بیشتر شوند، انتخاب دشوارتر میشود. این مقاله انتخاب سرور هوش مصنوعی در 2026 را با یک محور تصمیمگیری و دو جدول مقایسه روشن میکند.
تفاوت واقعی سرور آموزش و سرور استنتاج دقیقاً چیست؟
پاسخ کوتاه: آموزش یک مگاپروژه یکباره «محاسباتمحور» است و استنتاج یک سرویس پیوسته «حافظهویدئویی و پهنایباندمحور». سرور آموزش به دنبال اوج توان محاسباتی در اتصال چندکارت است (نسج کامل NVLink/NVSwitch، چگالی توان بالا، خنککاری مایع)؛ سرور استنتاج به دنبال توان عملیاتی پایدار به ازای هر واحد هزینه است (حافظه ویدئوییای که مدل را جا دهد، پهنای باندی که توکن بیرون دهد، توان مصرفی کنترلشده هر کارت و قابلیت اطمینان 7×24).
در سطح سختافزار، خوشههای آموزش ماشینهای 8 کارته با فرمفاکتور SXM و شبکه InfiniBand را ترجیح میدهند؛ اما استنتاج گزینههای بسیار گستردهتری دارد — ایستگاههای کاری تککارته RTX PRO 6000، سرورهای چندکارته 2U/4U و حتی گرههای کوچک استنتاج در لبه شبکه. واقعیت 2026 این است که بخش اعظم بودجه هوش مصنوعی سازمانها صرف استنتاج میشود، پس انتخاب سرور هم باید از اصل «استنتاج در اولویت، آموزش بر اساس نیاز» پیروی کند.
چرا در انتخاب سرور هوش مصنوعی، حافظه ویدئویی از توان محاسباتی مهمتر است؟
پاسخ کوتاه: اگر مدل در حافظه ویدئویی جا نشود، بالاترین TFLOPS هم برابر صفر است. اجراپذیر بودن یک مدل به این بستگی دارد که وزنها + KV Cache + طول متن چقدر حافظه ویدئویی اشغال کنند؛ تنها پس از جا شدن است که مقایسه پهنای باند، پشتیبانی FP4/FP8 و قیمت معنا پیدا میکند.
قاعده سرانگشتی (2026): در دقت FP16، مدل 70B به حدود 140GB حافظه ویدئویی نیاز دارد — یک کارت H200 (141GB) دقیقاً آن را جا میدهد، وگرنه به دو کارت H100 نیاز است؛ کوانتیزیشن FP8 نیاز را نصف میکند؛ FP4 دوباره نصف میکند، اما فقط معماری Blackwell (B200/B300/RTX PRO 6000) از FP4 بهصورت بومی پشتیبانی میکند. با هر دوبرابر شدن پنجره متن، مصرف KV Cache تقریباً خطی رشد میکند — به همین دلیل است که میان «جا شدن» و «خدمترسانی خوب» هنوز پهنای باند ایستاده است: H200 معادل 4.8 TB/s و B200/B300 معادل 8 TB/s ارائه میدهند.
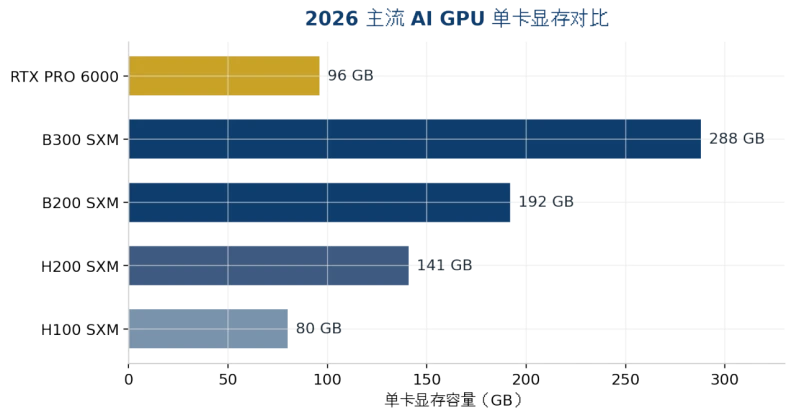
شکل 1: مقایسه حافظه ویدئویی تککارت GPUهای اصلی هوش مصنوعی در 2026 (منابع داده در پیوست)
از میان GPUهای غالب 2026 چگونه انتخاب کنیم: مقایسه H200، B200، B300 و RTX PRO 6000
پاسخ کوتاه: برای مدلهای تا 141GB، مدل H200 بیشترین صرفه اقتصادی را دارد؛ اگر به FP4 یا حافظه ویدئویی بیشتر نیاز دارید B200 را انتخاب کنید؛ اگر یک کارت باید مدلی بالای 200GB را جا دهد یا فشار KV Cache بالاست B300 را برگزینید؛ و برای استنتاج میانرده و محیطهای PCIe مدل RTX PRO 6000 را انتخاب کنید.
بُعد | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
معماری | Hopper | Blackwell | Blackwell Ultra | Blackwell |
حافظه ویدئویی | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
پهنای باند حافظه | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
توان FP4 | پشتیبانی نمیشود | 9 PFLOPS | 15 PFLOPS | پشتیبانی میشود (کلاس تککارت) |
TDP / خنککاری | 700W / هوایی امکانپذیر | 1000W / مایع توصیه میشود | ~1400W / مایع عملاً لازم | 600W / هوایی |
جایگاه معمول | استنتاج 70B–100B و ریزتنظیم | استنتاج 100B+ و آموزش | مدلهای زبانی پیشرو روی یک گره | استنتاج میانرده، ایستگاه کاری/لبه |
مرجع اجاره ابری 2026 | ~$4.4/GPU·ساعت | ~$5–7/GPU·ساعت | ~$7.4–8.3/GPU·ساعت | عمدتاً خرید سامانه کامل |
جدول 1: مشخصات کلیدی و جایگاه GPUهای اصلی هوش مصنوعی در 2026 (قیمتها مقادیر مرجع بازار اوت 2026 و بسیار نوسانی هستند — پیش از خرید استعلام قیمت تازه بگیرید)
دو روند هم هست که بهآسانی از چشم پنهان میمانند: نخست اینکه قیمت میانه اجاره ابری H200 از اوت 2025 حدود 25 درصد افزایش یافته، شکاف قیمتی Hopper و Blackwell در حال بسته شدن است و پنجره «صرفهجویی با نسل قدیمی» رو به بستن است؛ دوم اینکه RTX PRO 6000 نسخه Server با توان 400W عرضه کرده که در همان بودجه توان، امکان نصب کارتهای بیشتری میدهد — برای ارائهدهندگان استنتاج با صورتحساب بهازای توکن مناسبتر است.
مدل هرقدر بزرگ، ماشین هم همانقدر بزرگ؟
پاسخ کوتاه: کف حافظه ویدئویی را با فرمول «وزنهای مدل × 1.2 (حاشیه برای KV Cache)» برآورد کنید و سپس با جدول زیر تعداد GPU را تعیین کنید؛ مدلهایی که از یک گره فراتر میروند وارد موازیسازی چندماشینی میشوند که در آن شبکه از GPU مهمتر است.
مدل هدف (2026) | اندازه وزنها | حداقل پیکربندی | شکل پیشنهادی سامانه |
7B–14B (کلاس Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 یا کارت ایستگاه کاری 48GB | سرور استنتاج لبه برجی/2U |
32B–70B (کوانتیزیشن FP8) | 40–80GB | RTX PRO 6000 ×1–2 یا H200 ×1 | سرور GPU بشکل 2U/4U |
70B FP16 / متن طولانی | ~140GB+ | H200 ×1 (بهسختی) یا ×2 (مطمئن) | سرور چندکارته 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (حاشیه ~130GB) | سرور 4U با خنککاری مایع |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 یا B300 ×4 | سامانه SXM هشتکارته |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (مجموعاً 2.3TB حافظه ویدئویی) | سامانه پرچمدار هشتکارته با خنککاری مایع |
جدول 2: تناظر اندازه مدل با پیکربندی سرور (وزنها بر اساس checkpointهای رسمی؛ در استقرار واقعی باید KV Cache و سربار زمان اجرا را نیز افزود)
این جدول همچنین توضیح میدهد چرا شاسی 4U «نقطه مطلوب» سرورهای هوش مصنوعی است: 8 کارت دواسلات، منابع تغذیه افزونه و مجاری هوای خنککاری کافی — فقط فضای 4U میتواند هر سه را همزمان جا دهد. فرمت 2U برای گرههای استنتاج 2 تا 4 کارته مناسب است و 1U فقط یک کارت را جا میدهد یا بهعنوان گره جلویی زمانبندی/ذخیرهسازی به کار میرود.
خنککاری هوایی یا مایع؟ مشخصات حرارتی و رک چگونه تعیین میشود؟
پاسخ کوتاه: زیر 700W برای هر کارت، خنککاری هوایی کافی است؛ بالای 1000W برای هر کارت — یا بیش از 20kW برای هر رک — خنککاری مایع از «امتیاز اضافه» به «شرط سخت» تبدیل میشود. TDP حدود 1400W مدل B300 عملاً خنککاری مایع را تحمیل میکند.
ترتیب درست انتخاب این است: ابتدا مدل و GPU، سپس توان کل ماشین، و تنها پس از آن محاسبه معکوس خنککاری و شرایط اتاق سرور. بسیاری از شرکتها برعکس عمل میکنند — ابتدا ماشین میخرند و بعد میفهمند برق و تهویه جواب نمیدهد و ناچار به کاهش فرکانس میشوند؛ گویی با قیمت کامل یک GPU «اخته» خریدهاند. پیش از خرید حتماً سه مورد را تأیید کنید: برق رک (kW)، دما و حجم هوای ورودی، و حاشیه ارتقا برای 2 تا 3 نسل آینده GPU (پس از B300 مقادیر TDP فقط بالاتر میروند).
شکل 2: استنتاج تا 2030 از آموزش پیشی گرفته و بار غالب مراکز داده هوش مصنوعی میشود (تصویرسازی روند؛ منابع داده در پیوست)
اجاره ابری یا ساخت اختصاصی؟ حساب و کتاب هزینه چگونه است؟
پاسخ کوتاه: با بهرهبرداری زیر 60 درصد اجاره ابری بهصرفه است و با بار بالای پایدار، ساخت اختصاصی. با نرخهای اوت 2026، اجاره ابری H200 حدود 4.4 بهازای GPU·ساعت است — یعنی حدود38 هزار برای یک سال کامل با بار کامل، رقمی نزدیک به هزینه خرید یک کارت. هرچه بهرهبرداری بالاتر، بازگشت سرمایه ساخت اختصاصی سریعتر.
به حساب ساخت اختصاصی باید سه قلم دیگر هم افزود: برق اتاق سرور و بهرهبرداری خنککاری (حدود 20 تا 30 درصد هزینه کل مالکیت)، استهلاک ناشی از نسلهای GPU (H100 در 2026 از قبل بهطور عمیق افت قیمت داشته — ریسک ارزش باقیمانده واقعی است) و انطباق دادهها — مشتریان مالی، درمانی و دولتی نمیتوانند داده را از شبکه داخلی خارج کنند، پس استقرار خصوصی برایشان انتخاب نیست، الزام است. معماری ترکیبی در حال فراگیر شدن است: اوج آموزش در ابر، استنتاج دائمی در محل.
ChangFan: سرورهای GPU و سختافزار هوش مصنوعی آماده برای عصر استنتاج
در نهایت، انتخاب سرور هوش مصنوعی نه در جدول مشخصات که در «تطابق پیکربندی با سناریو» برده میشود. شرکت Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) سرورهای GPU رکمونت و سامانههای استنتاج هوش مصنوعی در فرمفاکتورهای 1U/2U/4U ارائه میکند، با پشتیبانی از توسعه چندکارته، منابع تغذیه افزونه و طراحی دمای گسترده. تعداد GPU، پیکربندی حافظه ویدئویی و طرح خنککاری (هوایی/مایع) را میتوان بر اساس اندازه مدل هدف سفارشی کرد — بستر سختافزاری پایدار و قابلاعتماد برای استقرار خصوصی مدلهای زبانی بزرگ، گرههای استنتاج لبه و پایگاههای دانش سازمانی.
اگر در حال ارزیابی خرید و استقرار سرورهای GPU کلاس H200/B200/B300 یا RTX PRO 6000 هستید، برای مشاوره پیکربندی و پیشنهاد سامانه کامل متناسب با مدل هدف خود با ChangFan تماس بگیرید (ما سختافزار میفروشیم و سامانه کامل میسازیم — خدمات اشتراک نرمافزار ارائه نمیدهیم).
پرسشهای متداول (FAQ)
س1: حداقل پیکربندی برای اجرای یک مدل زبانی بزرگ 70B چیست؟ ج: در FP16 به حدود 140GB حافظه ویدئویی نیاز است، پس یک کارت H200 اقتصادیترین پاسخ است؛ پس از کوانتیزیشن FP8، دو کارت RTX PRO 6000 (96GB×2) نیز با هزینه کمتر و انعطاف استقرار بیشتر از پس کار برمیآیند.
س2: B300 در چه از B200 بهتر است و ارزش صبر کردن دارد؟ ج: B300 حافظه ویدئویی 50 درصد بیشتری دارد (288GB در برابر 192GB) و توان FP4 آن 1.5 برابر است، اما پهنای باند یکسان است و TDP به حدود 1400W رسیده که خنککاری مایع میخواهد. ارتقا فقط وقتی ارزش دارد که مدل یا KV Cache از ظرفیت گره B200 فراتر رود.
س3: شرکتهای کوچک و متوسط برای اولین سرور هوش مصنوعی از چه شروع کنند؟ ج: ابتدا مدلی را که میخواهید اجرا کنید مشخص کنید. برای کاربردهای سطح 7B–14B (پشتیبانی مشتری، پایگاه دانش، کنترل کیفیت) یک سرور استنتاج 2U تککارته برای شروع کافی است؛ پس از اثبات بار بالای پایدار به 4U چندکارته ارتقا دهید.
س4: آیا خنککاری مایع برای سرورهای هوش مصنوعی اجباری است؟ ج: خیر. زیر 700W برای هر کارت و با شرایط خوب اتاق سرور، هوا کافی است؛ مایع فقط بالای 1000W برای هر کارت یا در استقرارهای چند رکی متراکم لازم است. هنگام انتخاب، برای روند توان 2 تا 3 نسل آینده GPU حاشیه بگذارید.
س5: GPU ابری اینقدر ارزان است — چرا سرور شخصی بخریم؟ ج: سه دلیل — بالای حدود 60 درصد بهرهبرداری، ساخت اختصاصی ارزانتر است؛ دادههای حساس اجازه خروج از شبکه داخلی را ندارند؛ استنتاج محلی تأخیر شبکه ندارد و SLA در دست خود شماست. بیشتر سازمانها سرانجام به معماری ترکیبی «آموزش در ابر، استنتاج در محل» میرسند.