ظهور هوش مصنوعی لبه (Edge AI): چرا مدلهای کوچک، پردازش را از فضای ابری بازمیگردانند
پاسخ کوتاه: هوش مصنوعی لبه یعنی اجرای استنتاج مدل مستقیماً روی سختافزار محلی یا دستگاهِ نزدیک به محل تولید داده، بدون ارسال به ابر. مدلهای کوچک (SLMها) مدلهای زبانی فشرده (معمولاً ۱ تا ۱۴ میلیارد پارامتر) هستند که برای اجرای کارآمد روی این سختافزار طراحی شدهاند. ترکیب این دو به سازمانها اجازه میدهد استنتاج هوش مصنوعی را با تأخیر ۵۰ تا ۲۰۰ میلیثانیهای، بدون اتکا به اتصال شبکه، در محل اجرا کنند — با حفظ حاکمیت کامل داده و کاهش هزینههای استنتاج تا ۷۵ درصد نسبت به APIهای ابری.
این شیفتی ساختاری است، نه یک ترند گذرا.
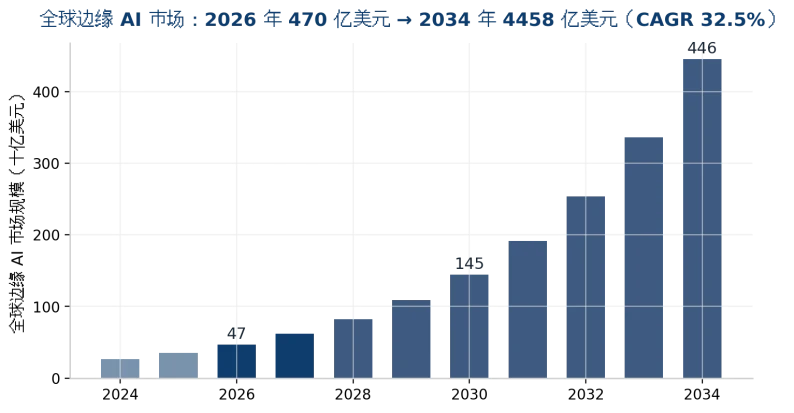
گارتنر پیشبینی میکند تا پایان ۲۰۲۷، ۴۰ درصد از سازمانها از هوش مصنوعی لبه برای پردازش دادههای حساس در محیطهای عملیاتی خود استفاده خواهند کرد — در حالی که این رقم در ۲۰۲۳ کمتر از ۵ درصد بود. دلیلش ترکیبی از فشارهای اقتصادی، انضباطی و فنی است که هماکنون همگرا شدهاند.
این مقاله به سه سؤال کلیدی پاسخ میدهد: چرا مدلهای کوچک ناگهان بهاندازه کافی خوب شدهاند؛ استقرار هوش مصنوعی لبه چه مشکلات واقعیای را حل میکند؛ و سازمانها در ۲۰۲۶ برای توسعه هوش مصنوعی لبه به چه سختافزاری نیاز دارند.
سه رانش ساختاری همگرا
رانش اول اقتصادی است: هزینه استنتاج ابری بهشدت متغیر و غیرقابل پیشبینی است. رانش دوم انضباطی است: مقرراتی مانند GDPR، HIPAA و قوانین محلیسازی داده چین، ارسال دادههای حساس به زیرساخت ابری خارجی را برای بسیاری از سازمانها دشوار یا ناممکن کردهاند. رانش سوم فنی است: مدلهای کوچک اکنون میتوانند بسیاری از وظایفی را انجام دهند که تا دو سال پیش به LLMهای غولپیکر نیاز داشت.
این سه رانش یک پنجره استقرار ایجاد کردهاند که نه فقط برای غولهای فناوری، بلکه برای کسبوکارهای کوچک و متوسط نیز باز است.
مدلهای کوچک در برابر مدلهای بزرگ: چه چیزی واقعاً تغییر کرد
برچسب «کوچک» در SLM گمراهکننده است. در ۲۰۲۶، یک مدل ۷ تا ۱۴ میلیارد پارامتری «کوچک» محسوب میشود — اما Phi-4 مایکروسافت با ۱۴ میلیارد پارامتر در بنچمارک GSM8K ریاضی به ۹۴ درصد دقت میرسد، در حالی که GPT-5 به ۸۷ درصد میرسد. این یک استثنا نیست: در حوزههای تخصصی با دادههای ساختیافته، مدلهای کوچکِ فاینتیونشده بهطور مداوم از مدلهای عمومیِ صدها برابر بزرگتر بهتر عمل میکنند.
دلیلش ساده است: آموزش خاص دامنه. یک مدل کوچک که روی مستندات پزشکی، قراردادهای حقوقی یا گزارشهای نگهداری تجهیزات آموزش دیده، در آن دامنه از یک مدل عمومی غولپیکر دقیقتر است — چون نویز کمتری برای فیلتر کردن دارد.
برای استقرار لبه، این یعنی: مدل بهاندازه کافی کوچک است که روی یک جتسون تور یا رایانه صنعتی اجرا شود؛ پاسخها بهاندازه کافی سریع هستند که کاربردهای بلادرنگ پشتیبانی شوند؛ و هزینه هر استنتاج یکدهم تا یکسیاُمِ یک فراخوان API ابری است.
در عین حال، مدلهای کوچک همهکاره نیستند. در استدلال پیچیده چندمرحلهای، تولید محتوای طولانی و وظایفی که به دانش عمومی گسترده نیاز دارند، مدلهای بزرگ همچنان برتری دارند. به همین دلیل آینده، ترکیبی است — نه جایگزینی.
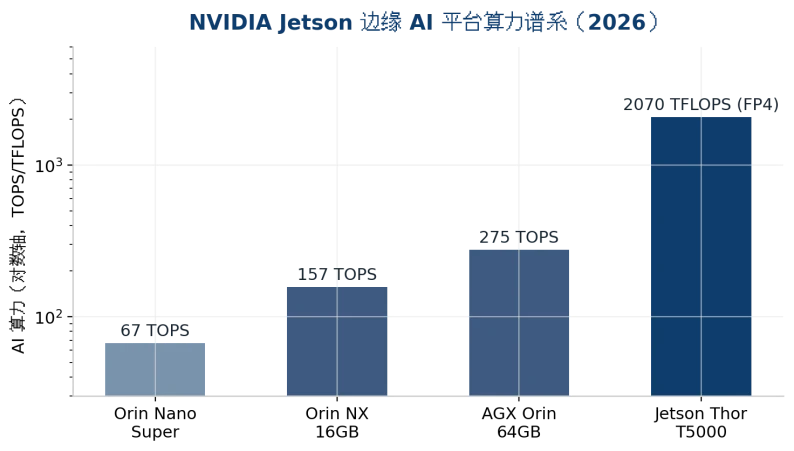
رده سختافزاری | پلتفرمهای نماینده | توان (TOPS) | RAM توصیهشده | مصرف برق |
قیمت تقریبی | کاربرد اصلی | فشرده / ورودی | Jetson Orin Nano / NUC | ۶۷ ترااوپس |
۸ تا ۱۶ گیگابایت | ۱۵ تا ۳۰ وات | ۴۰۰ تا ۸۰۰ دلار | حسگرها، دوربینها | میانرده صنعتی |
Jetson AGX Orin / IPC | ۱۵۷ تا ۲۷۵ ترااوپس | ۳۲ تا ۶۴ گیگابایت | ۳۰ تا ۱۰۰ وات | ۱٬۵۰۰ تا ۵٬۰۰۰ دلار |
بازرسی بصری، رباتیک | بالارده / حرفهای | Jetson Thor / RTX 5090 | ۲۰۷۰ ترافلاپس FP4 | ۴۸ گیگابایت و بالاتر |
۳۰۰ تا ۷۰۰ وات | ۴٬۶۹۹ دلار و بالاتر | هوش مصنوعی فیزیکی، استنتاج سنگین | سازمانی / دیتاسنتر لبه | RTX 6000 Ada / H100 |
معماری ترکیبی در عمل
هوش مصنوعی ترکیبی به این معناست که مدلهای کوچکِ محلی، جمعآوری داده، پیشپردازش، وظایف بلادرنگ و پاسخهای اولیه را انجام میدهند، در حالی که LLMهای ابری برای استدلال پیچیده، جستوجوی دانش و کارهای تولیدی استفاده میشوند. این معماری مزایای هر دو را حفظ میکند: تأخیر پایین و حاکمیت داده در لبه، قدرت محاسباتی بالا در ابر.
تحقیقات نشان میدهد ۸۰ تا ۹۵ درصد از بارهای کاری استنتاج تولیدی را میتوان با مدلهای کوچک در لبه انجام داد، و فقط ۵ تا ۲۰ درصد واقعاً به مدلهای ابری بزرگ نیاز دارند. AT&T با مسیریابی هوشمند، هزینه استنتاج را ۹۰ درصد کاهش داد و سرعت پاسخ را ۷۰ درصد افزایش داد — با فرستادن فقط کوئریهای پیچیده به مدلهای بزرگ.
استقرار خصوصی: حاکمیت داده بهعنوان مزیت رقابتی
برای تولید، انرژی، حملونقل و خدمات مالی، استقرار خصوصی هوش مصنوعی فقط یک نیاز انضباطی نیست — یک مزیت رقابتی است. وقتی مدل داخل شبکه سازمان اجرا میشود، دادهها هرگز خارج نمیشوند: نه برای آموزش، نه برای پردازش. این ریسک نشت داده، نقض قراردادهای محرمانگی و وابستگی به ارائهدهنده را از بین میبرد.
از منظر هزینه نیز جذاب است: یک استقرار لبه با یک بار سرمایهگذاری سختافزاری انجام میشود و بعد هزینه هر استنتاج تقریباً صفر است — در حالی که APIهای ابری با هر فراخوان هزینه دارند. برای کاربردهای پرتکرار (بازرسی بصری، مانیتورینگ تجهیزات، پردازش اسناد)، سربرگ هزینه ظرف چند ماه مشخص میشود.
رونق هوش مصنوعی فیزیکی
هوش مصنوعی فیزیکی — یعنی هوش مصنوعی که روی رباتها، خودروها و تجهیزات صنعتی اجرا میشود — به سختافزار لبه نیاز دارد، چون تصمیمات فیزیکی نمیتوانند منتظر رفتوبرگشت ابری بمانند. یک بازوی رباتیک که در ۵۰ میلیثانیه باید واکنش نشان دهد، نمیتواند به یک API ابری با تأخیر ۲۰۰ میلیثانیه اعتماد کند.
این همان جایی است که رایانههای صنعتی وارد میشوند: برخلاف لپتاپهای مصرفی، آنها برای کارکرد ۲۴/۷ در محیطهای سخت ساخته شدهاند — دمای −۲۵ تا ۷۰ درجه سانتیگراد، بدون فن، ضد گرد و غبار و لرزش. این ویژگیها برای هوش مصنوعی فیزیکی اختیاری نیستند.
سختافزار هوش مصنوعی لبه: راهنمای خرید ۲۰۲۶
ChangFan Industrial Computing راهحلهای سختافزاری هوش مصنوعی لبه را برای محیطهای تولید، انرژی و حملونقل ارائه میدهد.
سؤال کلیدی در انتخاب سختافزار لبه این است: کدام مدل را میخواهید اجرا کنید، با چه نرخ استنتاجی؟
برای مدلهای ۷ تا ۱۴ میلیارد پارامتری (Phi-4، Mistral، Llama 3.x کوانتیزهشده)، یک NVIDIA Jetson AGX Orin (۶۷ ترااوپس) یا Jetson Thor (۱۵۷ تا ۲۷۵ ترااوپس) کافی است. برای استنتاج سنگینتر با مدلهای ۳۰ تا ۷۰ میلیارد پارامتری، به یک ایستگاه کاری با GPU مصرفی رده بالا (RTX 5090، ۲۰۷۰ ترافلاپس FP4) یا یک GPU دیتاسنتری فشرده (RTX 6000 Ada، حدود ۱ پتابراگ FP4) نیاز دارید.
RAM مهم است: مدلهای ۷ میلیارد پارامتری کوانتیزهشده به ۸ تا ۱۶ گیگابایت، مدلهای ۱۴ میلیاردی به ۳۲ تا ۴۸ گیگابایت، و مدلهای ۷۰ میلیاردی کوانتیزهشده به ۹۶ گیگابایت یا بیشتر نیاز دارند. حافظه کم، گلوگاه اصلی بسیاری از استقرارهای لبه است.
برای محیطهای سخت (کف کارخانه، فضای باز، وسایل نقلیه)، رایانههای صنعتی بدون فن با محدوده دمایی گسترده (−۲۵ تا ۷۰ درجه سانتیگراد) و منبع تغذیه صنعتی الزامی هستند. سختافزار مصرفی در این شرایط ظرف چند ماه خراب میشود.
کاربردهای عملی بر اساس صنعت
تولید: بازرسی بصری بلادرنگ روی خط تولید، نگهداری پیشبینانه با تحلیل لرزش و صدا، بهینهسازی پارامترهای فرایند. مزیت لبه: تصمیمات توقف خط در میلیثانیه، نه ثانیه.
انرژی و زیرساخت: مانیتورینگ تجهیزات در مکانهای دورافتاده بدون پوشش شبکه قابل اعتماد، تشخیص ناهنجاری در زیرایستگاهها، پیشبینی خرابی توربین. مزیت لبه: عملکرد مستقل از اتصال اینترنت.