엣지 AI의 부상: 소형 모델이 클라우드에서 컴퓨팅을 다시 가져오는 이유
- 광저우 창판 지능형 기술 유한회사
- 2026-10-12
한 줄 답변: 엣지 AI란 클라우드로 보내지 않고 로컬 하드웨어 또는 데이터가 생성되는 위치 근처의 디바이스에서 모델 추론을 직접 실행하는 것을 의미합니다. 소형 모델(SLM)은 이 하드웨어에서 효율적으로 실행되도록 설계된 컴팩트한 언어 모델(일반적으로 10억~140억 파라미터)입니다. 이 둘의 조합으로 조직은 네트워크 연결에 의존하지 않고 50~200밀리초의 지연 시간으로 로컬에서 AI 추론을 실행할 수 있으며, 완전한 데이터 주권을 유지하면서 클라우드 API 대비 추론 비용을 최대 75% 절감할 수 있습니다.
이것은 일시적인 트렌드가 아닌 구조적 전환입니다.
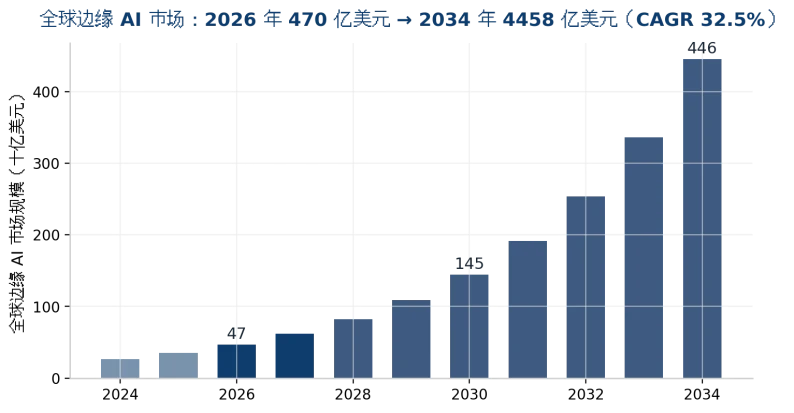
가트너는 2027년 말까지 40%의 조직이 운영 환경에서 민감한 데이터를 처리하기 위해 엣지 AI를 사용할 것으로 전망합니다 — 2023년에는 이 비율이 5% 미만이었습니다. 그 이유는 경제적, 규제적, 기술적 압력의 수렴입니다.
이 글은 세 가지 핵심 질문에 답합니다: 소형 모델이 갑자기 충분히 좋아진 이유는 무엇인가; 엣지 AI 도입이 해결하는 실제 문제는 무엇인가; 그리고 2026년에 엣지 AI를 배포하려면 조직에 어떤 하드웨어가 필요한가.
세 가지 구조적 동인의 수렴
첫 번째 동인은 경제적입니다: 클라우드 추론 비용은 매우 가변적이고 예측할 수 없습니다. 두 번째 동인은 규제적입니다: GDPR, HIPAA, 중국의 데이터 현지화 법률과 같은 규정으로 인해 많은 조직이 민감한 데이터를 외부 클라우드 인프라로 보내는 것이 어렵거나 불가능해졌습니다. 세 번째 동인은 기술적입니다: 소형 모델은 이제 2년 전만 해도 거대 LLM이 필요했던 많은 작업을 수행할 수 있습니다.
이 세 가지 동인은 기술 대기업뿐만 아니라 중소기업에도 열린 도입의 창을 만들었습니다.
소형 모델 대 대형 모델: 실제로 무엇이 바뀌었는가
SLM의 「소형」이라는 라벨은 오해의 소지가 있습니다. 2026년에는 70억~140억 파라미터 모델이 「소형」으로 간주됩니다 — 그러나 140억 파라미터의 마이크로소프트 Phi-4는 GSM8K 수학 벤치마크에서 94%의 정확도를 달성한 반면 GPT-5는 87%에 그칩니다. 이것은 예외가 아닙니다: 구조화된 데이터를 가진 전문 도메인에서 파인튜닝된 소형 모델은 수백 배 더 큰 범용 모델을 지속적으로 능가합니다.
이유는 간단합니다: 도메인 특화 학습. 의료 문서, 법률 계약서 또는 장비 유지보수 보고서로 학습된 소형 모델은 해당 도메인에서 대형 범용 모델보다 정확합니다 — 필터링할 노이즈가 적기 때문입니다.
엣지 배포의 경우 이는 다음을 의미합니다: 모델이 Jetson Thor나 산업용 컴퓨터에서 실행될 만큼 작고; 응답이 실시간 애플리케이션을 지원할 만큼 빠르며; 추론당 비용이 클라우드 API 호출의 10분의 1에서 30분의 1 수준입니다.
동시에 소형 모델은 만능이 아닙니다. 복잡한 다단계 추론, 장문 콘텐츠 생성, 광범위한 일반 지식이 필요한 작업에서는 대형 모델이 여전히 우위에 있습니다. 그래서 미래는 하이브리드입니다 — 대체가 아닙니다.
하드웨어 등급 | 대표 플랫폼 | 성능 (TOPS) | 권장 RAM | 전력 소비 |
예상 가격 | 주요 용도 | 컴팩트 / 엔트리급 | Jetson Orin Nano / NUC | 67 TOPS |
8~16GB | 15~30W | 400~800달러 | 센서, 카메라 | 중급 산업용 |
Jetson AGX Orin / IPC | 157~275 TOPS | 32~64GB | 30~100W | 1,500~5,000달러 |
비전 검사, 로봇공학 | 고급 / 전문가급 | Jetson Thor / RTX 5090 | 2070테라플롭스 FP4 | 48GB 이상 |
300~700W | 4,699달러 이상 | 피지컬 AI, 고강도 추론 | 엔터프라이즈 / 엣지 데이터센터 | RTX 6000 Ada / H100 |
실무에서의 하이브리드 아키텍처
하이브리드 AI란 로컬 소형 모델이 데이터 수집, 전처리, 실시간 작업 및 초기 응답을 처리하고, 클라우드 LLM은 복잡한 추론, 지식 검색 및 창의적 작업에 사용되는 것을 의미합니다. 이 아키텍처는 양쪽의 장점을 모두 유지합니다: 엣지에서의 낮은 지연 시간과 데이터 주권, 클라우드에서의 높은 컴퓨팅 파워.
연구에 따르면 프로덕션 추론 워크로드의 80~95%는 엣지의 소형 모델로 수행할 수 있으며, 실제로 대형 클라우드 모델이 필요한 것은 5~20%에 불과합니다. AT&T는 스마트 라우팅을 통해 추론 비용을 90% 절감하고 응답 속도를 70% 높였습니다 — 복잡한 쿼리만 대형 모델로 보내어.
프라이빗 배포: 경쟁 우위로서의 데이터 주권
제조, 에너지, 운송 및 금융 서비스의 경우 프라이빗 AI 배포는 단순한 규제 요건이 아닙니다 — 경쟁 우위입니다. 모델이 조직의 내부 네트워크 내에서 실행되면 데이터는 절대 외부로 나가지 않습니다: 학습용으로도, 처리용으로도. 이는 데이터 유출, 기밀 유지 계약 위반 및 벤더 종속의 위험을 제거합니다.
비용 관점에서도 매력적입니다: 엣지 배포는 한 번의 하드웨어 투자로 이루어지며 이후 추론당 비용은 거의 0입니다 — 클라우드 API는 호출할 때마다 비용이 발생합니다. 빈번한 반복 애플리케이션(비전 검사, 장비 모니터링, 문서 처리)의 경우 몇 달 내에 비용 차이가 명확해집니다.
피지컬 AI의 부상
피지컬 AI — 즉 로봇, 차량 및 산업 장비에서 실행되는 AI — 는 엣지 하드웨어를 요구합니다. 물리적 결정은 클라우드 왕복을 기다릴 수 없기 때문입니다. 50밀리초 내에 반응해야 하는 로봇 팔은 200밀리초 지연의 클라우드 API에 의존할 수 없습니다.
여기서 산업용 컴퓨터가 등장합니다: 소비자용 노트북과 달리 혹독한 환경에서 24/7 작동을 위해 제작되었습니다 — 영하 25도에서 영상 70도의 온도, 팬리스, 방진 및 내진. 이러한 기능은 피지컬 AI에 선택 사항이 아닙니다.
엣지 AI 하드웨어: 2026년 구매 가이드
ChangFan Industrial Computing은 제조, 에너지 및 운송 환경을 위한 엣지 AI 하드웨어 솔루션을 제공합니다.
엣지 하드웨어 선택의 핵심 질문은 다음과 같습니다: 어떤 모델을, 어떤 추론 속도로 실행하고 싶은가?
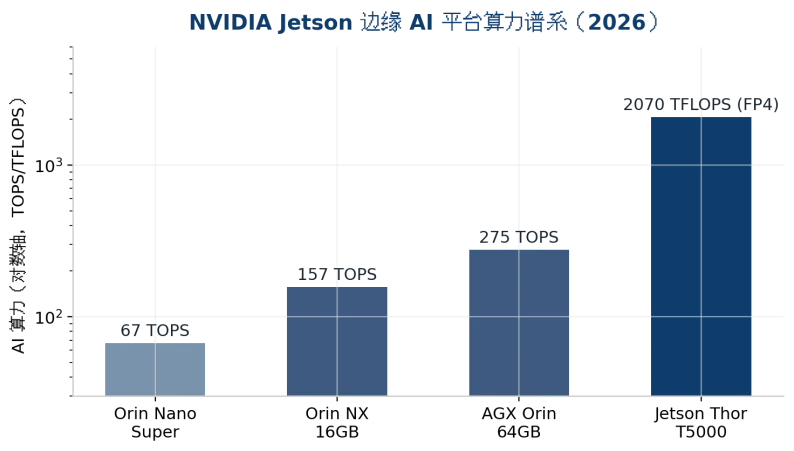
70억~140억 파라미터 모델(Phi-4, Mistral, 양자화된 Llama 3.x)의 경우 NVIDIA Jetson AGX Orin(67 TOPS) 또는 Jetson Thor(157~275 TOPS)로 충분합니다. 300억~700억 파라미터 모델로 더 무거운 추론을 하려면 고급 소비자용 GPU를 탑재한 워크스테이션(RTX 5090, 2070테라플롭스 FP4) 또는 컴팩트 데이터센터 GPU(RTX 6000 Ada, 약 1페타플롭 FP4)이 필요합니다.
RAM이 중요합니다: 양자화된 70억 파라미터 모델은 8~16GB, 140억 모델은 32~48GB, 양자화된 700억 모델은 96GB 이상이 필요합니다. 부족한 메모리는 많은 엣지 배포의 실제 병목입니다.
혹독한 환경(공장 현장, 옥외, 차량)의 경우 넓은 온도 범위(영하 25도~영상 70도)와 산업용 전원을 갖춘 팬리스 산업용 컴퓨터가 필수입니다. 소비자용 하드웨어는 이러한 조건에서 몇 달 내에 고장 납니다.
산업별 실용적인 적용 사례
제조: 생산 라인에서의 실시간 비전 검사, 진동 및 소리 분석을 통한 예측 유지보수, 공정 파라미터 최적화. 엣지의 장점: 초가 아닌 밀리초 단위의 라인 정지 결정.
에너지 및 인프라: 신뢰할 수 있는 네트워크 커버리지가 없는 원격지의 장비 모니터링, 변전소의 이상 감지, 터빈 고장 예측. 엣지의 장점: 인터넷 연결과 무관한 운영.