A Ascensão da Edge AI: Porque é que os Pequenos Modelos Estão a Trazer o Processamento de Volta da Nuvem
Introdução: o centro de gravidade da IA desloca-se da nuvem para a borda
Nos últimos três anos, a postura padrão das empresas em relação à IA era «chamar uma API na nuvem». Em 2026, essa postura está a ser reescrita: a Gartner prevê que até 2027 40% das cargas de trabalho de IA das empresas migrarão dos grandes modelos na nuvem para os modelos de linguagem pequenos (SLM); as estatísticas do setor mostram que 73% das organizações transferem a inferência para ambientes de borda por eficiência energética; e o mercado global de IA de borda deverá crescer de 46,96 mil milhões de dólares em 2026 para 445,75 mil milhões de dólares em 2034, com um CAGR de 32,5%. O centro de gravidade da computação regressa das «salas de máquinas distantes» para «onde nascem os dados».
O que impulsiona essa migração não é o ânimo, mas três contas: a conta de custos (a inferência com modelos pequenos pode reduzir os custos em até 75%), a conta da latência (50–200 milissegundos localmente, a ida e volta à nuvem não consegue acompanhar) e a conta da privacidade (os dados não saem da fábrica, do hospital, da rede interna). As três contas são exatamente o território natural dos fabricantes de hardware.
O que é IA de borda? Em que ela difere fundamentalmente da IA na nuvem?
Resposta rápida: a IA de borda executa a inferência do modelo em dispositivos locais próximos a sensores, máquinas e usuários, em vez de enviar os dados para a nuvem e esperar o resultado de volta. A diferença essencial: os dados ficam parados, quem se move é o modelo.
Os «dados parados» trazem três vantagens estruturais: primeiro, a latência comprime-se de «ida e volta pela rede + fila» para o tempo de cálculo puro — a inspeção visual industrial pode chegar a 50 milissegundos; segundo, o funcionamento offline: AGVs, inspeções de campo e plataformas marítimas não «ficam burros» quando a rede oscila; terceiro, os dados sensíveis permanecem locais do início ao fim, atendendo naturalmente aos requisitos de conformidade de saúde, finanças e setor público. A IA na nuvem continua adequada para treinamento em grande escala e picos elásticos, mas a «última milha» da inferência acontece cada vez mais na borda.
Por que os modelos pequenos (SLM) podem assumir o protagonismo em 2026?
Resposta rápida: porque os modelos «suficientes» ficaram mais baratos em mais de uma ordem de grandeza — servir um SLM de classe 7B custa 10–30 vezes menos do que os grandes modelos 70B–175B, os gastos combinados de GPU + nuvem + energia podem cair até 75%, e ele resolve com folga 80–90% das tarefas empresariais.
Três fatos emblemáticos: o Phi-4 da Microsoft, com 14B parâmetros, aproxima-se do DeepSeek R1 de 671B em raciocínio matemático; um SLM jurídico de 7B atingiu 94% de precisão na revisão de contratos, superando os 87% do GPT-5; no início de 2026, a AT&T migrou o atendimento automatizado ao cliente para um cluster de modelos Mistral/Phi ajustados, reduzindo os custos mensais de API em 90% e melhorando a velocidade de resposta em 70%. A arquitetura padrão das empresas torna-se «híbrida» — o SLM processa 80–95% das solicitações rotineiras, o raciocínio complexo é roteado para o LLM na nuvem. A previsão da Gartner é ainda mais direta: até 2027, as empresas usarão modelos pequenos especializados por tarefa 3 vezes mais do que os grandes modelos generalistas.
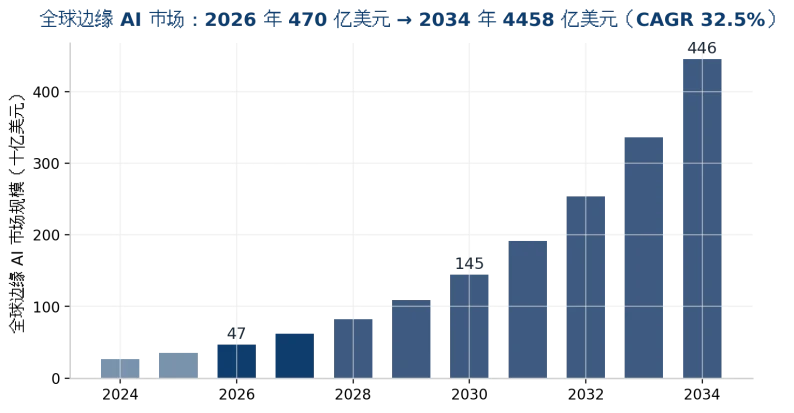
Figura 1: previsão do mercado global de IA de borda (2026–2034, fontes de dados no anexo)
Como escolher o hardware de IA de borda?
Resposta rápida: selecionar por dois eixos — «tamanho do modelo + condições do ambiente»: para visão/NLP leve abaixo de 7B, módulos embarcados de classe Jetson ou mini PCs com NPU; para 7B–70B, PC industrial x86 + uma/duas GPUs; para robôs humanoides e grandes modelos multimodais, plataforma de classe Jetson Thor.
Nível de plataforma | Plataforma representativa | Potência de computação IA | Consumo | Cenários típicos |
Borda leve | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Inspeção visual de um/dois canais, OCR, câmaras inteligentes |
Borda de gama média | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Controle de qualidade multicanal, AGV/AMR, visão de braços robóticos |
Borda topo de gama | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Robôs humanoides, LLM na borda, multimodal |
PC industrial x86 + GPU | PC industrial + RTX PRO 6000 (96 GB) | FP4 de classe de uma placa | Sistema completo 300-700 W | Base de conhecimento privada de fábrica, inferência de classe 70B, cargas mistas de visão + linguagem |
Caixa de IA de secretária | Estação de IA de memória unificada (classe 128 GB) | ~1 PFLOP (FP4) | 150-300 W | Desenvolvimento e depuração, assistente privado em nível de departamento (preço de referência 4 699 $) |
Tabela 1: comparação por níveis das plataformas de hardware de IA de borda (2026; as cifras de computação usam métricas diferentes e não são diretamente comparáveis entre linhas — apenas como referência de seleção)
O que se subestima com facilidade são os indicadores ambientais: temperatura, poeira, vibração e flutuações de tensão na fábrica — os dispositivos de consumo não suportam. A seleção industrial deve verificar a ampla faixa de temperatura (classe de -25 °C a 70 °C), o design sem ventoinha/antivibração, o MTBF em operação contínua 7×24 e a correspondência das E/S (GbE múltiplos, PoE, CAN, portas seriais) com a linha existente.
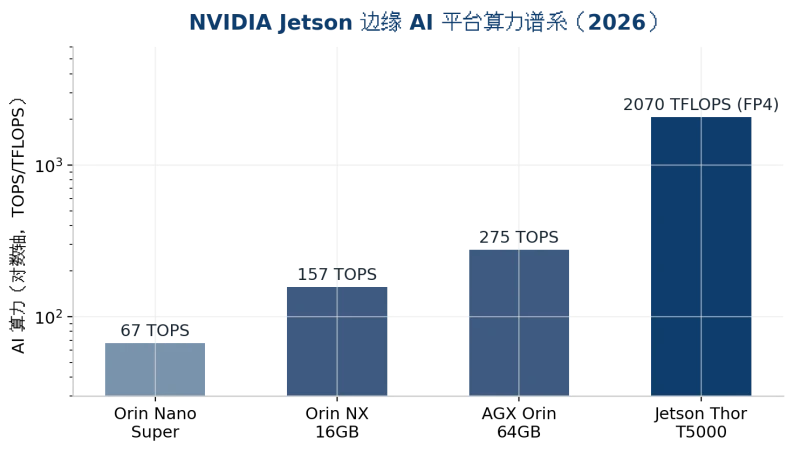
Figura 2: gama de potência de computação das plataformas Jetson para IA de borda (eixo logarítmico, 2026)
Quais cenários exigem IA de borda?
▪Controle de qualidade industrial e manutenção preditiva: o takt da linha mede-se em milissegundos, e manter as imagens de defeitos dentro da fábrica é ao mesmo tempo velocidade e sigilo.
▪AGV/AMR e robótica: em movimento a rede não é confiável; o desvio de obstáculos e o planeamento de rotas devem ocorrer localmente em tempo real.
▪Saúde e finanças: prontuários, imagens e dados de transações estão vinculados à conformidade — a implantação privada é o bilhete de entrada, não um bónus.
▪Energia e trabalhos de campo: plataformas marítimas, minas e inspeções de redes elétricas vivem o ano inteiro com rede fraca ou sem rede; a inteligência local é a única opção.
▪Redes de lojas e filiais: a matriz distribui os modelos, as lojas executam a inferência localmente — os custos de banda e a pressão do retorno de dados caem juntos.
ChangFan Industrial Computing: hardware de borda que instala os grandes modelos nas fábricas e nos armários
Tornar a IA de borda realidade depende metade do modelo e metade da «caixa onde o modelo vive». Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) oferece hardware de computação de borda do leve ao topo de gama: PCs industriais e box PCs embarcados de ampla faixa de temperatura e resistentes a vibrações, sistemas tudo-em-um de IA de borda com suporte a uma/duas GPUs, e servidores GPU 2U/4U para implantação privada em nível de departamento — compatíveis com as principais pilhas de inferência local Ollama, vLLM, OpenWebUI e ComfyUI, e personalizáveis para o ambiente da linha: ampla faixa de temperatura, sem ventoinha, múltiplas portas LAN e PoE.
Quer esteja a implementar um modelo de controle de qualidade de 7B ou uma base de conhecimento empresarial de 70B, a ChangFan Industrial Computing pode propor uma configuração completa segundo «escala do modelo × ambiente do local». Entre em contato para aconselhamento de seleção (soluções de hardware e sistemas completos; sem subscrição de software).
Perguntas frequentes (FAQ)
P1: Um modelo pequeno de 7B é realmente suficiente? R: É suficiente para 80–90% das tarefas repetitivas das empresas. Após o ajuste de domínio, os modelos de classe 7B atingem 94% de precisão em tarefas como a revisão de contratos; a prática comum é o SLM processar as solicitações rotineiras e rotear as perguntas complexas para o grande modelo na nuvem.
P2: Que hardware é preciso para executar um modelo 7B localmente? R: Após a quantização, cerca de 8–16 GB de VRAM/memória — basta um mini PC com NPU ou um dispositivo de classe Jetson Orin; para débito multiconcorrente, recomenda-se um PC industrial com uma GPU de 48 GB ou mais.
P3: IA de borda e implantação privada são a mesma coisa? R: Não exatamente. A implantação privada sublinha que os dados não saem da empresa (podem residir nos servidores do centro de dados); a IA de borda sublinha a computação perto da fonte dos dados (fábrica, loja, dispositivo). As duas sobrepoem-se com frequência: nós de borda + nuvem privada da empresa.
P4: Qual a diferença entre um PC industrial a executar IA e um computador de consumo? R: Ampla faixa de temperatura (classe de -25 °C a 70 °C), resistência a vibrações, proteção contra poeira, operação contínua 7×24, longo ciclo de fornecimento e interfaces industriais. As máquinas de consumo avariam muito mais em ambientes de linha — os custos ocultos ultrapassam em muito a diferença de preço.
P5: A IA de borda será substituída pelos grandes modelos na nuvem? R: Os dados do mercado respondem o contrário — o mercado de IA de borda cresce a um CAGR de 32,5% e as cargas de inferência continuam a migrar para o local. O futuro é uma divisão do trabalho «treinamento na nuvem, inferência na borda», não uma substituição.