Rozwój Edge AI: dlaczego małe modele przenoszą obliczenia z powrotem z chmury
Wprowadzenie: środek ciężkości AI przesuwa się z chmury na brzeg
Przez ostatnie trzy lata standardową postawą firm wobec AI było „wywołanie chmurowego API”. W 2026 roku ta postawa jest przepisywana: Gartner prognozuje, że do 2027 roku 40% korporacyjnych obciążeń AI przejdzie z dużych modeli chmurowych na małe modele językowe (SLM); statystyki branżowe pokazują, że 73% organizacji przenosi wnioskowanie do środowisk brzegowych dla efektywności energetycznej; a światowy rynek brzegowej AI ma urosnąć z 46,96 mld USD w 2026 roku do 445,75 mld USD w 2034 roku przy średniorocznym tempie wzrostu 32,5%. Środek ciężkości obliczeń wraca z „odległych serwerowni” tam, „gdzie rodzą się dane”.
Tę migrację napędza nie nastrój, lecz trzy rachunki: rachunek kosztów (wnioskowanie małych modeli może obniżyć koszty nawet o 75%), rachunek opóźnień (lokalne wnioskowanie — 50–200 milisekund, chmurowy roundtrip nie nadąża) i rachunek prywatności (dane nie opuszczają fabryki, szpitala, sieci wewnętrznej). Wszystkie trzy rachunki to dokładnie rodzime terytorium producentów sprzętu.
Czym jest brzegowa AI? Czym zasadniczo różni się od chmurowej?
Krótka odpowiedź: brzegowa AI wykonuje wnioskowanie modelu na lokalnych urządzeniach blisko czujników, maszyn i użytkowników, zamiast wysyłać dane do chmury i czekać na wynik z powrotem. Zasadnicza różnica: dane stoją w miejscu, porusza się model.
„Nieruchome dane” dają trzy strukturalne przewagi: po pierwsze, opóźnienie kurczy się z „sieciowego roundtripu + kolejki” do czystego czasu obliczeń — przemysłowa kontrola jakości wizji mieści się w 50 milisekundach; po drugie, praca offline: wózki AGV, inspekcje terenowe i platformy morskie nie „głupieją” przy drganiach sieci; po trzecie, wrażliwe dane przez cały czas pozostają lokalne, naturalnie spełniając wymogi zgodności w medycynie, finansach i sektorze publicznym. Chmurowa AI nadal nadaje się do bardzo dużego treningu i elastycznych szczytów, ale „ostatnia mila” wnioskowania coraz częściej odbywa się na brzegu.
Dlaczego małe modele (SLM) mogą w 2026 roku przejąć główną rolę?
Krótka odpowiedź: ponieważ „wystarczające” modele staniały o ponad rząd wielkości — obsługa SLM klasy 7B jest 10–30 razy tańsza niż dużych modeli 70B–175B, łączne wydatki na GPU, chmurę i energię można obniżyć nawet o 75%, a 80–90% zadań firmowych wykonuje z powodzeniem.
Trzy symboliczne fakty: Microsoft Phi-4 z 14B parametrów zbliża się do DeepSeek R1 z 671B w rozumowaniu matematycznym; prawniczy SLM 7B osiągnął 94% dokładności w weryfikacji umów, wyprzedzając GPT-5 z jego 87%; na początku 2026 roku AT&T przeniosła zautomatyzowaną obsługę klienta na klaster dostrojonych modeli Mistral/Phi, obniżając miesięczne koszty API o 90% i przyspieszając odpowiedzi o 70%. Standardowa architektura przedsiębiorstw staje się „hybrydowa” — SLM obsługuje 80–95% rutynowych zapytań, a złożone rozumowanie jest kierowane do chmurowego LLM. Prognoza Gartnera jest jeszcze prostsza: do 2027 roku przedsiębiorstwa będą używać wyspecjalizowanych małych modeli 3 razy częściej niż uniwersalnych dużych.
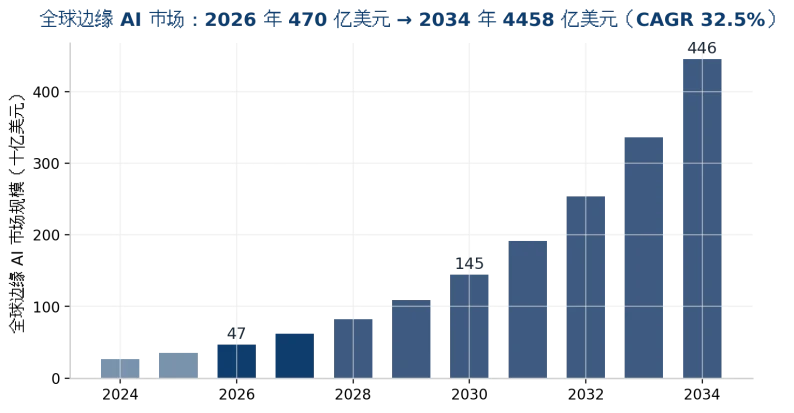
Rys. 1: Prognoza wielkości światowego rynku brzegowej AI (2026–2034, źródła danych — w załączniku)
Jak dobierać sprzęt do brzegowej AI?
Krótka odpowiedź: wybór według dwóch osi — „rozmiar modelu + warunki środowiska”: dla lekkiej wizji/NLP do 7B — moduły wbudowane klasy Jetson lub mini-PC z NPU; dla 7B–70B — komputer przemysłowy x86 + jeden/dwa GPU; dla robotów humanoidalnych i wielomodalnych dużych modeli — platforma klasy Jetson Thor.
Poziom platformy | Reprezentatywna platforma | Moc obliczeniowa AI | Pobór mocy | Typowe scenariusze |
Lekki brzeg | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Jedno-/dwukanałowa kontrola wizji, OCR, inteligentne kamery |
Średni brzeg | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Wielokanałowa kontrola jakości, AGV/AMR, wizja manipulatorów |
Flagowy brzeg | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Roboty humanoidalne, LLM na brzegu, wielomodalność |
x86 komputer przemysłowy + GPU | Komputer przemysłowy + RTX PRO 6000 (96 GB) | FP4 klasy jednej karty | Cały system 300-700 W | Prywatna baza wiedzy hali, wnioskowanie klasy 70B, mieszane obciążenia wizja + język |
Desktopowa skrzynka AI | Stacja AI z pamięcią ujednoliconą (klasa 128 GB) | ~1 PFLOP (FP4) | 150-300 W | Rozwój i debugowanie, prywatny asystent na poziomie działu (cena orientacyjna 4 699 USD) |
Tabela 1: Porównanie poziomów platform sprzętowych brzegowej AI (2026; wskaźniki mocy obliczeniowej mają różną metodologię i nie są bezpośrednio porównywalne między wierszami — tylko jako odniesienie przy wyborze)
Często niedoceniane są wskaźniki środowiskowe: temperatury, kurzu, wibracji i wahań napięcia w hali urządzenia konsumenckie nie wytrzymają. Przy wyborze do scenariuszy przemysłowych koniecznie sprawdź szeroki zakres temperatur (klasa -25 °C do 70 °C), konstrukcję bezwentylatorową/odporną na wibracje, MTBF przy pracy ciągłej 7×24 oraz dopasowanie interfejsów I/O (kilka GbE, PoE, CAN, porty szeregowe) do istniejącej linii.
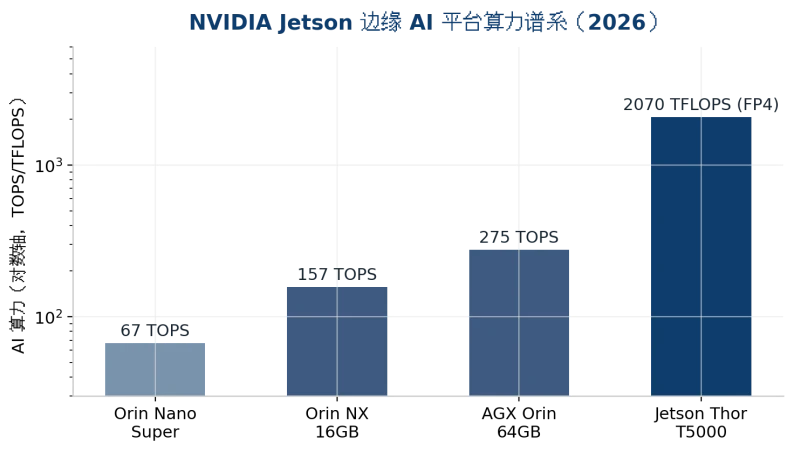
Rys. 2: Gama mocy obliczeniowej platform Jetson do brzegowej AI (skala logarytmiczna, 2026)
W jakich scenariuszach brzegowa AI jest obowiązkowa?
▪Przemysłowa kontrola jakości i konserwacja predykcyjna: takt linii mierzy się w milisekundach, a niewypuszczanie obrazów wad poza fabrykę to jednocześnie wymóg szybkości i tajności.
▪AGV/AMR i robotyka: w ruchu sieć jest zawodna; omijanie przeszkód i planowanie trasy muszą odbywać się lokalnie w czasie rzeczywistym.
▪Medycyna i finanse: historie chorób, obrazy i dane transakcyjne wiąże zgodność — prywatne wdrożenie jest biletem wstępu, a nie bonusem.
▪Energetyka i prace terenowe: platformy morskie, kopalnie i inspekcje sieci energetycznych przez cały rok żyją ze słabą siecią lub bez niej; lokalna inteligencja to jedyna opcja.
▪Sieci sklepów i oddziały: centrala spuszcza modele w dół, sklepy wykonują wnioskowanie lokalnie — koszty łącza i obciążenie zwrotnej transmisji danych spadają jednocześnie.
ChangFan Industrial Computing: sprzęt brzegowy, który umieszcza duże modele w hali i w szafie
Wdrożenie brzegowej AI to w połowie model, a w połowie „pudełko, w którym mieszka model”. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) oferuje sprzęt edge computing od lekkiego po flagowy: wbudowane komputery przemysłowe i box PC o szerokim zakresie temperatur i odporności na wibracje, brzegowe systemy AI typu all-in-one z obsługą jednego/dwóch GPU, a także serwery GPU 2U/4U do prywatnego wdrożenia na poziomie działu — kompatybilne z głównymi lokalnymi stosami wnioskowania Ollama, vLLM, OpenWebUI, ComfyUI i konfigurowalne pod warunki linii: szeroki zakres temperatur, konstrukcja bezwentylatorowa, kilka portów LAN i PoE.
Czy wdrażasz model kontroli jakości 7B, czy korporacyjną bazę wiedzy 70B, ChangFan Industrial Computing zaproponuje konfigurację całego systemu według formuły „skala modelu × warunki obiektu”. Zapraszamy do kontaktu w sprawie doradztwa doboru (rozwiązania sprzętowe i systemy kompletne; subskrypcja oprogramowania nie jest oferowana).
Często zadawane pytania (FAQ)
P1: Czy mały model 7B naprawdę wystarczy? O: Dla 80–90% powtarzalnych zadań firmowych — wystarczy. Modele klasy 7B po dostrojeniu domenowym osiągają 94% dokładności w takich zadaniach jak weryfikacja umów; powszechna praktyka — SLM obsługuje rutynowe zapytania, a złożone pytania kieruje do chmurowego dużego modelu.
P2: Jaki sprzęt jest potrzebny do lokalnego uruchomienia modelu 7B? O: Po kwantyzacji około 8–16 GB VRAM/RAM — wystarczy mini-PC z NPU lub urządzenie klasy Jetson Orin; dla wielowątkowej przepustowości zalecany jest komputer przemysłowy z GPU od 48 GB.
P3: Brzegowa AI i prywatne wdrożenie to to samo? O: Niezupełnie. Prywatne wdrożenie podkreśla, że dane nie opuszczają przedsiębiorstwa (może odbywać się na serwerach centrum danych); brzegowa AI podkreśla obliczenia blisko źródła danych (hala, sklep, urządzenie). Oba podejścia często się nakładają: węzły brzegowe + prywatna chmura przedsiębiorstwa.
P4: Czym komputer przemysłowy z AI różni się od komputera konsumenckiego? O: Szeroki zakres temperatur (klasa -25 °C do 70 °C), odporność na wibracje, pyłoszczelność, praca ciągła 7×24, długi cykl dostaw i interfejsy przemysłowe. Komputery konsumenckie w warunkach linii awariują wyraźnie częściej — ukryte koszty znacznie przewyższają różnicę w cenie.
P5: Czy chmurowe duże modele zastąpią brzegową AI? O: Dane rynkowe dają przeciwną odpowiedź — rynek brzegowej AI rośnie w średniorocznym tempie 32,5%, obciążenia wnioskowania nadal migrują na poziom lokalny. Przyszłość należy do podziału pracy „trening w chmurze, wnioskowanie na brzegu”, a nie do zastępowania jednego drugim.