边缘AI崛起:小模型为什么正在把算力从云端拉回本地
- 广州长帆智能科技有限公司
- 2026-10-12
引言:AI 的重心正在从云端向边缘迁移
过去三年,企业用 AI 的标准姿势是“调云端 API”。2026 年,这个姿势正在被改写:Gartner 预测到 2027 年 40% 的企业 AI 负载将从云端大模型转向小语言模型(SLM);行业统计显示 73% 的组织正在把推理迁往边缘环境以提升能效;全球边缘 AI 市场预计从 2026 年的 469.6 亿美元增长到 2034 年的 4457.5 亿美元,年复合增长率 32.5%。算力的重心,正在从“遥远的机房”回到“数据产生的地方”。
推动这场迁移的不是情怀,而是三本账:成本账(小模型推理成本可降 75%)、延迟账(本地推理 50—200 毫秒,云端往返望尘莫及)、隐私账(数据不出厂、不出院、不出内网)。这三本账,恰好都是硬件厂商的主场。
什么是边缘AI?和云端AI的本质区别是什么?
一句话答案:边缘 AI 是把模型推理放在靠近传感器、机器和用户本地设备上执行,而不是把数据传到云端再传回结果。本质区别在于:数据不动,模型动。
数据不动带来三个结构性优势:其一,延迟从“网络往返 + 排队”压缩到纯计算时间,工业视觉质检可以做到 50 毫秒以内;其二,断网可用,AGV 小车、野外巡检、海上平台不会因为网络抖动而“变傻”;其三,敏感数据全程留在本地,天然满足医疗、金融、政企的合规要求。云端 AI 仍然适合超大规模训练和弹性峰值,但“最后一公里”的推理,越来越多地发生在边缘。
小模型(SLM)为什么能在2026年挑大梁?
一句话答案:因为“够用”的模型便宜了不止一个数量级——7B 级 SLM 的服务成本比 70B—175B 大模型低 10—30 倍,综合 GPU、云和能耗开支最多可降 75%,而 80%—90% 的企业任务它都能胜任。
三个标志性事实:微软 Phi-4 用 14B 参数在数学推理上逼近 671B 的 DeepSeek R1;某 7B 法律 SLM 在合同审查任务上准确率 94%,反超 GPT-5 的 87%;AT&T 在 2026 年初把自动客服迁移到微调后的 Mistral/Phi 模型集群,月度 API 成本下降 90%、响应速度提升 70%。企业的标准架构正在变成“混合制”——SLM 处理 80%—95% 的常规请求,复杂推理再路由给云端大模型。Gartner 的预测更直接:到 2027 年,企业使用任务专用小模型的频率将是通用大模型的 3 倍。
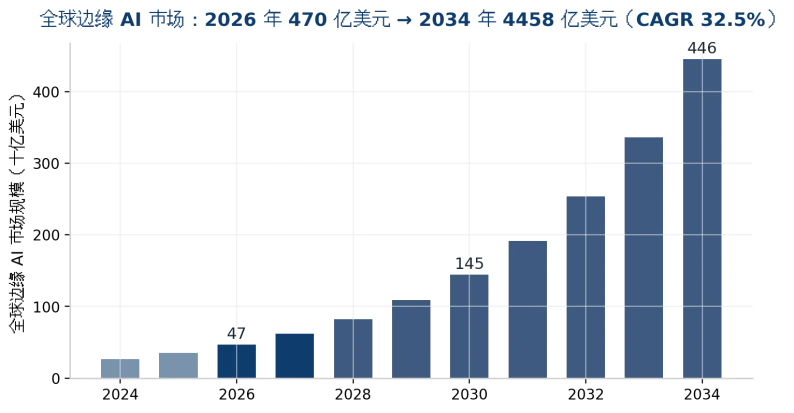
图 1:全球边缘 AI 市场规模预测(2026—2034,数据来源见附录)
边缘AI硬件怎么选?
一句话答案:按“模型大小 + 环境条件”两轴选型:7B 以下轻量视觉/NLP 选 Jetson 级嵌入式模组或 NPU 迷你 PC;7B—70B 选 x86 工控机 + 单/双 GPU;人形机器人和多模态大模型上 Jetson Thor 级平台。
平台档位 | 代表平台 | AI 算力 | 功耗 | 典型场景 |
轻量边缘 | Jetson Orin Nano Super | 67 TOPS | 7-25W | 单/双路视觉检测、OCR、智能相机 |
中端边缘 | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60W | 多路质检、AGV/AMR、机械臂视觉 |
旗舰边缘 | Jetson Thor T5000 | 2070 TFLOPS(FP4) | 40-130W | 人形机器人、边缘端 LLM、多模态 |
x86 工控 + GPU | 工控机 + RTX PRO 6000(96GB) | 单卡级 FP4 | 整机 300-700W | 车间私有化知识库、70B 级推理、视觉 + 语言混合负载 |
桌面 AI 盒 | 统一内存 AI 主机(128GB 级) | 约 1 PFLOP(FP4) | 150-300W | 开发调试、部门级私有助手(参考价 $4,699) |
表 1:边缘 AI 硬件平台分档对比(2026,算力口径不同不可直接横比,仅供选型参考)
容易被低估的是环境指标:车间现场的温度、粉尘、振动、电压波动,消费级设备扛不住。工业场景选型必须核对宽温范围(-25℃ 至 70℃ 级)、无风扇/抗震设计、7×24 连续运行 MTBF,以及 I/O 接口(多 GbE、PoE、CAN、串口)是否匹配现有产线。
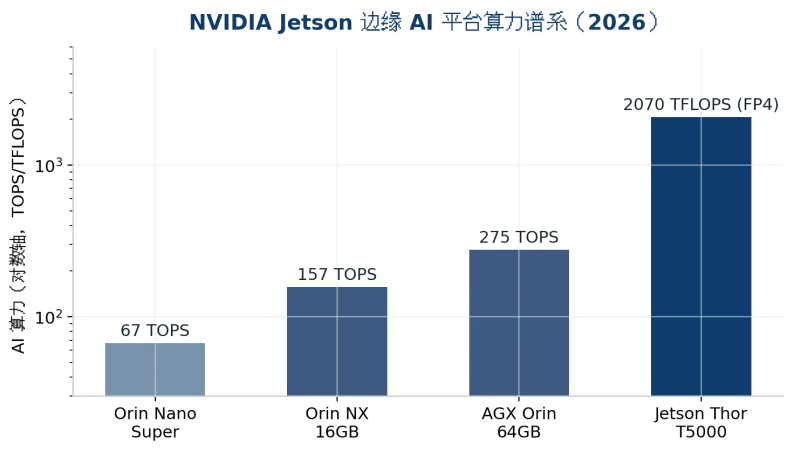
图 2:Jetson 边缘 AI 平台算力谱系(对数轴,2026)
哪些场景必须上边缘AI?
▪工业质检与预测性维护:产线节拍以毫秒计,缺陷图片不出厂既是速度要求也是保密要求。
▪AGV/AMR 与机器人:移动中网络不可靠,避障与路径规划必须本地实时完成。
▪医疗与金融:病历、影像、交易数据受合规约束,私有化部署是入场券而非加分项。
▪能源与野外作业:海上平台、矿山、电网巡检常年弱网/断网,本地智能是唯一选项。
▪连锁门店与分支机构:总部模型下发、门店本地推理,带宽成本和数据回传压力同时下降。
长帆工控:把大模型装进车间和机柜的边缘硬件
边缘 AI 落地,一半功夫在模型,另一半在“放模型的盒子”。广州长帆智能科技有限公司(长帆工控 / ChangFan)提供覆盖轻量到旗舰的边缘计算硬件:宽温抗震的嵌入式工控机与 box PC、支持单/双 GPU 扩展的 AI 边缘一体机、以及面向部门级私有化部署的 2U/4U GPU 服务器,兼容 Ollama、vLLM、OpenWebUI、ComfyUI 等主流本地推理栈,可按产线环境定制宽温、无风扇、多网口与 PoE 配置。
无论您要部署的是 7B 质检模型还是 70B 企业知识库,长帆工控都可以按“模型规模 × 现场环境”给出整机配置方案,欢迎联系获取选型建议(硬件整机方案,不含软件订阅)。
常见问题(FAQ)
Q1:7B 小模型真的够用吗?A:对 80%—90% 的重复性企业任务够用。7B 级模型经领域微调后,在合同审查等任务上可达 94% 准确率;主流做法是 SLM 处理常规请求、复杂问题再路由云端大模型。
Q2:本地跑一个 7B 模型需要什么硬件?A:量化后约需 8—16GB 显存/内存,一台带 NPU 的迷你 PC 或 Jetson Orin 级设备即可;追求多并发吞吐建议工控机加一张 48GB 以上 GPU。
Q3:边缘 AI 和私有化部署是一回事吗?A:不完全等同。私有化部署强调数据不出企业(可在机房服务器上);边缘 AI 强调计算靠近数据源头(可在车间、门店、设备端)。二者常叠加出现:边缘节点 + 企业私有云。
Q4:工控机跑 AI 和消费级主机有什么区别?A:宽温(-25℃ 至 70℃ 级)、抗震、防尘、7×24 连续运行、长供货周期与工业 I/O。消费主机在产线环境的故障率会显著上升,隐性成本远超差价。
Q5:边缘 AI 会不会被云端大模型取代?A:市场数据给出相反答案——边缘 AI 市场以 32.5% 的年复合增速扩张,推理负载持续向本地迁移。未来是“云训练、边推理”的分工,而非谁取代谁。