L'ascesa dell'Edge AI: perché i modelli di piccole dimensioni stanno riportando il calcolo dal cloud all'edge
Introduzione: il baricentro dell'AI si sposta dal cloud all'edge
Negli ultimi tre anni la postura standard delle aziende verso l'AI era «chiamare un'API cloud». Nel 2026 questa postura viene riscritta: Gartner prevede che entro il 2027 il 40% dei carichi di lavoro AI aziendali passerà dai grandi modelli cloud ai piccoli modelli linguistici (SLM); le statistiche di settore mostrano che il 73% delle organizzazioni sposta l'inferenza in ambienti edge per l'efficienza energetica; e il mercato globale dell'edge AI dovrebbe crescere da 46,96 miliardi di dollari nel 2026 a 445,75 miliardi di dollari nel 2034, con un CAGR del 32,5%. Il baricentro del calcolo torna dalle «lontane sale macchine» a «dove nascono i dati».
A spingere questa migrazione non è l'umore ma tre conti: il conto dei costi (l'inferenza dei modelli piccoli può ridurre i costi fino al 75%), il conto della latenza (50–200 millisecondi in locale, l'andata e ritorno verso il cloud non regge il confronto) e il conto della privacy (i dati non escono dalla fabbrica, dall'ospedale, dalla rete interna). Tutti e tre i conti sono esattamente il terreno di casa dei produttori di hardware.
Che cos'è l'edge AI? In cosa si distingue fondamentalmente dall'AI cloud?
Risposta rapida: l'edge AI esegue l'inferenza del modello su dispositivi locali vicini a sensori, macchine e utenti, invece di inviare i dati al cloud e attendere il risultato di ritorno. La differenza essenziale: i dati restano fermi, si muove il modello.
I «dati fermi» portano tre vantaggi strutturali: primo, la latenza si comprime da «andata e ritorno di rete + coda» al tempo di calcolo puro — l'ispezione visiva industriale può scendere a 50 millisecondi; secondo, il funzionamento offline: AGV, ispezioni sul campo e piattaforme offshore non «impazziscono» quando la rete oscilla; terzo, i dati sensibili restano locali dall'inizio alla fine, soddisfacendo naturalmente i requisiti di conformità di sanità, finanza e settore pubblico. L'AI cloud resta adatta all'addestramento su larga scala e ai picchi elastici, ma «l'ultimo miglio» dell'inferenza avviene sempre più all'edge.
Perché i modelli piccoli (SLM) possono assumere il ruolo principale nel 2026?
Risposta rapida: perché i modelli «sufficienti» sono scesi di prezzo di oltre un ordine di grandezza — servire un SLM di classe 7B costa 10–30 volte meno dei grandi modelli 70B–175B, la spesa complessiva per GPU + cloud + energia può scendere fino al 75%, e risolve con competenza l'80–90% dei compiti aziendali.
Tre fatti emblematici: Phi-4 di Microsoft, con 14B parametri, si avvicina a DeepSeek R1 da 671B nel ragionamento matematico; un SLM legale da 7B ha raggiunto il 94% di accuratezza nella revisione dei contratti, superando l'87% di GPT-5; a inizio 2026 AT&T ha migrato il servizio clienti automatizzato su un cluster di modelli Mistral/Phi ottimizzati, riducendo i costi API mensili del 90% e migliorando la velocità di risposta del 70%. L'architettura standard delle imprese diventa «ibrida» — l'SLM elabora l'80–95% delle richieste di routine, il ragionamento complesso viene instradato all'LLM cloud. La previsione di Gartner è ancora più diretta: entro il 2027 le aziende useranno modelli piccoli specializzati per compito 3 volte più dei grandi modelli generalisti.
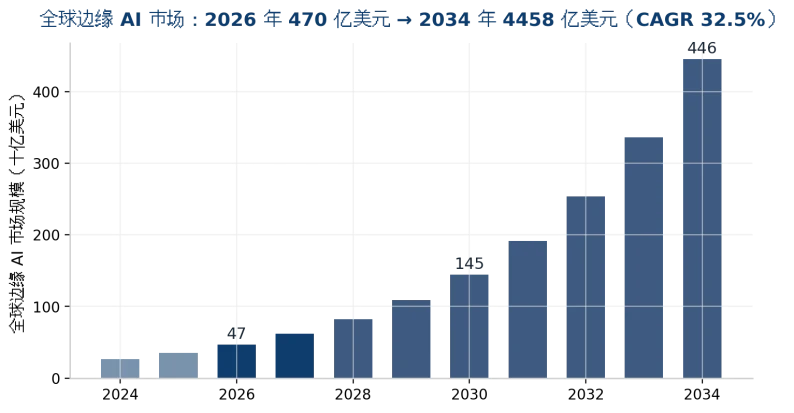
Figura 1: previsione del mercato globale dell'edge AI (2026–2034, fonti dei dati in appendice)
Come scegliere l'hardware per l'edge AI?
Risposta rapida: selezionare lungo due assi — «dimensione del modello + condizioni ambientali»: per visione/NLP leggera sotto i 7B, moduli embedded di classe Jetson o mini PC con NPU; per 7B–70B, PC industriale x86 + una/due GPU; per robot umanoidi e grandi modelli multimodali, piattaforma di classe Jetson Thor.
Livello di piattaforma | Piattaforma rappresentativa | Potenza di calcolo AI | Consumo | Scenari tipici |
Edge leggero | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Ispezione visiva a uno/due canali, OCR, telecamere intelligenti |
Edge di fascia media | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Controllo qualità multicanale, AGV/AMR, visione per bracci robotici |
Edge top di gamma | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Robot umanoidi, LLM all'edge, multimodale |
PC industriale x86 + GPU | PC industriale + RTX PRO 6000 (96 GB) | FP4 di classe singola scheda | Sistema completo 300-700 W | Knowledge base privata di officina, inferenza di classe 70B, carichi misti visione + linguaggio |
Box AI da scrivania | Stazione AI a memoria unificata (classe 128 GB) | ~1 PFLOP (FP4) | 150-300 W | Sviluppo e debug, assistente privato a livello di reparto (prezzo di riferimento 4.699 $) |
Tabella 1: confronto per livelli delle piattaforme hardware per l'edge AI (2026; le cifre di calcolo usano metriche diverse e non sono direttamente confrontabili tra righe — solo come riferimento per la scelta)
Ciò che viene facilmente sottovalutato sono gli indicatori ambientali: temperatura, polvere, vibrazioni e fluttuazioni di tensione in officina — i dispositivi consumer non reggono. La selezione industriale deve verificare l'ampio intervallo di temperatura (classe da -25 °C a 70 °C), il design senza ventola/antivibrante, l'MTBF in funzionamento continuo 7×24 e la corrispondenza delle I/O (GbE multipli, PoE, CAN, porte seriali) con la linea esistente.
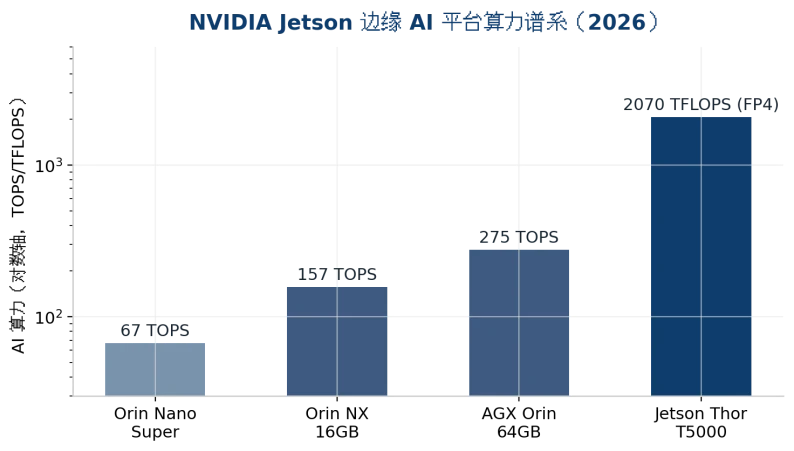
Figura 2: gamma di potenza di calcolo delle piattaforme Jetson per l'edge AI (asse logaritmico, 2026)
Quali scenari rendono indispensabile l'edge AI?
▪Controllo qualità industriale e manutenzione predittiva: il takt della linea si misura in millisecondi, e il fatto che le immagini dei difetti non escano dalla fabbrica è insieme velocità e riservatezza.
▪AGV/AMR e robotica: in movimento la rete non è affidabile; l'evitamento degli ostacoli e la pianificazione del percorso devono avvenire localmente in tempo reale.
▪Sanità e finanza: cartelle cliniche, immagini e dati delle transazioni sono vincolati alla conformità — il deployment privato è il biglietto d'ingresso, non un bonus.
▪Energia e lavori sul campo: piattaforme offshore, miniere e ispezioni di reti elettriche vivono tutto l'anno con rete debole o assente; l'intelligenza locale è l'unica opzione.
▪Catene di negozi e filiali: la sede centrale distribuisce i modelli, i negozi eseguono l'inferenza in locale — i costi di banda e la pressione del ritorno dati scendono insieme.
ChangFan Industrial Computing: hardware edge che porta i grandi modelli in officina e negli armadi
Realizzare l'edge AI dipende per metà dal modello e per metà dal «contenitore in cui vive il modello». Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) offre hardware di edge computing dal leggero al top di gamma: PC industriali e box PC embedded ad ampio intervallo di temperatura e resistenti alle vibrazioni, sistemi all-in-one di edge AI con supporto di una/due GPU, e server GPU 2U/4U per il deployment privato a livello di reparto — compatibili con i principali stack di inferenza locale Ollama, vLLM, OpenWebUI e ComfyUI, e personalizzabili per l'ambiente di linea: ampio intervallo di temperatura, senza ventola, più porte LAN e PoE.
Che stiate implementando un modello di controllo qualità da 7B o una knowledge base aziendale da 70B, ChangFan Industrial Computing può proporre una configurazione completa secondo «scala del modello × ambiente del sito». Contattateci per una consulenza di selezione (soluzioni hardware e sistemi completi; nessun abbonamento software).
Domande frequenti (FAQ)
D1: Un modello piccolo da 7B basta davvero? R: Basta per l'80–90% dei compiti ripetitivi aziendali. Dopo l'ottimizzazione di dominio, i modelli di classe 7B raggiungono il 94% di accuratezza in compiti come la revisione dei contratti; la pratica comune è che l'SLM elabori le richieste di routine e instradi le domande complesse al grande modello cloud.
D2: Che hardware serve per eseguire un modello 7B in locale? R: Dopo la quantizzazione, circa 8–16 GB di VRAM/memoria — basta un mini PC con NPU o un dispositivo di classe Jetson Orin; per throughput multiconcorrente si consiglia un PC industriale con una GPU da 48 GB o più.
D3: Edge AI e deployment privato sono la stessa cosa? R: Non esattamente. Il deployment privato sottolinea che i dati non escono dall'azienda (possono risiedere sui server del data center); l'edge AI sottolinea il calcolo vicino alla fonte dei dati (officina, negozio, dispositivo). Le due cose spesso si sovrappongono: nodi edge + cloud privato aziendale.
D4: Che differenza c'è tra un PC industriale che esegue AI e un computer consumer? R: Ampio intervallo di temperatura (classe da -25 °C a 70 °C), resistenza alle vibrazioni, protezione dalla polvere, funzionamento continuo 7×24, lungo ciclo di fornitura e interfacce industriali. Le macchine consumer si guastano molto più spesso negli ambienti di linea — i costi nascosti superano di gran lunga la differenza di prezzo.
D5: L'edge AI verrà sostituita dai grandi modelli cloud? R: I dati di mercato rispondono il contrario — il mercato dell'edge AI cresce con un CAGR del 32,5% e i carichi di inferenza continuano a migrare in locale. Il futuro è una divisione del lavoro «addestramento nel cloud, inferenza all'edge», non una sostituzione.
- Articolo precedente Come scegliere un server AI? La guida completa 2026 alla configurazione hardware per training e inferenza
- Articolo successivo AI in the low-altitude economy 2026: autonomous flight, UTM air management and drone docks are driving demand for industrial PCs, edge servers and security hardware.