Ang Pag-usbong ng Edge AI: Kung Bakit Binabawi ng Maliliit na Modelo ang Compute mula sa Cloud
Mabilisang sagot: Ang edge AI ay nangangahulugang direktang pagpapatakbo ng inferens ng modelo sa lokal na hardware o sa device na malapit sa pinagmulan ng datos, nang hindi ipinapadala sa cloud. Ang maliliit na modelo (SLM) ay mga kompaktong modelo ng wika (karaniwang 1 hanggang 14 bilyong parameter) na idinisenyo upang mahusay na tumakbo sa hardware na ito. Ang kombinasyon ng dalawa ay nagbibigay-daan sa mga organisasyon na magpatakbo ng inferens ng AI nang lokal na may latensiyang 50 hanggang 200 millisecond, nang hindi umaasa sa koneksyon sa network — habang pinananatili ang buong soberanya ng datos at binabawasan ang gastos sa inferens nang hanggang 75% kumpara sa mga cloud API.
Ito ay isang istraktural na pagbabago, hindi pansamantalang uso.
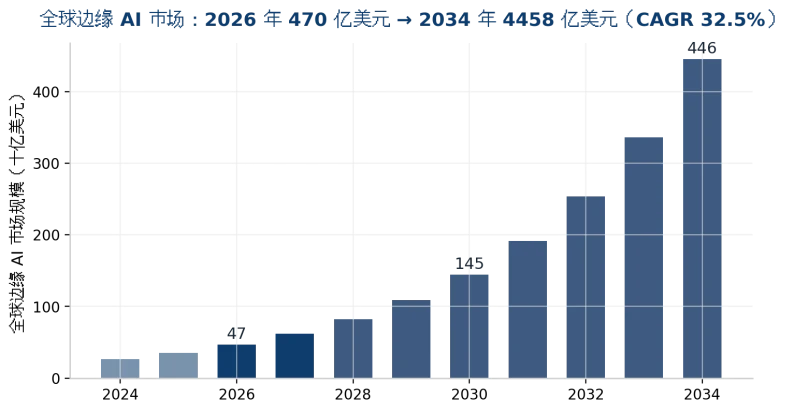
Inaasahan ng Gartner na pagsapit ng katapusan ng 2027, 40% ng mga organisasyon ang gagamit ng edge AI upang magproseso ng sensitibong datos sa kanilang mga kapaligiran ng operasyon — samantalang noong 2023 ang antas na ito ay mas mababa sa 5%. Ang dahilan ay ang pagsasama-sama ng mga presyur na pang-ekonomiya, pangregulasyon, at teknikal.
Sinasagot ng artikulong ito ang tatlong pangunahing tanong: bakit biglang naging sapat na mahusay ang maliliit na modelo; anong mga tunay na problema ang nalulutas ng paggamit ng edge AI; at anong hardware ang kailangan ng mga organisasyon sa 2026 upang magamit ang edge AI.
Ang pagsasama-sama ng tatlong istraktural na tagapagtulak
Ang unang tagapagtulak ay pang-ekonomiya: ang gastos sa cloud inferens ay lubos na nagbabago-bago at mahirap hulaan. Ang ikalawang tagapagtulak ay pangregulasyon: ang mga regulasyon tulad ng GDPR, HIPAA, at mga batas sa lokalisasyon ng datos ng Tsina ay nagpapahirap o nagpapaimposible sa maraming organisasyon na magpadala ng sensitibong datos sa panlabas na imprastraktura ng cloud. Ang ikatlong tagapagtulak ay teknikal: ang maliliit na modelo ay maaari na ngayong gawin ang maraming gawain na dalawang taon na nakalipas ay nangangailangan ng higanteng LLM.
Ang tatlong tagapagtulak na ito ay nagbukas ng isang bintana ng paggamit na hindi lamang bukas sa mga higante ng teknolohiya, kundi pati na rin sa maliliit at katamtamang laki ng negosyo.
Maliliit na modelo laban sa malalaking modelo: Ano ang tunay na nagbago
Nakakalito ang label na «maliit» sa SLM. Sa 2026, ang modelo na may 7 hanggang 14 bilyong parameter ay itinuturing na «maliit» — ngunit ang Phi-4 ng Microsoft, na may 14 bilyong parameter, ay nakakamit ang 94% na katumpakan sa GSM8K math benchmark, samantalang ang GPT-5 ay nakakamit ang 87%. Hindi ito eksepsiyon: sa mga espesyal na domain na may istrukturadong datos, ang mga fine-tuned na maliit na modelo ay palaging nalalampasan ang mga pangkalahatang modelo na daan-daang beses na mas malaki.
Simple ang dahilan: pagsasanay na partikular sa domain. Ang maliit na modelo na sinanay sa mga medikal na dokumento, legal na kontrata, o mga ulat ng pagpapanatili ng kagamitan ay mas tumpak kaysa sa malaking pangkalahatang modelo sa domain na iyon — dahil mas kaunting ingay ang kailangang salain.
Para sa paggamit ng edge, ibig sabihin nito: sapat na maliit ang modelo upang tumakbo sa Jetson Thor o industrial computer; sapat na mabilis ang mga tugon upang suportahan ang mga real-time na aplikasyon; at ang gastos bawat inferens ay isa sa sampu hanggang isa sa tatlumpu ng isang cloud API call.
Kasabay nito, ang maliliit na modelo ay hindi para sa lahat ng layunin. Sa komplikadong multi-step na pangangatwiran, mahabang paglikha ng nilalaman, at mga gawaing nangangailangan ng malawak na pangkalahatang kaalaman, ang malalaking modelo ay nananatiling nakatataas. Iyon ang dahilan kung bakit ang hinaharap ay hibrid — hindi kapalit.
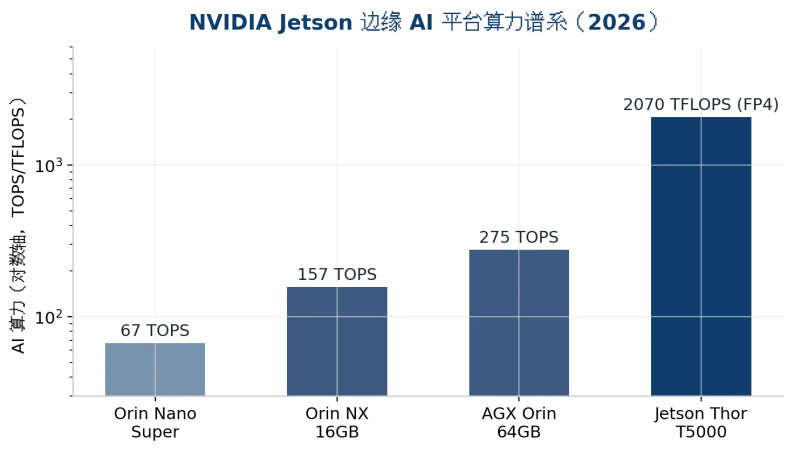
Antas ng hardware | Mga kinatawang platform | Kapangyarihan (TOPS) | Inirerekomendang RAM | Konsumo ng kuryente |
Tinatangkahang presyo | Pangunahing aplikasyon | Kompakto / antas ng pasukan | Jetson Orin Nano / NUC | 67 TOPS |
8 hanggang 16GB | 15 hanggang 30W | 400 hanggang 800 dolyar | Mga sensor, kamera | Katamtamang industriyal |
Jetson AGX Orin / IPC | 157 hanggang 275 TOPS | 32 hanggang 64GB | 30 hanggang 100W | 1,500 hanggang 5,000 dolyar |
Visual na inspeksiyon, robotika | Mataas na antas / propesyonal | Jetson Thor / RTX 5090 | 2070 teraflop FP4 | 48GB pataas |
300 hanggang 700W | 4,699 dolyar pataas | Pisikal na AI, mabigat na inferens | Pang-enterprise / edge data center | RTX 6000 Ada / H100 |
Ang hibrid na arkitektura sa pagsasagawa
Ang hibrid na AI ay nangangahulugang ang mga lokal na maliit na modelo ang humahawak ng pangongolekta ng datos, paunang pagproseso, mga real-time na gawain, at mga paunang tugon, samantalang ang mga cloud LLM ay ginagamit para sa komplikadong pangangatwiran, paghahanap ng kaalaman, at malikhaing gawain. Pinananatili ng arkitekturang ito ang mga bentahe ng dalawa: mababang latensiya at soberanya ng datos sa edge, mataas na kapangyarihan ng komputasyon sa cloud.
Ipinapakita ng pananaliksik na 80 hanggang 95% ng mga production inferens workload ay maaaring gawin ng maliliit na modelo sa edge, at 5 hanggang 20% lamang ang tunay na nangangailangan ng malalaking cloud na modelo. Binawasan ng AT&T ang gastos sa inferens nang 90% at tinaasan ang bilis ng tugon nang 70% sa pamamagitan ng matalinong pagruruta — na ipinapadala lamang ang mga komplikadong query sa malalaking modelo.
Pribadong paggamit: soberanya ng datos bilang kompetitibong bentahe
Para sa pagmamanupaktura, enerhiya, transportasyon, at mga serbisyong pinansyal, ang pribadong paggamit ng AI ay hindi lamang pangregulasyong kinakailangan — ito ay kompetitibong bentahe. Kapag ang modelo ay tumatakbo sa loob ng network ng organisasyon, ang datos ay hindi kailanman lumalabas: hindi para sa pagsasanay, hindi para sa pagproseso. Inaalis nito ang mga panganib ng pagtagas ng datos, paglabag sa mga kasunduan sa pagiging kumpidensyal, at pagdepende sa vendor.
Kaganyak din sa pananaw ng gastos: ang paggamit ng edge ay ginagawa sa isang beses na pamumuhunan sa hardware at pagkatapos ay ang gastos bawat inferens ay halos sero — samantalang ang mga cloud API ay naniningil bawat tawag. Para sa mga madalas na paulit-ulit na aplikasyon (visual na inspeksiyon, pagmamanman ng kagamitan, pagproseso ng dokumento), ang pagkakaiba ng gastos ay nagiging malinaw sa loob ng ilang buwan.
Ang pagsikat ng pisikal na AI
Ang pisikal na AI — ibig sabihin, AI na tumatakbo sa mga robot, sasakyan, at pang-industriyang kagamitan — ay humihingi ng edge hardware, dahil ang mga pisikal na desisyon ay hindi maaaring maghintay ng paglipat papunta at pabalik sa cloud. Ang isang robotic arm na kailangang tumugon sa loob ng 50 millisecond ay hindi maaaring umasa sa isang cloud API na may 200 millisecond na latensiya.
Dito pumapasok ang mga industrial computer: hindi tulad ng mga consumer laptop, ang mga ito ay ginawa para sa 24/7 na operasyon sa mahihirap na kapaligiran — temperaturang -25 hanggang 70 degrees Celsius, walang bentilador, lumalaban sa alikabok at pagyanig. Ang mga katangiang ito ay hindi opsyonal para sa pisikal na AI.
Hardware ng edge AI: gabay sa pagbili 2026
Ang ChangFan Industrial Computing ay nagbibigay ng mga solusyon sa edge AI hardware para sa mga kapaligiran ng pagmamanupaktura, enerhiya, at transportasyon.
Ang pangunahing tanong sa pagpili ng edge hardware ay: aling modelo ang nais mong patakbuhin, sa anong bilis ng inferens?
Para sa mga modelong 7 hanggang 14 bilyong parameter (Phi-4, Mistral, quantized Llama 3.x), sapat na ang NVIDIA Jetson AGX Orin (67 TOPS) o Jetson Thor (157 hanggang 275 TOPS). Para sa mas mabibigat na inferens na may mga modelong 30 hanggang 70 bilyong parameter, kailangan ang workstation na may high-end consumer GPU (RTX 5090, 2070 teraflop FP4) o kompaktong data center GPU (RTX 6000 Ada, humigit-kumulang 1 petaflop FP4).
Mahalaga ang RAM: ang mga quantized na 7 bilyong parameter na modelo ay nangangailangan ng 8 hanggang 16GB, ang mga 14 bilyon ay nangangailangan ng 32 hanggang 48GB, at ang mga quantized na 70 bilyon ay nangangailangan ng 96GB o higit pa. Ang mababang memorya ang tunay na hadlang ng maraming paggamit ng edge.
Para sa mahihirap na kapaligiran (palapag ng pabrika, labas ng gusali, mga sasakyan), ang mga fanless industrial computer na may malawak na saklaw ng temperatura (-25 hanggang 70 degrees Celsius) at industriyal na power supply ay kinakailangan. Ang consumer hardware ay masira sa loob ng ilang buwan sa mga kondisyong ito.
Mga praktikal na aplikasyon ayon sa industriya
Pagmamanupaktura: real-time na visual na inspeksiyon sa linya ng produksiyon, prediktibong pagpapanatili sa pamamagitan ng pagsusuri ng pagyanig at tunog, pag-optimize ng mga parameter ng proseso. Bentahe ng edge: mga desisyon sa paghinto ng linya sa millisecond, hindi segundo.
Enerhiya at imprastraktura: pagmamanman ng kagamitan sa mga malayong lokasyon na walang maaasahang saklaw ng network, pagtukoy ng anomalia sa mga substation, paghula ng pagkasira ng turbina. Bentahe ng edge: operasyong independyente sa koneksyon sa internet.