Der Aufstieg von Edge-KI: Warum kleine Modelle Rechenleistung aus der Cloud zurückholen
Haupttext (Deutsch)
Einleitung: Der Schwerpunkt der KI verlagert sich von der Cloud an den Rand
In den letzten drei Jahren lautete die Standardhaltung von Unternehmen gegenüber KI: „Cloud-API aufrufen“. 2026 wird diese Haltung neu geschrieben: Gartner prognostiziert, dass bis 2027 40 % der Unternehmens-KI-Workloads von großen Cloud-Modellen auf kleine Sprachmodelle (SLM) umsteigen werden; Branchenstatistiken zeigen, dass 73 % der Organisationen die Inferenz aus Energieeffizienzgründen in Edge-Umgebungen verlagern; und der weltweite Edge-KI-Markt soll von 46,96 Mrd. US-Dollar im Jahr 2026 auf 445,75 Mrd. US-Dollar im Jahr 2034 wachsen – bei einer CAGR von 32,5 %. Der Schwerpunkt der Rechenleistung kehrt aus „fernen Maschinenhallen“ dorthin zurück, „wo Daten entstehen“.
Diese Migration wird nicht von Stimmungen getrieben, sondern von drei Rechnungen: der Kostenrechnung (Inferenz mit kleinen Modellen kann die Kosten um bis zu 75 % senken), der Latenzrechnung (50–200 Millisekunden lokal, ein Cloud-Roundtrip kann nicht mithalten) und der Datenschutzrechnung (Daten verlassen weder Werk, Krankenhaus noch internes Netz). Alle drei Rechnungen liegen genau im Heimatrevier der Hardware-Hersteller.
Was ist Edge-KI? Worin unterscheidet sie sich grundlegend von Cloud-KI?
Kurze Antwort: Edge-KI führt die Modellinferenz auf lokalen Geräten in der Nähe von Sensoren, Maschinen und Nutzern aus, statt Daten in die Cloud zu senden und auf das Ergebnis zu warten. Der wesentliche Unterschied: Die Daten bleiben stehen, das Modell bewegt sich.
„Stehende Daten“ bringen drei strukturelle Vorteile: Erstens schrumpft die Latenz von „Netzwerk-Roundtrip + Warteschlange“ auf reine Rechenzeit – industrielle Sichtprüfung kann auf 50 Millisekunden gedrückt werden; zweitens Offline-Fähigkeit: AGV, Feldinspektionen und Offshore-Plattformen werden bei Netzschwankungen nicht „dumm“; drittens bleiben sensible Daten durchgehend lokal und erfüllen damit ganz natürlich Compliance-Anforderungen in Gesundheitswesen, Finanzen und öffentlichem Sektor. Cloud-KI bleibt geeignet für sehr großes Training und elastische Spitzen, aber die „letzte Meile“ der Inferenz findet zunehmend am Rand statt.
Warum können kleine Modelle (SLM) 2026 die Hauptrolle übernehmen?
Kurze Antwort: Weil „ausreichende“ Modelle um mehr als eine Größenordnung billiger geworden sind – der Betrieb eines SLM der 7B-Klasse kostet 10- bis 30-mal weniger als große Modelle der 70B–175B-Klasse, die Gesamtausgaben für GPU + Cloud + Energie lassen sich um bis zu 75 % senken, und 80–90 % der Unternehmensaufgaben bewältigt er souverän.
Drei wegweisende Fakten: Microsofts Phi-4 mit 14B Parametern kommt in mathematischem Reasoning an DeepSeek R1 mit 671B heran; ein juristisches SLM mit 7B erreichte 94 % Genauigkeit bei der Vertragsprüfung und übertraf damit die 87 % von GPT-5; Anfang 2026 migrierte AT&T den automatisierten Kundenservice auf einen Cluster feinabgestimmter Mistral/Phi-Modelle, senkte die monatlichen API-Kosten um 90 % und verbesserte die Antwortgeschwindigkeit um 70 %. Die Standardarchitektur von Unternehmen wird „hybrid“ – das SLM verarbeitet 80–95 % der Routineanfragen, komplexes Reasoning wird an das Cloud-LLM geroutet. Gartners Prognose ist noch direkter: Bis 2027 setzen Unternehmen aufgabenspezifische kleine Modelle 3-mal häufiger ein als universelle große Modelle.
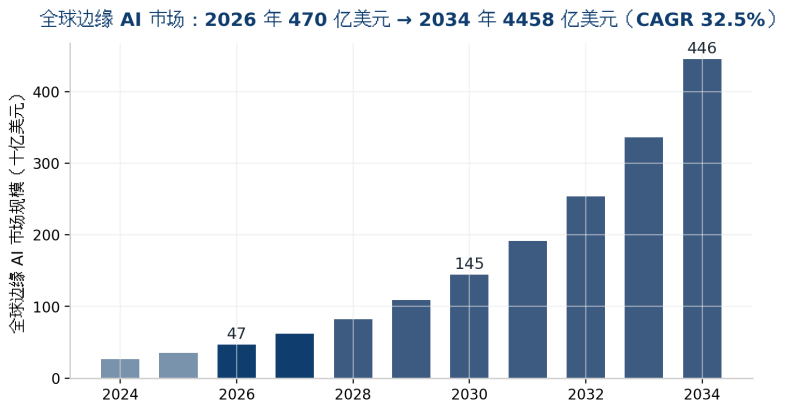
Abb. 1: Prognose des weltweiten Edge-KI-Marktes (2026–2034, Datenquellen im Anhang)
Wie wählt man Edge-KI-Hardware aus?
Kurze Antwort: Auswahl über zwei Achsen – „Modellgröße + Umgebungsbedingungen“: für leichte Vision/NLP unter 7B Embedded-Module der Jetson-Klasse oder Mini-PCs mit NPU; für 7B–70B x86-Industrie-PC + ein/zwei GPUs; für Humanoide und multimodale große Modelle Plattformen der Jetson-Thor-Klasse.
Plattformstufe | Repräsentative Plattform | KI-Rechenleistung | Leistungsaufnahme | Typische Szenarien |
Leichte Edge | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Ein-/zweikanalige Sichtprüfung, OCR, Smart-Kameras |
Mittlere Edge | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Mehrkanalige Qualitätsprüfung, AGV/AMR, Robotarm-Vision |
Flaggschiff-Edge | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Humanoide Roboter, LLM am Rand, multimodal |
x86-Industrie-PC + GPU | Industrie-PC + RTX PRO 6000 (96 GB) | FP4 der Einzelkarten-Klasse | Gesamtsystem 300-700 W | Private Werkswissensbasis, Inferenz der 70B-Klasse, gemischte Vision- + Sprach-Workloads |
Desktop-KI-Box | KI-Station mit Unified Memory (128-GB-Klasse) | ~1 PFLOP (FP4) | 150-300 W | Entwicklung und Debugging, privater Assistent auf Abteilungsebene (Referenzpreis 4.699 $) |
Tabelle 1: Vergleich der Leistungsstufen von Edge-KI-Hardwareplattformen (2026; die Rechenwerte basieren auf unterschiedlichen Metriken und sind zwischen den Zeilen nicht direkt vergleichbar – nur als Auswahlreferenz)
Leicht unterschätzt werden die Umgebungskennwerte: Temperatur, Staub, Vibration und Spannungsschwankungen in der Fertigung – Consumer-Geräte halten das nicht aus. Die industrienahe Auswahl muss den erweiterten Temperaturbereich (Klasse -25 °C bis 70 °C), lüfterloses/vibrationsfestes Design, die MTBF im 7×24-Dauerbetrieb und die Passung der Schnittstellen (mehrere GbE, PoE, CAN, serielle Ports) zur bestehenden Linie prüfen.
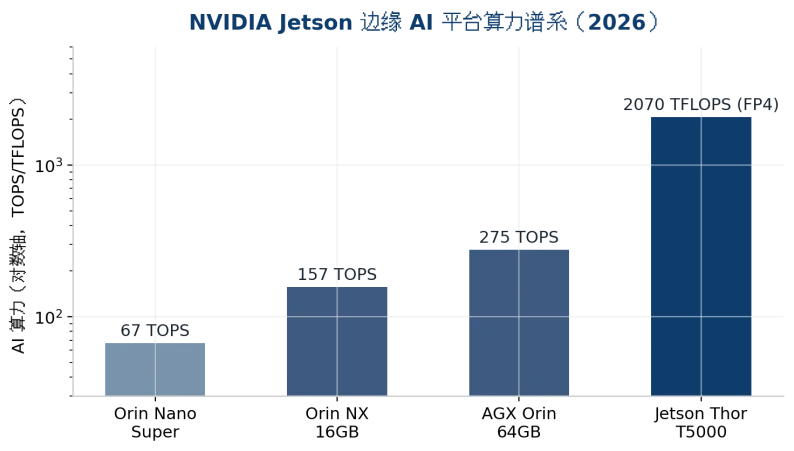
Abb. 2: Rechenleistungs-Spektrum der Jetson-Plattformen für Edge-KI (logarithmische Achse, 2026)
Welche Szenarien erfordern zwingend Edge-KI?
▪Industrielle Qualitätsprüfung und vorausschauende Wartung: Der Linientakt wird in Millisekunden gemessen, und dass Fehlerbilder das Werk nicht verlassen, ist zugleich Tempo- und Geheimhaltungsanforderung.
▪AGV/AMR und Robotik: In Bewegung ist das Netz unzuverlässig; Hindernisvermeidung und Pfadplanung müssen lokal in Echtzeit erfolgen.
▪Gesundheitswesen und Finanzen: Patientenakten, Bildgebung und Transaktionsdaten unterliegen Compliance – privates Deployment ist die Eintrittskarte, kein Bonus.
▪Energie und Außeneinsätze: Offshore-Plattformen, Bergwerke und Netzinspektionen leben ganzjährig mit schwachem oder ohne Netz; lokale Intelligenz ist die einzige Option.
▪Filialketten und Niederlassungen: Die Zentrale verteilt die Modelle nach unten, die Filialen inferieren lokal – Bandbreitenkosten und Datenrücklaufdruck sinken gleichermaßen.
ChangFan Industrial Computing: Edge-Hardware, die große Modelle in Werkhallen und Schaltschränke bringt
Edge-KI Wirklichkeit werden zu lassen, hängt zur Hälfte vom Modell und zur Hälfte von der „Box ab, in der das Modell wohnt“. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) bietet Edge-Computing-Hardware von leicht bis Flaggschiff: Embedded-Industrie-PCs und Box-PCs mit erweitertem Temperaturbereich und Vibrationsfestigkeit, Edge-KI-All-in-One-Systeme mit Unterstützung für eine/zwei GPUs sowie 2U/4U-GPU-Server für privates Deployment auf Abteilungsebene – kompatibel mit den gängigen lokalen Inferenz-Stacks Ollama, vLLM, OpenWebUI und ComfyUI und anpassbar an die Linienumgebung: erweiterter Temperaturbereich, lüfterlos, mehrere LAN-Ports und PoE.
Ob Sie ein 7B-Qualitätsprüfungsmodell oder eine 70B-Unternehmenswissensbasis einführen – ChangFan Industrial Computing kann nach der Formel „Modellmaßstab × Standortumgebung“ eine Komplettkonfiguration anbieten. Kontaktieren Sie uns für eine Auswahlberatung (Hardware-Lösungen und Gesamtsysteme; kein Software-Abonnement).
Häufig gestellte Fragen (FAQ)
F1: Reicht ein kleines 7B-Modell wirklich aus? A: Für 80–90 % der sich wiederholenden Unternehmensaufgaben reicht es aus. Modelle der 7B-Klasse erreichen nach Domain-Feinabstimmung 94 % Genauigkeit bei Aufgaben wie der Vertragsprüfung; übliche Praxis ist, dass das SLM Routineanfragen verarbeitet und komplexe Fragen an das große Cloud-Modell routet.
F2: Welche Hardware braucht man, um ein 7B-Modell lokal auszuführen? A: Nach Quantisierung etwa 8–16 GB VRAM/RAM – ein Mini-PC mit NPU oder ein Gerät der Jetson-Orin-Klasse genügt; für mehrgleisigen Durchsatz wird ein Industrie-PC mit einer GPU ab 48 GB empfohlen.
F3: Sind Edge-KI und privates Deployment dasselbe? A: Nicht ganz. Privates Deployment betont, dass Daten das Unternehmen nicht verlassen (sie können auf Servern im Rechenzentrum liegen); Edge-KI betont das Rechnen in der Nähe der Datenquelle (Werkhalle, Filiale, Gerät). Beide überschneiden sich häufig: Edge-Knoten + private Unternehmens-Cloud.
F4: Was unterscheidet einen Industrie-PC mit KI von einem Consumer-Rechner? A: Erweiterter Temperaturbereich (Klasse -25 °C bis 70 °C), Vibrationsfestigkeit, Staubschutz, 7×24-Dauerbetrieb, langer Lieferlebenszyklus und industrielle Schnittstellen. Consumer-Rechner fallen in Linienumgebungen deutlich häufiger aus – die versteckten Kosten übersteigen den Preisunterschied bei Weitem.
F5: Wird Edge-KI von großen Cloud-Modellen ersetzt werden? A: Marktdaten geben die gegenteilige Antwort – der Edge-KI-Markt wächst mit einer CAGR von 32,5 %, Inferenz-Workloads wandern weiter nach lokal. Die Zukunft ist eine Arbeitsteilung „Training in der Cloud, Inferenz am Rand“, kein Ersatz.