Inleiding: het zwaartepunt van AI verschuift van de cloud naar de edge
De afgelopen drie jaar was de standaardhouding van bedrijven tegenover AI: „een cloud-API aanroepen”. In 2026 wordt die houding herschreven: Gartner voorspelt dat tegen 2027 40% van de AI-workloads van bedrijven zal overstappen van grote cloudmodellen naar kleine taalmodellen (SLM's); branchecijfers tonen dat 73% van de organisaties inferentie verplaatst naar edge-omgevingen voor energie-efficiëntie; en de wereldwijde edge-AI-markt zal naar verwachting groeien van 46,96 miljard dollar in 2026 naar 445,75 miljard dollar in 2034, met een CAGR van 32,5%. Het zwaartepunt van de rekenkracht keert terug van „verre serverhallen” naar „waar data ontstaat”.
Wat deze migratie drijft is geen stemming maar drie rekeningen: de kostenrekening (inferentie met kleine modellen kan de kosten tot 75% verlagen), de latentierrekening (50–200 milliseconden lokaal, een cloud-roundtrip kan niet meekomen) en de privacyrekening (data verlaat de fabriek, het ziekenhuis of het interne netwerk niet). Alle drie de rekeningen liggen precies op het thuisterrein van hardwarefabrikanten.
Wat is edge-AI? Waarin verschilt het fundamenteel van cloud-AI?
Kort antwoord: edge-AI voert de modelinferentie uit op lokale apparaten dicht bij sensoren, machines en gebruikers, in plaats van data naar de cloud te sturen en op het resultaat terug te wachten. Het wezenlijke verschil: de data blijft staan, het model beweegt.
„Stilstaande data” brengt drie structurele voordelen: ten eerste krimpt de latentie van „netwerk-roundtrip + wachtrij” tot pure rekentijd — industriële visuele inspectie kan naar 50 milliseconden; ten tweede offline werken: AGV's, veldinspecties en offshore-platforms worden niet „dom” als het netwerk schommelt; ten derde blijven gevoelige data van begin tot eind lokaal, wat vanzelf voldoet aan compliance-eisen in zorg, financiën en publieke sector. Cloud-AI blijft geschikt voor zeer grootschalige training en elastische pieken, maar de „laatste mijl” van inferentie vindt steeds vaker aan de edge plaats.
Waarom kunnen kleine modellen (SLM's) in 2026 de hoofdrol overnemen?
Kort antwoord: omdat „voldoende” modellen meer dan een orde van grootte goedkoper zijn geworden — het bedienen van een SLM van de 7B-klasse kost 10–30 keer minder dan grote modellen van 70B–175B, de gecombineerde uitgaven aan GPU + cloud + energie kunnen tot 75% dalen, en hij lost 80–90% van de bedrijfstaken capabel op.
Drie veelzeggende feiten: Microsofts Phi-4 met 14B parameters benadert DeepSeek R1 met 671B in wiskundig redeneren; een juridische SLM van 7B bereikte 94% nauwkeurigheid bij contractbeoordeling, beter dan de 87% van GPT-5; begin 2026 migreerde AT&T de geautomatiseerde klantenservice naar een cluster van fijnafgestemde Mistral/Phi-modellen, met 90% lagere maandelijkse API-kosten en 70% snellere reacties. De standaardarchitectuur van bedrijven wordt „hybride” — de SLM verwerkt 80–95% van de routineverzoeken, complex redeneren wordt naar de cloud-LLM gerouteerd. Gartners voorspelling is nog directer: tegen 2027 gebruiken bedrijven taakgespecialiseerde kleine modellen 3 keer vaker dan universele grote modellen.
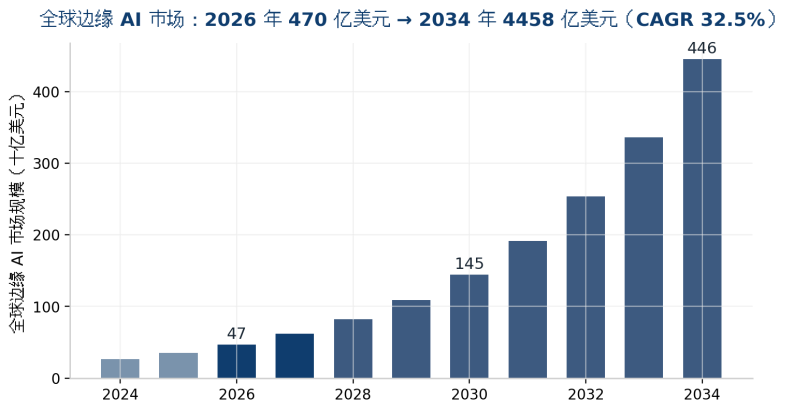
Figuur 1: prognose van de wereldwijde edge-AI-markt (2026–2034, gegevensbronnen in de bijlage)
Hoe kies je edge-AI-hardware?
Kort antwoord: selecteren langs twee assen — „modelgrootte + omgevingscondities”: voor lichte vision/NLP onder 7B embedded modules van de Jetson-klasse of mini-pc's met NPU; voor 7B–70B x86 industriële pc + één/twee GPU's; voor mensachtige robots en multimodale grote modellen een platform van de Jetson Thor-klasse.
Platformniveau | Representatief platform | AI-rekenkracht | Stroomverbruik | Typische scenario's |
Lichte edge | Jetson Orin Nano Super | 67 TOPS | 7-25 W | Eén-/tweekanaals visuele inspectie, OCR, slimme camera's |
Middenklasse edge | Jetson Orin NX / AGX Orin | 157-275 TOPS | 10-60 W | Meerkanaals kwaliteitscontrole, AGV/AMR, robotarmvisie |
Vlaggenschip-edge | Jetson Thor T5000 | 2070 TFLOPS (FP4) | 40-130 W | Mensachtige robots, LLM aan de edge, multimodaal |
x86 industriële pc + GPU | Industriële pc + RTX PRO 6000 (96 GB) | FP4 van enkelkaartsklasse | Compleet systeem 300-700 W | Private werkplaatskennisbasis, inferentie van de 70B-klasse, gemengde vision- + taalworkloads |
Desktop-AI-box | AI-station met unified memory (128 GB-klasse) | ~1 PFLOP (FP4) | 150-300 W | Ontwikkeling en debugging, private assistent op afdelingsniveau (referentieprijs $ 4.699) |
Tabel 1: vergelijking per niveau van edge-AI-hardwareplatforms (2026; de rekenkrachtcijfers gebruiken verschillende meetmethoden en zijn tussen rijen niet direct vergelijkbaar — alleen als selectiereferentie)
Wat makkelijk onderschat wordt, zijn de omgevingsindicatoren: temperatuur, stof, trilling en spanningsschommelingen in de werkplaats — consumentenapparatuur houdt dat niet vol. De industriële selectie moet het brede temperatuurbereik (klasse -25 °C tot 70 °C), het ventilatorloze/trillingsbestendige ontwerp, de MTBF bij 7×24 continu bedrijf en de aansluiting van de I/O (meerdere GbE, PoE, CAN, seriële poorten) op de bestaande lijn controleren.
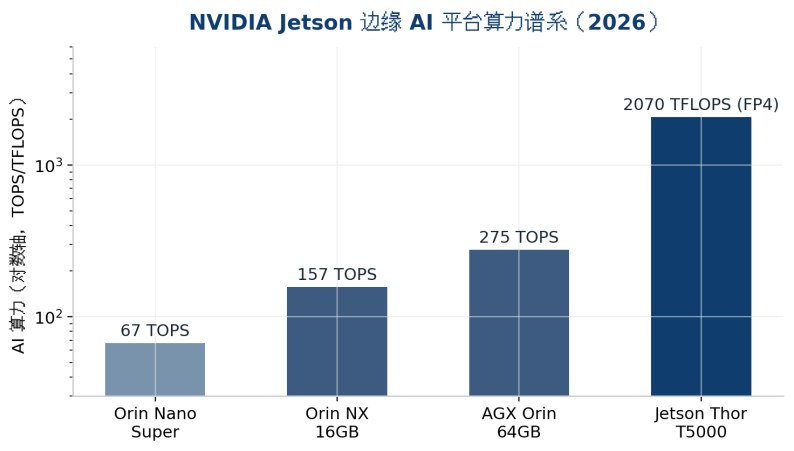
Figuur 2: rekenkrachtassortiment van de Jetson-platforms voor edge-AI (logaritmische as, 2026)
Welke scenario's vereisen edge-AI?
▪Industriële kwaliteitscontrole en predictief onderhoud: de takt van de lijn wordt in milliseconden gemeten, en dat defectbeelden de fabriek niet verlaten is tegelijk snelheid en geheimhouding.
▪AGV/AMR en robotica: in beweging is het netwerk onbetrouwbaar; obstakelvermijding en routeplanning moeten lokaal in realtime gebeuren.
▪Zorg en financiën: patiëntendossiers, beeldvorming en transactiedata zijn aan compliance gebonden — private implementatie is het toegangsbewijs, geen bonus.
▪Energie en veldwerk: offshore-platforms, mijnen en inspecties van elektriciteitsnetten leven het hele jaar met een zwak of afwezig netwerk; lokale intelligentie is de enige optie.
▪Winkelketens en filialen: het hoofdkantoor distribueert de modellen omlaag, de winkels voeren lokaal inferentie uit — bandbreedtekosten en dataterugvoerdruk dalen tegelijk.
ChangFan Industrial Computing: edge-hardware die grote modellen in werkplaatsen en kasten installeert
Edge-AI realiseren is voor de helft het model en voor de helft de „doos waarin het model woont”. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) biedt edge-computinghardware van licht tot vlaggenschip: embedded industriële pc's en box-pc's met breed temperatuurbereik en trillingsbestendigheid, edge-AI-all-in-one-systemen met ondersteuning voor één/twee GPU's, en 2U/4U-GPU-servers voor private implementatie op afdelingsniveau — compatibel met de gangbare lokale inferentiestacks Ollama, vLLM, OpenWebUI en ComfyUI, en aanpasbaar aan de lijnomgeving: breed temperatuurbereik, ventilatorloos, meerdere LAN-poorten en PoE.
Of u nu een kwaliteitscontrolemodel van 7B implementeert of een bedrijfskennisbasis van 70B, ChangFan Industrial Computing kan een complete configuratie voorstellen volgens „modelschaal × locatieomgeving”. Neem contact op voor selectieadvies (hardware-oplossingen en complete systemen; geen software-abonnement).
Veelgestelde vragen (FAQ)
V1: Is een klein model van 7B echt genoeg? A: Voldoende voor 80–90% van de repetitieve bedrijfstaken. Na domein-fine-tuning bereiken modellen van de 7B-klasse 94% nauwkeurigheid bij taken als contractbeoordeling; gangbare praktijk is dat de SLM routineverzoeken verwerkt en complexe vragen naar het grote cloudmodel routeert.
V2: Welke hardware is nodig om een 7B-model lokaal te draaien? A: Na kwantisering circa 8–16 GB VRAM/geheugen — een mini-pc met NPU of een apparaat van de Jetson Orin-klasse volstaat; voor multiconcurrente doorvoer wordt een industriële pc met een GPU vanaf 48 GB aanbevolen.
V3: Zijn edge-AI en private implementatie hetzelfde? A: Niet helemaal. Private implementatie benadrukt dat data het bedrijf niet verlaat (die kan op servers in het datacenter staan); edge-AI benadrukt rekenen dicht bij de databron (werkplaats, winkel, apparaat). Beide overlappen vaak: edge-knooppunten + private bedrijfscloud.
V4: Wat is het verschil tussen een industriële pc met AI en een consumentencomputer? A: Breed temperatuurbereik (klasse -25 °C tot 70 °C), trillingsbestendigheid, stofbescherming, 7×24 continu bedrijf, lange leveringslevenscyclus en industriële interfaces. Consumentenmachines vallen in lijnomgevingen merkbaar vaker uit — de verborgen kosten overtreffen het prijsverschil ruimschoots.
V5: Wordt edge-AI vervangen door grote cloudmodellen? A: Marktgegevens geven het tegenovergestelde antwoord — de edge-AI-markt groeit met een CAGR van 32,5% en inferentieworkloads blijven naar lokaal migreren. De toekomst is een taakverdeling „trainen in de cloud, inferentie aan de edge”, geen vervanging.