Bangkitnya Edge AI: Mengapa Model Berukuran Kecil Menarik Kembali Komputasi dari Cloud
Jawaban singkat: AI edge berarti menjalankan inferensi model secara langsung pada perangkat keras lokal atau perangkat di dekat tempat data dihasilkan, tanpa mengirimnya ke cloud. Model kecil (SLM) adalah model bahasa ringkas (biasanya 1 hingga 14 miliar parameter) yang dirancang untuk berjalan efisien pada perangkat keras ini. Kombinasi keduanya memungkinkan organisasi menjalankan inferensi AI secara lokal dengan latensi 50 hingga 200 milidetik, tanpa bergantung pada koneksi jaringan — sambil mempertahankan kedaulatan data penuh dan memangkas biaya inferensi hingga 75% dibandingkan API cloud.
Ini adalah pergeseran struktural, bukan tren sesaat.
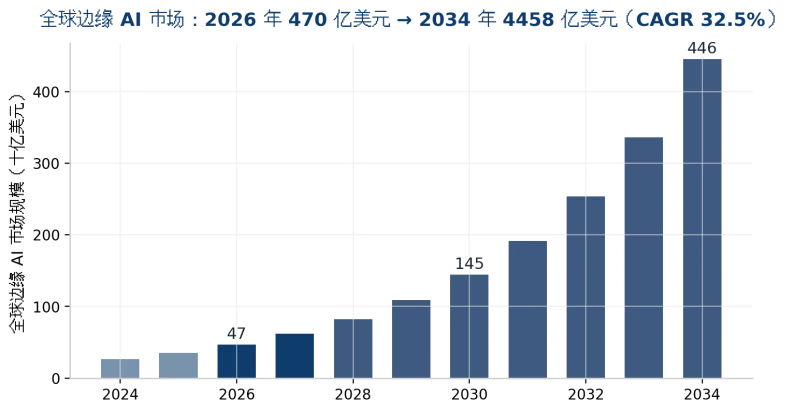
Gartner memperkirakan bahwa pada akhir 2027, 40% organisasi akan menggunakan AI edge untuk memproses data sensitif di lingkungan operasional mereka — sementara pada 2023 angka ini di bawah 5%. Penyebabnya adalah konvergensi tekanan ekonomi, regulasi, dan teknis.
Artikel ini menjawab tiga pertanyaan kunci: mengapa model kecil tiba-tiba menjadi cukup baik; masalah nyata apa yang dipecahkan oleh penerapan AI edge; dan perangkat keras apa yang dibutuhkan organisasi pada 2026 untuk menerapkan AI edge.
Konvergensi tiga pendorong struktural
Pendorong pertama adalah ekonomi: biaya inferensi cloud sangat bervariasi dan sulit diprediksi. Pendorong kedua adalah regulasi: peraturan seperti GDPR, HIPAA, dan undang-undang lokalisasi data Tiongkok membuat pengiriman data sensitif ke infrastruktur cloud eksternal menjadi sulit atau mustahil bagi banyak organisasi. Pendorong ketiga adalah teknis: model kecil kini dapat melakukan banyak tugas yang dua tahun lalu memerlukan LLM raksasa.
Ketiga pendorong ini membuka jendela penerapan yang tidak hanya terbuka bagi raksasa teknologi, tetapi juga bagi usaha kecil dan menengah.
Model kecil versus model besar: Apa yang benar-benar berubah
Label «kecil» dalam SLM menyesatkan. Pada 2026, model dengan 7 hingga 14 miliar parameter dianggap «kecil» — tetapi Phi-4 dari Microsoft, dengan 14 miliar parameter, mencapai akurasi 94% pada benchmark matematika GSM8K, sementara GPT-5 mencapai 87%. Ini bukan pengecualian: dalam domain khusus dengan data terstruktur, model kecil yang disetel secara konsisten mengungguli model umum yang ratusan kali lebih besar.
Alasannya sederhana: pelatihan khusus domain. Model kecil yang dilatih pada dokumen medis, kontrak hukum, atau laporan pemeliharaan peralatan lebih akurat daripada model umum besar dalam domain tersebut — karena lebih sedikit derau yang harus disaring.
Untuk penerapan edge, ini berarti: model cukup kecil untuk berjalan di Jetson Thor atau komputer industri; respons cukup cepat untuk mendukung aplikasi waktu nyata; dan biaya per inferensi hanya sepersepuluh hingga sepertiga puluh dari panggilan API cloud.
Pada saat yang sama, model kecil bukan untuk segala tujuan. Dalam penalaran multi-langkah yang kompleks, pembuatan konten panjang, dan tugas yang menuntut pengetahuan umum luas, model besar masih unggul. Itulah mengapa masa depan adalah hibrida — bukan penggantian.
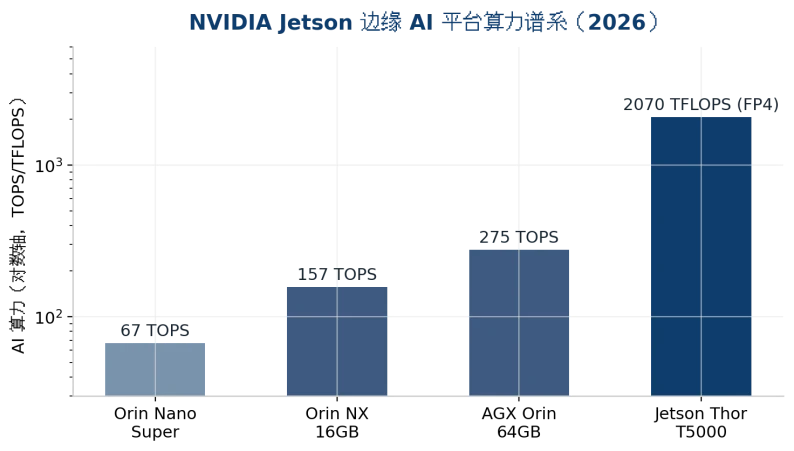
Tingkat perangkat keras | Platform representatif | Daya (TOPS) | RAM yang direkomendasikan | Konsumsi daya |
Perkiraan harga | Aplikasi utama | Ringkas / tingkat awal | Jetson Orin Nano / NUC | 67 TOPS |
8 hingga 16GB | 15 hingga 30W | 400 hingga 800 dolar | Sensor, kamera | Industri menengah |
Jetson AGX Orin / IPC | 157 hingga 275 TOPS | 32 hingga 64GB | 30 hingga 100W | 1.500 hingga 5.000 dolar |
Inspeksi visual, robotika | Kelas atas / profesional | Jetson Thor / RTX 5090 | 2070 teraflop FP4 | 48GB ke atas |
300 hingga 700W | 4.699 dolar ke atas | AI fisik, inferensi berat | Perusahaan / pusat data edge | RTX 6000 Ada / H100 |
Arsitektur hibrida dalam praktik
AI hibrida berarti model kecil lokal menangani pengumpulan data, pra-pemrosesan, tugas waktu nyata, dan respons awal, sementara LLM cloud digunakan untuk penalaran kompleks, pencarian pengetahuan, dan pekerjaan kreatif. Arsitektur ini mempertahankan keunggulan keduanya: latensi rendah dan kedaulatan data di edge, daya komputasi tinggi di cloud.
Penelitian menunjukkan 80 hingga 95% beban kerja inferensi produksi dapat dilakukan oleh model kecil di edge, dan hanya 5 hingga 20% yang benar-benar memerlukan model cloud besar. AT&T memangkas biaya inferensi 90% dan meningkatkan kecepatan respons 70% melalui perutean cerdas — hanya mengirimkan kueri kompleks ke model besar.
Penerapan privat: kedaulatan data sebagai keunggulan kompetitif
Bagi manufaktur, energi, transportasi, dan layanan keuangan, penerapan AI privat bukan sekadar persyaratan regulasi — melainkan keunggulan kompetitif. Ketika model berjalan di dalam jaringan organisasi, data tidak pernah keluar: tidak untuk pelatihan, tidak untuk pemrosesan. Ini menghilangkan risiko kebocoran data, pelanggaran perjanjian kerahasiaan, dan ketergantungan pada vendor.
Dari segi biaya juga menarik: penerapan edge dilakukan dengan satu kali investasi perangkat keras, dan setelah itu biaya per inferensi hampir nol — sementara API cloud mengenakan biaya setiap panggilan. Untuk aplikasi yang sering berulang (inspeksi visual, pemantauan peralatan, pemrosesan dokumen), perbedaan biaya menjadi jelas dalam beberapa bulan.
Kebangkitan AI fisik
AI fisik — yaitu AI yang berjalan pada robot, kendaraan, dan peralatan industri — menuntut perangkat keras edge, karena keputusan fisik tidak dapat menunggu perjalanan bolak-balik ke cloud. Lengan robotik yang harus merespons dalam 50 milidetik tidak dapat mengandalkan API cloud dengan latensi 200 milidetik.
Di sinilah komputer industri berperan: tidak seperti laptop konsumen, komputer ini dibuat untuk bekerja 24/7 di lingkungan keras — suhu -25 hingga 70 derajat Celcius, tanpa kipas, tahan debu dan getaran. Fitur-fitur ini bukan opsional untuk AI fisik.
Perangkat keras AI edge: panduan pembelian 2026
ChangFan Industrial Computing menyediakan solusi perangkat keras AI edge untuk lingkungan manufaktur, energi, dan transportasi.
Pertanyaan kunci dalam memilih perangkat keras edge adalah: model apa yang ingin Anda jalankan, dengan laju inferensi berapa?
Untuk model 7 hingga 14 miliar parameter (Phi-4, Mistral, Llama 3.x terkuantisasi), NVIDIA Jetson AGX Orin (67 TOPS) atau Jetson Thor (157 hingga 275 TOPS) sudah cukup. Untuk inferensi yang lebih berat dengan model 30 hingga 70 miliar parameter, diperlukan workstation dengan GPU konsumen kelas atas (RTX 5090, 2070 teraflop FP4) atau GPU pusat data ringkas (RTX 6000 Ada, sekitar 1 petaflop FP4).
RAM penting: model 7 miliar parameter terkuantisasi membutuhkan 8 hingga 16GB, model 14 miliar membutuhkan 32 hingga 48GB, dan model 70 miliar terkuantisasi membutuhkan 96GB atau lebih. Memori yang rendah adalah hambatan nyata banyak penerapan edge.
Untuk lingkungan keras (lantai pabrik, luar ruangan, kendaraan), komputer industri tanpa kipas dengan rentang suhu lebar (-25 hingga 70 derajat Celcius) dan catu daya industri adalah keharusan. Perangkat keras konsumen akan rusak dalam beberapa bulan dalam kondisi ini.
Aplikasi praktis berdasarkan industri
Manufaktur: inspeksi visual waktu nyata di lini produksi, pemeliharaan prediktif dengan analisis getaran dan suara, optimalisasi parameter proses. Keunggulan edge: keputusan penghentian lini dalam milidetik, bukan detik.
Energi dan infrastruktur: pemantauan peralatan di lokasi terpencil tanpa cakupan jaringan yang andal, deteksi anomali di gardu induk, prediksi kegagalan turbin. Keunggulan edge: operasi independen dari koneksi internet.