Bagaimana Memilih Server AI? Panduan Lengkap Konfigurasi Perangkat Keras Pelatihan dan Inferensi 2026
Pendahuluan: Mengapa Pemilihan Server AI Menjadi Pelajaran Wajib Tahun 2026
Struktur belanja komputasi AI sedang berubah secara fundamental. Analisis yang dirilis McKinsey pada Februari 2026 menunjukkan bahwa pada 2030, inferensi (inference) akan melampaui pelatihan menjadi beban dominan pusat data AI, mencakup lebih dari separuh seluruh komputasi AI dan sekitar 30%–40% dari total kebutuhan pusat data. Artinya, logika keputusan pengadaan server perusahaan sedang bergeser dari "menumpuk kartu untuk pelatihan" menjadi "menghitung cermat untuk menjalankan inferensi" — salah memilih konfigurasi, harganya bukan sekadar membeli terlalu mahal satu kali, melainkan membayar listrik dan sewa untuk arsitektur yang salah setiap hari selama tiga tahun ke depan.
Sementara itu, ritme iterasi produk GPU jelas makin cepat: VRAM 141GB H200 belum sempat "hangat", B200 192GB dan B300 288GB sudah meluncur, sementara RTX PRO 6000 dengan VRAM 96GB dan bentuk PCIe memotong pasar inferensi kelas menengah. Semakin banyak model, pilihan justru semakin sulit. Artikel ini menggunakan satu poros keputusan dan dua tabel perbandingan untuk menjelaskan pemilihan server AI 2026 dengan gamblang.
Apa sebenarnya perbedaan server pelatihan dan server inferensi?
Jawaban singkat: pelatihan adalah proyek satu kali yang "intensif komputasi", inferensi adalah layanan berkelanjutan yang "intensif VRAM dan bandwidth". Server pelatihan mengejar komputasi puncak interkoneksi multi-kartu (interkoneksi penuh NVLink/NVSwitch, kepadatan daya tinggi, pendingin cairan); server inferensi mengejar throughput stabil per biaya unit (VRAM sanggup memuat model, bandwidth sanggup mengalirkan token, konsumsi daya satu kartu terkendali, andal 7×24).
Pada level perangkat keras, klaster pelatihan memprioritaskan mesin utuh 8 kartu berbentuk SXM dan jaringan IB; penyebaran inferensi punya pilihan lebih luas — workstation satu kartu RTX PRO 6000, server multi-kartu 2U/4U, bahkan node inferensi kecil di sisi edge. Kenyataan 2026: sebagian besar anggaran AI perusahaan dihabiskan untuk inferensi, sehingga pemilihan server juga seharusnya "inferensi dulu, pelatihan sesuai kebutuhan".
Memilih server AI, mengapa VRAM lebih penting daripada komputasi?
Jawaban singkat: kalau model tidak muat di VRAM, TFLOPS setinggi apa pun bernilai nol. Sebuah model bisa berjalan atau tidak tergantung pada berapa banyak VRAM yang dipakai bobot + KV Cache + panjang konteks; hanya setelah termuat, bandwidth, dukungan FP4/FP8, dan harga baru layak dibandingkan.
Aturan praktis (2026): pada presisi FP16, model 70B membutuhkan sekitar 140GB VRAM — satu H200 (141GB) pas memuatnya, kalau tidak harus dua H100; setelah kuantisasi FP8 kebutuhan berkurang setengah; FP4 berkurang setengah lagi, tetapi hanya arsitektur Blackwell (B200/B300/RTX PRO 6000) yang mendukung FP4 secara native. Setiap kali jendela konteks memanjang dua kali lipat, pemakaian KV Cache tumbuh hampir linier — itulah mengapa antara "bisa memuat" dan "bisa melayani dengan baik" masih terpisah oleh bandwidth: H200 sebesar 4.8 TB/s, B200/B300 sebesar 8 TB/s.
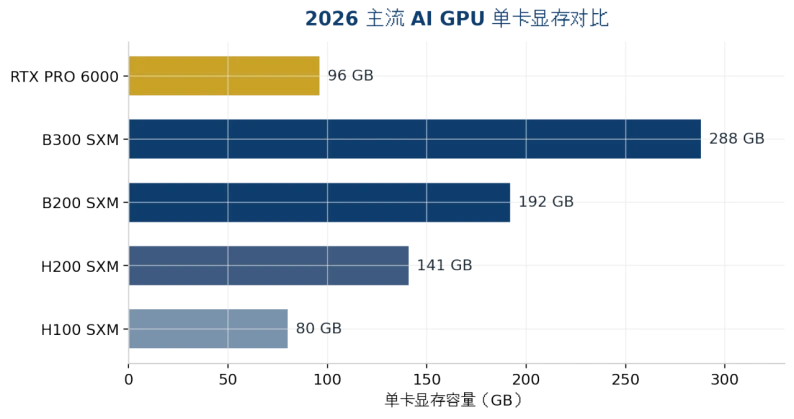
Gambar 1: Perbandingan VRAM per kartu GPU AI utama 2026 (sumber data lihat lampiran)
Bagaimana memilih GPU utama 2026: perbandingan H200, B200, B300, RTX PRO 6000
Jawaban singkat: model di bawah 141GB pilih H200 paling hemat biaya; butuh FP4 atau VRAM lebih besar pilih B200; satu kartu harus memuat model di atas 200GB atau tekanan KV Cache besar pilih B300; inferensi kelas menengah dan lingkungan PCIe pilih RTX PRO 6000.
Dimensi | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arsitektur | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Bandwidth memori | 4.8 TB/s | 8 TB/s | 8 TB/s | Sekitar 1.8 TB/s |
Komputasi FP4 | Tidak didukung | 9 PFLOPS | 15 PFLOPS | Didukung (level satu kartu) |
TDP / Pendinginan | 700W / pendingin udara memungkinkan | 1000W / disarankan pendingin cairan | Sekitar 1400W / pada dasarnya perlu pendingin cairan | 600W / pendingin udara |
Positioning khas | Inferensi 70B–100B, fine-tuning | Inferensi 100B+, pelatihan | Menampung model besar frontier dalam satu mesin | Inferensi kelas menengah, workstation/edge |
Referensi sewa cloud 2026 | Sekitar $4.4/GPU·jam | Sekitar $5–7/GPU·jam | Sekitar $7.4–8.3/GPU·jam | Utamanya pembelian mesin utuh |
Tabel 1: Perbandingan spesifikasi kunci dan positioning GPU AI utama 2026 (harga adalah nilai referensi pasar Agustus 2026, sangat berfluktuasi, minta penawaran ulang sebelum pengadaan)
Ada dua tren lagi yang mudah diabaikan: pertama, harga sewa cloud median H200 telah naik sekitar 25% sejak Agustus 2025, selisih harga Hopper dan Blackwell menyempit, jendela "beli model lama lebih hemat" sedang menutup; kedua, RTX PRO 6000 meluncurkan versi Server 400W — dengan anggaran daya yang sama bisa memasang lebih banyak kartu, lebih bersahabat bagi penyedia layanan inferensi yang menagih per token.
Model sebesar apa, mesin dikonfigurasi seberapa?
Jawaban singkat: estimasi batas bawah VRAM dengan "bobot model × 1.2 (menyisakan ruang KV Cache)", lalu cocokkan dengan tabel di bawah untuk menentukan jumlah GPU; model yang melampaui satu node masuk ke paralelisme multi-mesin, di mana jaringan lebih penting daripada GPU.
Model target (2026) | Ukuran bobot | Konfigurasi minimum | Bentuk mesin yang direkomendasikan |
7B–14B (kelas Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 atau kartu workstation 48GB | Server inferensi edge tower/2U |
32B–70B (kuantisasi FP8) | 40–80GB | RTX PRO 6000 ×1–2 atau H200 ×1 | Server GPU 2U/4U |
70B FP16 / konteks panjang | Sekitar 140GB+ | H200 ×1 (pas-pasan) atau ×2 (aman) | Server multi-kartu 4U |
DeepSeek V4 Flash (156GB) | Sekitar 156GB | B300 ×1 (ruang sisa sekitar 130GB) | Server pendingin cairan 4U |
GLM-5.2 FP8 (sekitar 756GB) | Sekitar 756GB | H200 ×8 atau B300 ×4 | Mesin SXM 8 kartu |
Kimi K3 (1.56TB MXFP4) | Sekitar 1.56TB | B300 ×8 (total VRAM 2.3TB) | Mesin flagship pendingin cairan 8 kartu |
Tabel 2: Tabel perbandingan skala model dan konfigurasi server (bobot mengikuti checkpoint resmi, penyebaran nyata perlu menambah KV Cache dan overhead runtime)
Tabel ini juga menjelaskan mengapa sasis 4U adalah "spesifikasi titik manis" server AI: 8 GPU dual-slot, catu daya redundan, dan saluran udara pendingin yang memadai hanya bisa ditampung ruang 4U sekaligus. 2U cocok untuk node inferensi 2–4 kartu, 1U hanya cocok untuk satu kartu atau sebagai node penjadwal/penyimpanan di depan.
Pendingin udara atau cairan? Bagaimana menentukan spesifikasi pendinginan dan rack?
Jawaban singkat: satu kartu di bawah 700W cukup dengan pendingin udara; satu kartu di atas 1000W, atau daya satu kabinet melebihi 20kW, pendingin cairan berubah dari "nilai tambah" menjadi "ambang keras". TDP sekitar 1400W milik B300 pada dasarnya mengunci solusi pendingin cairan.
Urutan pemilihan yang benar: tentukan model dan GPU dulu, lalu daya seluruh mesin, terakhir hitung mundur pendinginan dan kondisi ruang server. Banyak perusahaan melakukannya terbalik — membeli mesin dulu, lalu baru menyadari pasokan listrik dan AC ruang server tidak sanggup, terpaksa berjalan dengan clock diturunkan, sama saja membayar untuk GPU "tidak bertenaga penuh". Sebelum pengadaan pastikan tiga hal: pasokan listrik kabinet (kW), suhu dan volume udara masuk, serta ruang upgrade untuk 2–3 generasi GPU ke depan (setelah B300, TDP hanya akan lebih tinggi).
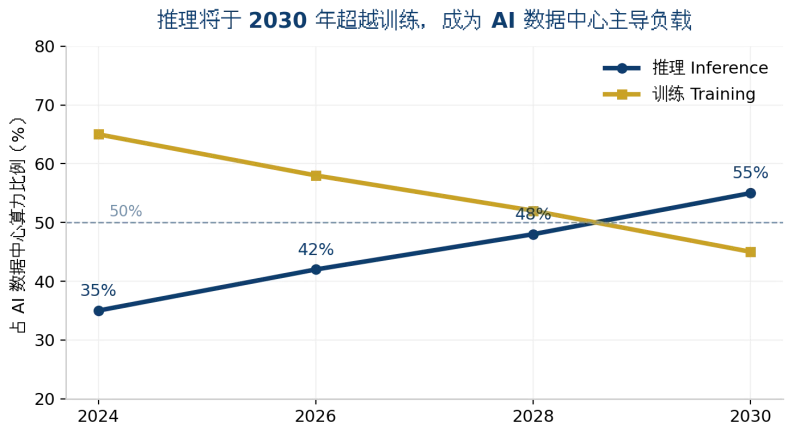
Gambar 2: Inferensi akan melampaui pelatihan menjadi beban dominan pusat data AI pada 2030 (ilustrasi tren, sumber data lihat lampiran)
Sewa cloud atau bangun sendiri? Bagaimana menghitung biayanya?
Jawaban singkat: utilisasi di bawah 60% pilih sewa cloud, beban tinggi jangka panjang pilih bangun sendiri. Dengan harga pasar Agustus 2026, sewa cloud H200 sekitar 4.4/GPU·jam, satu kartu berjalan penuh setahun menghabiskan sewa sekitar38.000 — mendekati biaya membeli satu kartu sendiri; begitu utilisasi tinggi, membangun sendiri segera balik modal.
Kubu bangun sendiri masih harus menambahkan tiga hal: listrik ruang server dan pemeliharaan pendinginan (sekitar 20%–30% dari total biaya kepemilikan), depresiasi iterasi GPU (pada 2026 H100 sudah terdiskon dalam, risiko nilai sisa nyata adanya), serta kepatuhan data — data klien keuangan, medis, dan pemerintah tidak boleh keluar dari jaringan internal, sehingga penyebaran privat bukan soal pilihan melainkan kewajiban. Arsitektur hibrida sedang menjadi arus utama: pelatihan puncak di cloud, inferensi tetap di lokal.
ChangFan Industrial Computing: Server GPU dan Perangkat Keras AI yang Siap untuk Era Inferensi
Pemilihan server AI pada akhirnya bukan adu tabel parameter, melainkan "tingkat kecocokan konfigurasi dengan skenario". Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) menyediakan server GPU rackmount dan mesin inferensi AI yang mencakup 1U/2U/4U, mendukung ekspansi multi-kartu, catu daya redundan, dan desain suhu luas, serta dapat menyesuaikan jumlah GPU, konfigurasi VRAM, dan solusi pendingin udara/cairan sesuai skala model target — menghadirkan fondasi perangkat keras yang stabil dan andal untuk skenario seperti penyebaran model besar privat, node inferensi edge, dan basis pengetahuan perusahaan.
Jika Anda sedang mengevaluasi pengadaan dan penyebaran server GPU kelas H200/B200/B300 atau RTX PRO 6000, silakan hubungi ChangFan Industrial Computing untuk mendapatkan saran konfigurasi dan solusi mesin utuh untuk model target Anda (kami menjual perangkat keras dan membuat mesin utuh, tidak menyediakan layanan langganan perangkat lunak).
Pertanyaan Umum (FAQ)
T1: Konfigurasi minimum apa untuk menjalankan model besar 70B? J: FP16 membutuhkan sekitar 140GB VRAM, satu H200 adalah jawaban paling ekonomis; setelah kuantisasi FP8, dua RTX PRO 6000 (96GB×2) juga mampu, dengan biaya lebih rendah dan penyebaran lebih fleksibel.
T2: Di mana keunggulan B300 dibanding B200, layak ditunggu? J: B300 punya VRAM 50% lebih banyak (288GB vs 192GB), komputasi FP4 1.5 kali lebih tinggi, tetapi bandwidth sama dan TDP naik ke sekitar 1400W sehingga perlu pendingin cairan. Layak ditingkatkan hanya ketika model atau KV Cache melampaui kapasitas node B200.
T3: UKM pertama kali membeli server AI, apa yang direkomendasikan untuk memulai? J: tentukan dulu model yang akan dijalankan. Aplikasi kelas 7B–14B (layanan pelanggan, basis pengetahuan, inspeksi kualitas) cukup dimulai dengan satu server inferensi 2U satu kartu; setelah dipastikan beban tinggi jangka panjang, baru diperluas ke 4U multi-kartu.
T4: Apakah server AI wajib memakai pendingin cairan? J: tidak. Skenario satu kartu di bawah 700W dengan kondisi ruang server baik cukup dengan pendingin udara; satu kartu di atas 1000W atau penyebaran multi-kabinet berkepadatan tinggi baru memerlukan pendingin cairan. Saat memilih, sisakan margin sesuai tren konsumsi daya 2–3 generasi GPU ke depan.
T5: GPU cloud semurah ini, mengapa masih harus membeli server sendiri? J: tiga alasan — saat utilisasi melebihi sekitar 60%, membangun sendiri lebih murah; data sensitif tidak boleh keluar jaringan internal; inferensi lokal tanpa latensi jaringan dan SLA bisa dikendalikan sendiri. Sebagian besar perusahaan akhirnya mengadopsi arsitektur hibrida "pelatihan di cloud, inferensi di lokal".