AI Sunucusu Nasıl Seçilir? 2026 Eğitim ve Çıkarım Donanım Yapılandırma Tam Kılavuzu
Giriş: AI Sunucusu Seçimi Neden 2026'nın Zorunlu Dersi Oldu
AI hesaplama harcamalarının yapısı kökten değişiyor. McKinsey'in Şubat 2026'da yayımladığı analiz, 2030'a kadar çıkarımın (inference) eğitimi geçerek AI veri merkezlerinin baskın yükü olacağını, tüm AI hesaplamanın yarısından fazlasını ve toplam veri merkezi talebinin yaklaşık %30–40'ını oluşturacağını gösteriyor. Bu, kurumların sunucu satın alma mantığının "eğitim için kart yığmaktan" "hesabını bilerek çıkarım çalıştırmaya" kaydığı anlamına geliyor — yanlış yapılandırma seçmenin bedeli bir kerelik pahalı satın alma değil, önümüzdeki üç yıl boyunca her gün yanlış mimari için elektrik ve kira ödemektir.
Aynı zamanda GPU ürünlerinin yenilenme ritmi belirgin şekilde hızlandı: H200'ün 141GB VRAM'i daha ısınmadan B200'ün 192GB'ı ve B300'ün 288GB'ı yayıldı, RTX PRO 6000 ise 96GB VRAM ve PCIe formuyla orta segment çıkarım pazarından pay aldı. Model çoğaldıkça seçim zorlaşıyor. Bu yazı tek bir karar ekseni ve iki karşılaştırma tablosuyla 2026 AI sunucusu seçimini netleştiriyor.
Eğitim sunucusu ile çıkarım sunucusu arasındaki fark tam olarak nedir?
Kısa yanıt: eğitim "hesaplama yoğun" tek seferlik büyük bir projedir, çıkarım ise "VRAM ve bant genişliği yoğun" sürekli bir hizmettir. Eğitim sunucuları çok kartlı bağlantının azami hesaplama gücünü hedefler (tam NVLink/NVSwitch bağlantısı, yüksek güç yoğunluğu, sıvı soğutma); çıkarım sunucuları birim maliyet başına istikrarlı iş hacmini hedefler (VRAM modele yetsin, bant genişliği token üretebilsin, tek kart güç tüketimi kontrol altında, 7×24 güvenilir).
Donanıma indirgendiğinde, eğitim kümeleri öncelikle SXM formunda 8 kartlı bütün makineleri ve IB ağını tercih eder; çıkarım dağıtımı ise daha geniş seçeneklere sahiptir — tek kartlı RTX PRO 6000 iş istasyonu, 2U/4U çok kartlı sunucular, hatta uçta küçük çıkarım düğümleri. 2026 gerçeği: kurumların AI bütçesinin büyük çoğunluğu çıkarıma harcanıyor, sunucu seçimi de "önce çıkarım, eğitim ihtiyaç oldukça" olmalı.
AI sunucusu seçerken VRAM neden hesaplama gücünden daha önemli?
Kısa yanıt: model VRAM'e sığmıyorsa TFLOPS ne kadar yüksek olursa olsun sıfırdır. Bir modelin çalışıp çalışamayacağı, ağırlıklar + KV Cache + bağlam uzunluğunun ne kadar VRAM kapladığına bağlıdır; ancak sığdıktan sonra bant genişliği, FP4/FP8 desteği ve fiyat karşılaştırması anlam kazanır.
Pratik kural (2026): FP16 hassasiyetinde 70B model yaklaşık 140GB VRAM ister — tek H200 (141GB) tam sığar, aksi hâlde iki H100 gerekir; FP8 nicelemesinden sonra ihtiyaç yarıya iner; FP4 bir yarıya daha indirir ama FP4'ü yalnızca Blackwell mimarisi (B200/B300/RTX PRO 6000) yerel olarak destekler. Bağlam penceresi her iki katına çıktığında KV Cache kullanımı neredeyse doğrusal büyür — işte bu yüzden "sığdırabilmek" ile "iyi hizmet verebilmek" arasında bant genişliği durur: H200 4.8 TB/s, B200/B300 8 TB/s.
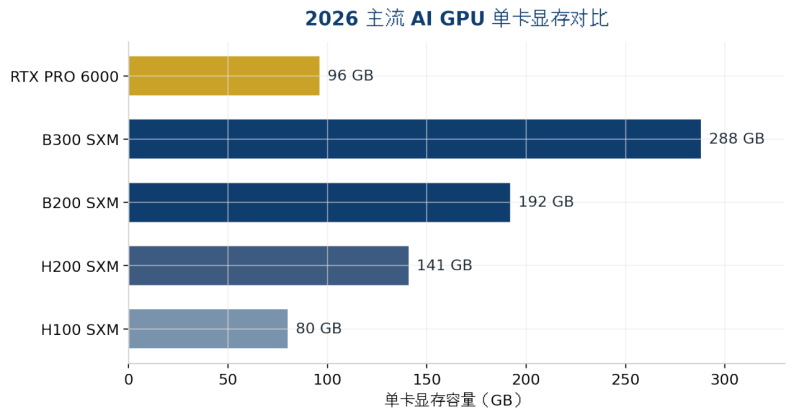
Şekil 1: 2026 ana akım AI GPU kart başına VRAM karşılaştırması (veri kaynağı için eke bakınız)
2026 ana akım GPU'ları nasıl seçilir: H200, B200, B300, RTX PRO 6000 karşılaştırması
Kısa yanıt: 141GB içindeki modeller için H200 en yüksek fiyat/performans; FP4 veya daha büyük VRAM gerekiyorsa B200; tek kartın 200GB üzeri model taşıması veya KV Cache baskısı yüksekse B300; orta segment çıkarım ve PCIe ortamları için RTX PRO 6000.
Boyut | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Mimari | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Bellek bant genişliği | 4.8 TB/s | 8 TB/s | 8 TB/s | Yaklaşık 1.8 TB/s |
FP4 hesaplama | Desteklenmiyor | 9 PFLOPS | 15 PFLOPS | Destekleniyor (tek kart düzeyi) |
TDP / Soğutma | 700W / hava soğutma mümkün | 1000W / sıvı soğutma önerilir | Yaklaşık 1400W / fiilen sıvı soğutma gerekir | 600W / hava soğutma |
Tipik konumlandırma | 70B–100B çıkarım, ince ayar | 100B+ çıkarım, eğitim | Sınır büyük modellerin tek makinede barındırılması | Orta segment çıkarım, iş istasyonu/uç |
2026 bulut kira referansı | Yaklaşık $4.4/GPU·saat | Yaklaşık $5–7/GPU·saat | Yaklaşık $7.4–8.3/GPU·saat | Ağırlıklı olarak bütün makine satın alımı |
Tablo 1: 2026 ana akım AI GPU temel özellik ve konumlandırma karşılaştırması (fiyatlar Ağustos 2026 piyasa referans değerleridir, dalgalanma yüksektir, satın almadan önce yeniden fiyat isteyin)
Kolayca gözden kaçan iki eğilim daha var: birincisi, H200'ün ortanca bulut kira fiyatı Ağustos 2025'ten bu yana yaklaşık %25 arttı, Hopper ile Blackwell arasındaki fiyat farkı daralıyor, "eski modeli alıp tasarruf etme" penceresi kapanıyor; ikincisi, RTX PRO 6000'in 400W Server sürümü çıktı — aynı güç bütçesiyle daha fazla kart kurulabiliyor, token başına ücretlendiren çıkarım hizmeti sağlayıcıları için daha dostça.
Model ne kadar büyükse makine nasıl yapılandırılmalı?
Kısa yanıt: "model ağırlıkları × 1.2 (KV Cache payı)" ile VRAM alt sınırını tahmin edin, sonra aşağıdaki tabloyla GPU sayısını belirleyin; tek düğümü aşan modeller çok makineli paralelliğe geçer, orada ağ GPU'dan daha önemlidir.
Hedef model (2026) | Ağırlık boyutu | Asgari yapılandırma | Önerilen makine formu |
7B–14B (Qwen/Phi sınıfı) | 15–30GB (FP16) | RTX PRO 6000 ×1 veya 48GB iş istasyonu kartı | Kule/2U uç çıkarım sunucusu |
32B–70B (FP8 nicelemeli) | 40–80GB | RTX PRO 6000 ×1–2 veya H200 ×1 | 2U/4U GPU sunucusu |
70B FP16 / uzun bağlam | Yaklaşık 140GB+ | H200 ×1 (zar zor) veya ×2 (güvenli) | 4U çok kartlı sunucu |
DeepSeek V4 Flash (156GB) | Yaklaşık 156GB | B300 ×1 (yaklaşık 130GB pay) | 4U sıvı soğutmalı sunucu |
GLM-5.2 FP8 (yaklaşık 756GB) | Yaklaşık 756GB | H200 ×8 veya B300 ×4 | 8 kartlı SXM bütün makine |
Kimi K3 (1.56TB MXFP4) | Yaklaşık 1.56TB | B300 ×8 (toplam 2.3TB VRAM) | 8 kartlı sıvı soğutmalı amiral makine |
Tablo 2: Model ölçeği ile sunucu yapılandırması karşılık tablosu (ağırlıklar resmî checkpoint esaslıdır, gerçek dağıtımda KV Cache ve çalışma zamanı yükü eklenmelidir)
Bu tablo aynı zamanda 4U kasanın neden AI sunucularının "tatlı nokta özelliği" olduğunu açıklıyor: 8 çift genişlikli GPU, yedekli güç kaynağı ve yeterli soğutma hava kanalı ancak 4U alana aynı anda sığar. 2U, 2–4 kartlı çıkarım düğümleri için uygundur; 1U yalnızca tek kart veya ön uç zamanlama/depolama düğümü olarak uygundur.
Hava mı sıvı soğutma mı? Soğutma ve raf özellikleri nasıl belirlenir?
Kısa yanıt: tek kart 700W altındaysa hava soğutma yeter; tek kart 1000W üzerindeyse veya kabin başına güç 20kW'ı aşıyorsa sıvı soğutma "artı değer" olmaktan çıkıp "zorunlu eşik" hâline gelir. B300'ün yaklaşık 1400W TDP'si sıvı soğutmayı fiilen zorunlu kılar.
Doğru seçim sırası: önce model ve GPU, sonra tüm makinenin gücü, en son geriye doğru soğutma ve makine odası koşulları. Birçok kurum tersini yapıyor — önce makineyi alıyor, sonra makine odasının elektrik ve klimasının yetmediğini fark ediyor, frekans düşürerek çalışmak zorunda kalıyor; bu da parayla "gücü kırpılmış" GPU almak demek. Satın almadan önce üç şeyi mutlaka doğrulayın: kabin beslemesi (kW), giriş havası sıcaklığı ve debisi, gelecek 2–3 GPU nesli için yükseltme alanı (B300'den sonra TDP ancak artar).
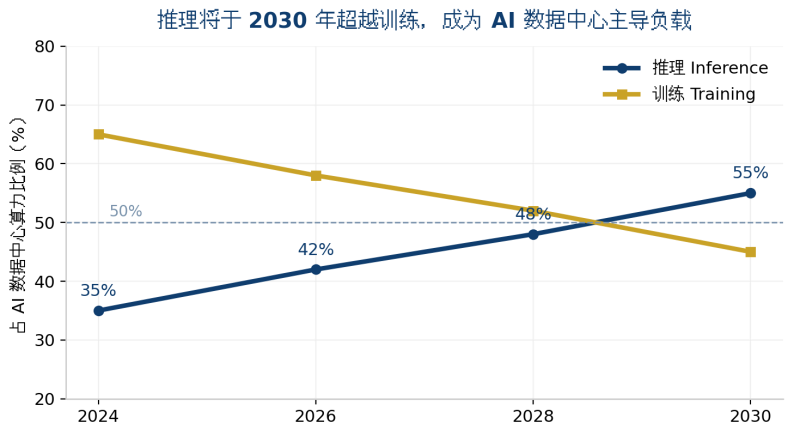
Şekil 2: Çıkarım 2030'da eğitimi geçerek AI veri merkezlerinin baskın yükü olacak (eğilim gösterimi, veri kaynağı için eke bakınız)
Bulut kiralama mı kendi altyapı mı? Maliyet nasıl hesaplanır?
Kısa yanıt: kullanım oranı %60'ın altındaysa bulut kiralayın, uzun vadeli yüksek yük varsa kendi altyapınızı kurun. Ağustos 2026 fiyatlarıyla H200 bulut kirası yaklaşık 4.4/GPU·saat; tam yükte bir kartın yıllık kirası yaklaşık38.000 — neredeyse bir kart satın alma maliyetine eşit; kullanım oranı yükseldikçe kendi altyapı kendini amorti eder.
Kendi altyapısını kuranların hesabına üç kalem daha eklenir: makine odası elektriği ve soğutma bakımı (toplam sahip olma maliyetinin yaklaşık %20–30'u), GPU nesil amortismanı (2026'da H100 derin indirimde, kalıntı değer riski gerçek) ve veri uyumluluğu — finans, sağlık, kamu kurumu müşterilerinin verileri iç ağdan çıkamaz, özel dağıtım seçenek değil zorunluluktur. Hibrit mimari ana akım oluyor: pik eğitim bulutta, kalıcı çıkarım yerelde.
ChangFan Industrial Computing: Çıkarım Çağına Hazır GPU Sunucuları ve AI Donanımı
AI sunucusu seçiminde son söz parametre tablosu değil, "yapılandırmanın senaryoyla uyumu"dur. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan), 1U/2U/4U kapsayan raf tipi GPU sunucuları ve AI çıkarım makineleri sunar; çok kartlı genişleme, yedekli güç kaynağı ve geniş sıcaklık tasarımını destekler; hedef model ölçeğine göre GPU sayısı, VRAM yapılandırması ve hava/sıvı soğutma çözümü özelleştirilebilir — özel büyük model dağıtımı, uç çıkarım düğümleri ve kurumsal bilgi tabanı gibi senaryolara istikrarlı ve güvenilir donanım temeli sağlar.
H200/B200/B300 veya RTX PRO 6000 sınıfı GPU sunucularının satın alımını ve dağıtımını değerlendiriyorsanız, hedef modeliniz için yapılandırma önerisi ve bütün makine çözümü almak üzere ChangFan Industrial Computing ile iletişime geçebilirsiniz (donanım satıyoruz, bütün makine üretiyoruz; yazılım abonelik hizmeti sunmuyoruz).
Sık Sorulan Sorular (SSS)
S1: 70B büyük model çalıştırmak için en az hangi yapılandırma gerekir? C: FP16'da yaklaşık 140GB VRAM gerekir, tek H200 en ekonomik yanıttır; FP8 nicelemesinden sonra iki RTX PRO 6000 (96GB×2) da iş görür, maliyeti daha düşük ve dağıtımı daha esnektir.
S2: B300, B200'den nerede güçlü, beklemeye değer mi? C: B300'ün VRAM'i %50 daha fazla (288GB'a karşı 192GB), FP4 hesaplama 1.5 kat yüksek; ancak bant genişliği aynı ve TDP yaklaşık 1400W'a çıktığı için sıvı soğutma gerekir. Model veya KV Cache, B200 düğüm kapasitesini aştığında yükseltmeye değer.
S3: KOBİ'ler ilk AI sunucusunu alırken nereden başlamalı? C: önce çalıştırılacak modeli netleştirin. 7B–14B sınıfı uygulamalar (müşteri hizmetleri, bilgi tabanı, kalite kontrol) tek kartlı 2U çıkarım sunucusuyla başlayabilir; uzun vadeli yüksek yük kesinleşince 4U çok karta genişleyin.
S4: AI sunucusu mutlaka sıvı soğutma ister mi? C: hayır. Tek kart 700W altında ve makine odası koşulları iyiyse hava soğutma yeterlidir; tek kart 1000W üstü veya yüksek yoğunluklu çok kabinli dağıtımlar sıvı soğutma ister. Seçimde gelecek 2–3 GPU neslinin güç eğilimine göre pay bırakın.
S5: Bulut GPU bu kadar ucuzken neden sunucu satın alalım? C: üç neden — kullanım oranı yaklaşık %60'ı aştığında kendi altyapı daha ucuz; hassas veriler iç ağdan çıkamaz; yerel çıkarımda ağ gecikmesi yok ve SLA kendi kontrolünüzde. Çoğu kurum sonunda "eğitim bulutta, çıkarım yerelde" hibrit mimarisini benimser.