Jak wybrać serwer AI? Kompletny przewodnik 2026 po konfiguracji sprzętowej dla treningu i wnioskowania
Wprowadzenie: dlaczego wybór serwera AI stał się obowiązkową lekturą 2026 roku
Struktura wydatków na obliczenia AI zmienia się zasadniczo. Według analizy McKinsey opublikowanej w lutym 2026 roku do 2030 roku wnioskowanie wyprzedzi trening jako dominujące obciążenie w centrach danych AI — ponad połowa wszystkich obliczeń AI i około 30–40% całkowitego zapotrzebowania centrów danych. Dla przedsiębiorstw logika zakupu serwerów przesuwa się od „piętrzenia kart pod trening” do „ekonomicznego obsługiwania wnioskowania” — błąd w konfiguracji nie kosztuje jednorazowej przepłaty, lecz trzy lata codziennych rachunków za prąd i wynajem niewłaściwej architektury.
Jednocześnie wyraźnie przyspieszył cykl iteracji GPU: zanim 141GB VRAM w H200 zdążyło się ugruntować, już wdrażane są 192GB w B200 i 288GB w B300, a RTX PRO 6000 z 96GB i formatem PCIe zajmuje rynek wnioskowania średniej klasy. Im więcej modeli, tym trudniejszy wybór. Niniejszy artykuł wyjaśnia wybór serwera AI w 2026 roku za pomocą jednej osi decyzyjnej i dwóch tabel porównawczych.
Jaka jest naprawdę różnica między serwerem treningowym a serwerem wnioskującym?
Krótka odpowiedź: trening to jednorazowe, „obliczeniowo intensywne” megaprzedsiewzięcie; wnioskowanie to ciągła usługa „intensywna pod względem VRAM i przepustowości”. Serwer treningowy dąży do szczytowej mocy połączenia wielu GPU (pełna sieć NVLink/NVSwitch, wysoka gęstość mocy, chłodzenie cieczą); serwer wnioskujący — do stabilnej przepustowości na jednostkę kosztu (VRAM mieszczący model, przepustowość dostarczająca tokeny, kontrolowany pobór mocy karty, niezawodność 7×24).
Sprzętowo klastry treningowe stawiają na maszyny 8-GPU w formacie SXM z siecią InfiniBand; wnioskowanie ma znacznie szerszy wachlarz opcji — jednokartowe stacje robocze z RTX PRO 6000, wielokartowe serwery 2U/4U, a nawet kompaktowe węzły wnioskujące na brzegu sieci. Rzeczywistość 2026 roku: zdecydowana większość budżetów AI przedsiębiorstw trafia na wnioskowanie, więc i serwery należy dobierać według zasady „wnioskowanie przede wszystkim, trening według potrzeb”.
Dlaczego przy wyborze serwera AI VRAM jest ważniejsza niż moc obliczeniowa?
Krótka odpowiedź: jeśli model nie mieści się w VRAM, najwyższe TFLOPS są zerem. To, czy model zadziała, zależy od tego, ile VRAM zajmują wagi + KV Cache + długość kontekstu; dopiero gdy model się mieści, porównania przepustowości, obsługi FP4/FP8 i ceny nabierają sensu.
Reguła praktyczna (2026): w precyzji FP16 model 70B wymaga około 140GB VRAM — pojedyncza H200 (141GB) mieści go dokładnie, w przeciwnym razie potrzebne są dwie H100; kwantyzacja FP8 zmniejsza zapotrzebowanie o połowę; FP4 — o kolejną połowę, ale tylko architektura Blackwell (B200/B300/RTX PRO 6000) obsługuje FP4 natywnie. Każde podwojenie okna kontekstu zwiększa zajętość KV Cache niemal liniowo — dlatego między „mieści się” a „dobrze obsługuje” stoi przepustowość: H200 oferuje 4,8 TB/s, a B200/B300 — 8 TB/s.
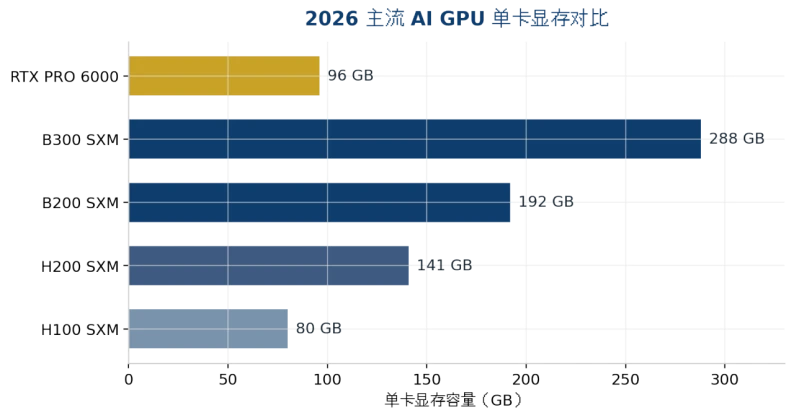
Rysunek 1: Porównanie VRAM na kartę wiodących GPU AI w 2026 roku (źródła danych w załączniku)
Jak wybierać spośród GPU roku 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Krótka odpowiedź: dla modeli do 141GB najlepszy stosunek ceny do jakości daje H200; gdy potrzebujesz FP4 lub więcej VRAM — B200; gdy pojedyncza karta ma pomieścić model powyżej 200GB lub presja KV Cache jest duża — B300; do wnioskowania średniej klasy i środowisk PCIe — RTX PRO 6000.
Wymiar | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architektura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Przepustowość pamięci | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Moc FP4 | Nieobsługiwana | 9 PFLOPS | 15 PFLOPS | Obsługiwana (klasa jednokartowa) |
TDP / chłodzenie | 700 W / powietrze możliwe | 1000 W / ciecz zalecana | ~1400 W / ciecz praktycznie wymagana | 600 W / powietrze |
Typowe pozycjonowanie | Wnioskowanie 70B–100B, fine-tuning | Wnioskowanie 100B+, trening | Wiodące LLM na jednym węźle | Wnioskowanie średniej klasy, stacje/brzeg |
Referencja wynajmu chmurowego 2026 | ~$4.4/GPU·godz. | ~$5–7/GPU·godz. | ~$7.4–8.3/GPU·godz. | Przede wszystkim zakup kompletnych maszyn |
Tabela 1: Kluczowe specyfikacje i pozycjonowanie wiodących GPU AI w 2026 roku (ceny — wartości referencyjne rynku z sierpnia 2026, bardzo zmienne — przed zakupem poproś o aktualną wycenę)
Są jeszcze dwa łatwe do przeoczenia trendy: po pierwsze, mediana ceny wynajmu H200 w chmurze wzrosła od sierpnia 2025 o około 25%, różnica cenowa między Hopper a Blackwell maleje, a okno „oszczędzania na starszej generacji” się zamyka; po drugie, RTX PRO 6000 ma już wersję Server o mocy 400 W, pozwalającą zmieścić więcej kart w tym samym budżecie energetycznym — korzystne dla dostawców wnioskowania rozliczających się za token.
Jak duży model, taka maszyna?
Krótka odpowiedź: oszacuj dolną granicę VRAM jako „wagi modelu × 1,2 (zapas na KV Cache)”, a następnie określ liczbę GPU na podstawie poniższej tabeli; modele przekraczające pojedynczy węzeł przechodzą do równoległości wielomaszynowej, gdzie sieć jest ważniejsza niż GPU.
Model docelowy (2026) | Rozmiar wag | Konfiguracja minimalna | Zalecany format |
7B–14B (klasa Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 lub karta stacji 48GB | Brzegowy serwer wnioskujący tower/2U |
32B–70B (kwantyzacja FP8) | 40–80GB | RTX PRO 6000 ×1–2 lub H200 ×1 | Serwer GPU 2U/4U |
70B FP16 / długi kontekst | ~140GB+ | H200 ×1 (na styk) lub ×2 (pewnie) | Serwer wielokartowy 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (zapas ~130GB) | Serwer 4U z chłodzeniem cieczą |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 lub B300 ×4 | System SXM z 8 GPU |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (łącznie 2,3TB VRAM) | Flagowy system 8-GPU z chłodzeniem cieczą |
Tabela 2: Dopasowanie wielkości modelu do konfiguracji serwera (wagi według oficjalnych checkpointów; w rzeczywistym wdrożeniu należy doliczyć KV Cache i narzut środowiska uruchomieniowego)
Ta tabela wyjaśnia też, dlaczego obudowa 4U jest „złotym środkiem” serwerów AI: 8 kart GPU o podwójnej szerokości, redundantne zasilacze i wystarczające kanały chłodzące — tylko przestrzeń 4U pomieści to wszystko naraz. 2U nadaje się do węzłów wnioskujących z 2–4 kartami; 1U mieści tylko jedną kartę lub pełni rolę przedniego węzła planowania/przechowywania.
Chłodzenie powietrzem czy cieczą? Jak ustalić specyfikacje termiczne i rack?
Krótka odpowiedź: poniżej 700 W na kartę wystarczy chłodzenie powietrzem; powyżej 1000 W na kartę — lub powyżej 20 kW na szafę — chłodzenie cieczą zmienia się z „bonusu” w „twarde wymaganie”. TDP B300 na poziomie ~1400 W praktycznie przesądza o chłodzeniu cieczą.
Prawidłowa kolejność doboru to: najpierw model i GPU, potem moc całej maszyny, a dopiero na końcu wsteczne wyliczenie chłodzenia i warunków serwerowni. Wiele firm robi odwrotnie — kupuje maszyny, po czym odkrywa, że zasilanie i klimatyzacja nie wyrabiają, i musi obniżać taktowanie: to jak kupienie za pełną cenę „okaleczonej” GPU. Przed zakupem koniecznie potwierdź trzy rzeczy: zasilanie szafy (kW), temperaturę i strumień powietrza nawiewanego oraz zapas na kolejne 2–3 generacje GPU (po B300 wartości TDP będą tylko rosnąć).
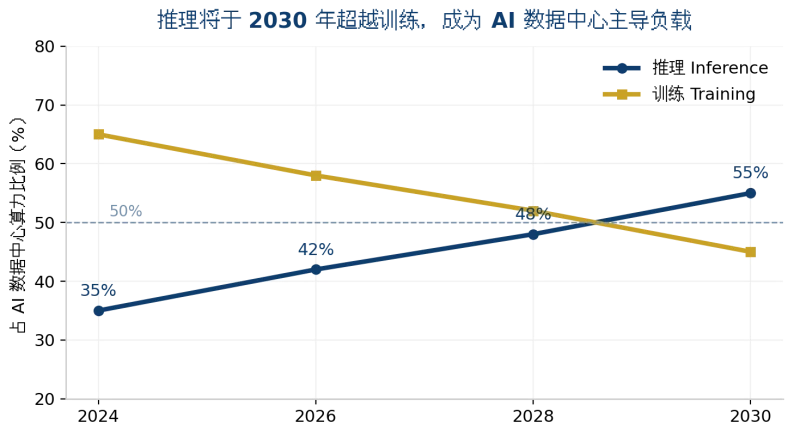
Rysunek 2: Do 2030 roku wnioskowanie wyprzedzi trening jako dominujące obciążenie centrów danych AI (ilustracja trendu; źródła danych w załączniku)
Wynajem w chmurze czy własna infrastruktura? Jak to policzyć?
Krótka odpowiedź: przy wykorzystaniu poniżej 60% opłaca się chmura; przy trwale wysokim obciążeniu — własna infrastruktura. Według notowań z sierpnia 2026 wynajem H200 w chmurze kosztuje około 4,4 /GPU·godz. — około 38 tys. za pełny rok pracy z pełnym obciążeniem, czyli blisko ceny zakupu jednej karty. Im wyższe wykorzystanie, tym szybciej własna infrastruktura się zwraca.
Do rachunku własnej infrastruktury trzeba doliczyć jeszcze trzy pozycje: energię i eksploatację chłodzenia (około 20–30% całkowitego kosztu posiadania), amortyzację wynikającą ze zmian generacji GPU (w 2026 roku H100 jest już głęboko przeceniona — ryzyko wartości rezydualnej jest realne) oraz zgodność danych: klienci finansowi, medyczni i rządowi nie mogą wyprowadzać danych poza intranet, więc wdrożenie prywatne to nie wybór, lecz konieczność. Architektura hybrydowa staje się standardem: szczytowy trening w chmurze, stałe wnioskowanie lokalnie.
ChangFan: serwery GPU i sprzęt AI gotowe na erę wnioskowania
Ostatecznie wybór serwera AI nie wygrywa się w tabelach parametrów, lecz dopasowaniem konfiguracji do scenariusza. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) oferuje serwery GPU w obudowach rack oraz systemy wnioskowania AI w formatach 1U/2U/4U, z rozbudową wielokartową, redundantnymi zasilaczami i rozszerzonym zakresem temperatur. Liczbę GPU, konfigurację VRAM oraz chłodzenie (powietrzem/cieczą) można dostosować do wielkości docelowego modelu — stabilna i niezawodna baza sprzętowa dla prywatnych wdrożeń LLM, brzegowych węzłów wnioskujących i firmowych baz wiedzy.
Jeśli oceniasz zakup i wdrożenie serwerów GPU klasy H200/B200/B300 lub RTX PRO 6000, skontaktuj się z ChangFan, aby uzyskać poradę dotyczącą konfiguracji i ofertę kompletnych systemów dopasowanych do docelowego modelu (sprzedajemy sprzęt i budujemy kompletne maszyny — nie oferujemy usług subskrypcji oprogramowania).
Często zadawane pytania (FAQ)
P1: Jaka jest minimalna konfiguracja do uruchomienia modelu 70B? O: W FP16 potrzeba około 140GB VRAM, więc pojedyncza H200 to najbardziej ekonomiczna odpowiedź; po kwantyzacji FP8 zadanie spełnią też dwie RTX PRO 6000 (96GB×2) — taniej i elastyczniej we wdrożeniu.
P2: Czym B300 jest lepsza od B200 i czy warto czekać? O: B300 ma o 50% więcej VRAM (288GB vs 192GB) i 1,5× mocy FP4, ale taką samą przepustowość oraz TDP podniesione do ~1400 W, wymagające chłodzenia cieczą. Warto przechodzić dopiero, gdy model lub KV Cache przerastają pojemność węzła z B200.
P3: Od czego powinno zacząć MŚP kupujące pierwszy serwer AI? O: Najpierw zdefiniuj model do uruchomienia. Dla zastosowań 7B–14B (obsługa klienta, baza wiedzy, kontrola jakości) na start wystarczy jeden serwer wnioskujący 2U z pojedynczą kartą; po potwierdzeniu trwałego wysokiego obciążenia rozbuduj do 4U wielokartowego.
P4: Czy chłodzenie cieczą jest obowiązkowe w serwerach AI? O: Nie. Poniżej 700 W na kartę i przy dobrych warunkach serwerowni wystarczy powietrze; ciecz potrzebna jest dopiero powyżej 1000 W na kartę lub przy gęstych instalacjach wieloszafowych. Przy doborze zostaw zapas na trend poboru mocy kolejnych 2–3 generacji GPU.
P5: GPU w chmurze są takie tanie — po co kupować własny serwer? O: Trzy powody — powyżej ~60% wykorzystania własna infrastruktura jest tańsza; wrażliwe dane nie mogą opuszczać intranetu; lokalne wnioskowanie nie ma opóźnień sieciowych, a SLA jest pod własną kontrolą. Większość firm kończy na architekturze hybrydowej „trening w chmurze, wnioskowanie lokalnie”.