AIサーバーはどう選ぶ?2026年トレーニング・推論ハードウェア構成完全ガイド
- 広州長帆智能科技有限公司
- 2026-10-10
はじめに:AIサーバー選定が2026年の必修科目となった理由
AIコンピューティング支出の構造が根本から変わりつつあります。McKinseyが2026年2月に発表した分析によると、2030年までに推論(inference)がトレーニングを追い越してAIデータセンターの支配的なワークロードとなり、全AIコンピューティングの半分以上、データセンター総需要の約30%–40%を占めるとされています。つまり、企業のサーバー調達の意思決定ロジックは「トレーニングのためにカードを積み上げる」から「推論を賢く回す」へと移行しているのです——構成を間違えると、一度高い買い物をするだけでは済まず、今後3年間、毎日誤ったアーキテクチャの電気代と賃料を払い続けることになります。
同時に、GPU製品の世代交代のペースが明らかに加速しています。H200の141GB VRAMがまだ温まらないうちに、B200の192GBとB300の288GBが展開され、RTX PRO 6000は96GB VRAMとPCIeフォームファクタでミッドレンジ推論市場を切り取りました。モデルが増えるほど選定はむしろ難しくなります。本稿は1本の意思決定軸と2枚の対照表で、2026年のAIサーバー選定を明快に説きます。
トレーニングサーバーと推論サーバー、一体何が違うのか?
一言で答えると:トレーニングは「コンピューティング集約型」の一過性の大規模プロジェクト、推論は「VRAMと帯域幅集約型」の継続的サービスです。トレーニングサーバーはマルチカード相互接続のピーク性能を追求し(NVLink/NVSwitchフルメッシュ、高電力密度、液冷)、推論サーバーは単位コストあたりの安定したスループットを追求します(VRAMにモデルが収まること、帯域幅がトークンを出力できること、シングルカードの消費電力が制御可能であること、7×24の信頼性)。
ハードウェアに落とし込むと、トレーニングクラスタはSXMフォームファクタの8カード完成品サーバーとIBネットワークを優先し、推論デプロイにはより幅広い選択肢があります——シングルカードのRTX PRO 6000ワークステーション、2U/4Uマルチカードサーバー、さらにはエッジ側の小型推論ノードまで。2026年の現実は、ほとんどの企業のAI予算が推論に費やされているということであり、サーバー選定も「推論優先、トレーニングは必要に応じて」であるべきです。
AIサーバー選定で、なぜVRAMがコンピューティング性能より重要なのか?
一言で答えると:モデルがVRAMに収まらなければ、どれほど高いTFLOPSもゼロです。モデルが動くかどうかは、重み + KV Cache + コンテキスト長がどれだけのVRAMを占有するかで決まります。収まって初めて、帯域幅、FP4/FP8サポート、価格の比較に意味が生まれます。
経験則(2026年):FP16精度では、70Bモデルに約140GBのVRAMが必要で、H200 1枚(141GB)でちょうど収まります。収まらなければH100 2枚が必要です。FP8量子化で必要量は半減し、FP4でさらに半減しますが、FP4をネイティブサポートするのはBlackwellアーキテクチャ(B200/B300/RTX PRO 6000)のみです。コンテキストウィンドウが倍になるたびにKV Cacheの占有量はほぼ線形に増加します——これが「収まる」と「快適にサービスできる」の間に帯域幅という隔たりがある理由です。H200は4.8 TB/s、B200/B300は8 TB/sです。
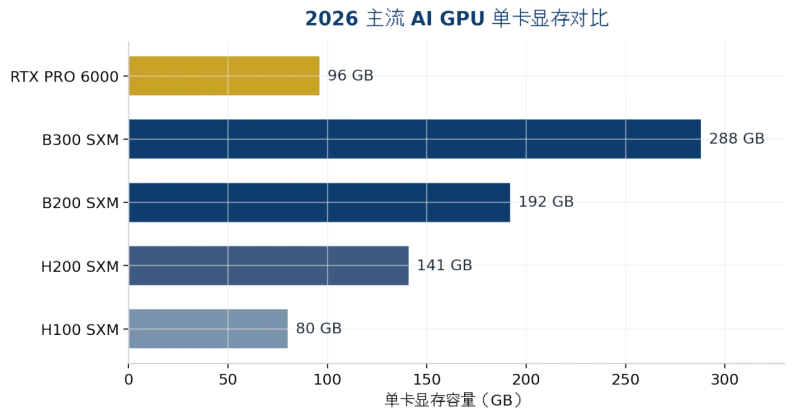
図1:2026年主流AI GPUのシングルカードVRAM比較(データ出典は付録参照)
2026年の主流GPUの選び方:H200、B200、B300、RTX PRO 6000の比較
一言で答えると:141GB以内のモデルならH200が最も費用対効果が高く、FP4やより大きなVRAMが必要ならB200、シングルカードで200GB超のモデルやKV Cache負荷が大きいならB300、ミッドレンジ推論やPCIe環境ならRTX PRO 6000を選びましょう。
次元 | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
アーキテクチャ | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
メモリ帯域幅 | 4.8 TB/s | 8 TB/s | 8 TB/s | 約1.8 TB/s |
FP4演算性能 | 非対応 | 9 PFLOPS | 15 PFLOPS | 対応(シングルカード級) |
TDP / 冷却 | 700W / 空冷可能 | 1000W / 液冷推奨 | 約1400W / 事実上液冷必須 | 600W / 空冷 |
典型的なポジショニング | 70B〜100B推論、ファインチューニング | 100B+推論、トレーニング | フロンティア大規模モデルの単機収容 | ミッドレンジ推論、ワークステーション/エッジ |
2026年クラウドレンタル参考 | 約$4.4/GPU・時間 | 約$5〜7/GPU・時間 | 約$7.4〜8.3/GPU・時間 | 完成品購入が中心 |
表1:2026年主流AI GPUの主要仕様とポジショニング比較(価格は2026年8月の市場参考値で変動が大きいため、購入前に再見積もりが必要)
見落とされがちなトレンドがもう2つあります。1つは、H200のクラウドレンタル中央値が2025年8月以降約25%上昇し、HopperとBlackwellの価格差が縮小して「旧モデルで節約する」窓が閉じつつあること。もう1つは、RTX PRO 6000に400WのServerバージョンが登場し、同じ電力予算でより多くのカードを配置できるため、トークン課金の推論サービス事業者にとって有利になったことです。
モデルの大きさに対して、マシンはどれくらい必要か?
一言で答えると:「モデルの重み × 1.2(KV Cacheの余裕分)」でVRAMの下限を見積もり、下の表と照合してGPU枚数を決めます。単一ノードを超えるモデルはマルチマシン並列に入り、そこではGPUよりネットワークが重要になります。
対象モデル(2026) | 重みのサイズ | 最小構成 | 推奨マシン形態 |
7B〜14B(Qwen/Phi級) | 15〜30GB(FP16) | RTX PRO 6000 ×1 または 48GBワークステーションカード | タワー/2Uエッジ推論サーバー |
32B〜70B(FP8量子化) | 40〜80GB | RTX PRO 6000 ×1〜2 または H200 ×1 | 2U/4U GPUサーバー |
70B FP16 / ロングコンテキスト | 約140GB+ | H200 ×1(ギリギリ)または ×2(余裕あり) | 4Uマルチカードサーバー |
DeepSeek V4 Flash(156GB) | 約156GB | B300 ×1(余裕約130GB) | 4U液冷サーバー |
GLM-5.2 FP8(約756GB) | 約756GB | H200 ×8 または B300 ×4 | 8カードSXM完成品 |
Kimi K3(1.56TB MXFP4) | 約1.56TB | B300 ×8(総VRAM 2.3TB) | 8カード液冷フラッグシップ完成品 |
表2:モデル規模とサーバー構成の対照表(重みは公式チェックポイント基準。実際のデプロイではKV Cacheとランタイムオーバーヘッドを加算する必要あり)
この表は、4UシャーシがAIサーバーの「スイートスポット」である理由も説明しています。デュアルスロットGPU 8枚、冗長電源、十分な冷却風路を同時に収められるのは4Uの空間だけです。2Uは2〜4カードの推論ノードに適し、1Uはシングルカードかフロントエンドのスケジューリング/ストレージノードにのみ適しています。
空冷か液冷か?冷却とラック仕様はどう決める?
一言で答えると:シングルカード700W以下なら空冷で十分。シングルカード1000W以上、またはラックあたりの電力が20kWを超える場合、液冷は「加点項目」から「必須条件」に変わります。B300の約1400WのTDPは事実上液冷を強制します。
正しい選定順序は、まずモデルとGPUを決め、次にシステム全体の電力を決め、最後に冷却とサーバールーム条件を逆算することです。多くの企業は逆の順序で進めます——先にマシンを買い、サーバールームの電源と空調が持たないことに気づき、強制的にクロックダウンして運用する羽目になります。これは「半減した性能」のGPUにお金を払ったのと同じです。購入前に必ず3点を確認してください:ラック給電(kW)、吸気温度と風量、そして将来2〜3世代のGPUのためのアップグレード余地(B300以降、TDPはさらに上がるだけです)。
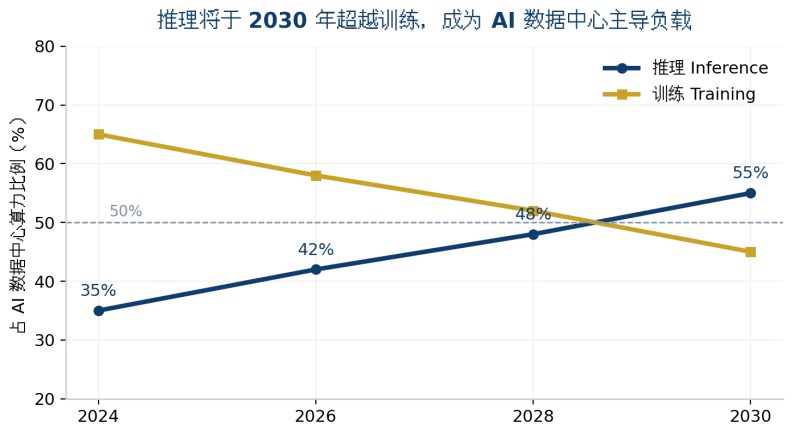
図2:推論は2030年にトレーニングを追い越しAIデータセンターの支配的ワークロードとなる(トレンド示意図、データ出典は付録参照)
クラウドレンタルか自前構築か?コストはどう計算する?
一言で答えると:稼働率が60%未満ならクラウドレンタル、長期的な高負荷なら自前構築を選びましょう。2026年8月の相場では、H200のクラウドレンタルは約4.4/GPU・時間で、1枚のカードを年間フル稼働させた賃料は約38,000——カード1枚の購入コストに近い水準です。稼働率が高まれば自前構築がすぐに元を取ります。
自前構築派の帳簿にはさらに3つの項目が乗ります:サーバールームの電気代と冷却保守(総所有コストの約20%–30%)、GPUの世代交代による減価償却(2026年にはH100が大幅値引きされており、残存価値リスクは現実のものです)、そしてデータコンプライアンス——金融、医療、官公庁顧客のデータは内部ネットワークから出せず、プライベートデプロイは選択肢ではなく必須事項です。ハイブリッドアーキテクチャが主流になりつつあります:ピークのトレーニングはクラウドへ、常駐の推論はオンプレミスへ。
ChangFan Industrial Computing:推論時代に備えるGPUサーバーとAIハードウェア
AIサーバー選定は最終的にスペック表の競争ではなく、「構成とシナリオの適合度」の競争です。Guangzhou ChangFan Intelligent Technology Co., Ltd.(ChangFan Industrial Computing / ChangFan)は、1U/2U/4UをカバーするラックマウントGPUサーバーとAI推論マシンを提供し、マルチカード拡張、冗長電源、広温度設計をサポートします。対象モデルの規模に応じてGPU枚数、VRAM構成、空冷/液冷の冷却ソリューションをカスタマイズでき、プライベート大規模モデルデプロイ、エッジ推論ノード、企業ナレッジベースなどのシナリオに安定した信頼性の高いハードウェア基盤を提供します。
H200/B200/B300またはRTX PRO 6000クラスのGPUサーバーの調達とデプロイをご検討中でしたら、対象モデルに合わせた構成提案と完成品ソリューションについて、ぜひChangFan Industrial Computingにお問い合わせください(ハードウェア販売と完成品製造が専門で、ソフトウェアサブスクリプションサービスは提供していません)。
よくある質問(FAQ)
Q1:70Bの大規模モデルを動かす最低構成は?A:FP16では約140GBのVRAMが必要で、H200 1枚が最も経済的な答えです。FP8量子化後はRTX PRO 6000 2枚(96GB×2)でも対応可能で、コストはより低く、デプロイも柔軟です。
Q2:B300はB200よりどこが強く、待つ価値はある?A:B300はVRAMが50%多く(288GB対192GB)、FP4演算性能が1.5倍高い一方、帯域幅は同じで、TDPが約1400Wに上昇し液冷が必要です。モデルやKV CacheがB200ノードの容量を超えた場合にのみアップグレードする価値があります。
Q3:中小企業が初めてAIサーバーを購入する場合、何から始めるのがおすすめ?A:まず動かすモデルを明確にしましょう。7B〜14B級のアプリケーション(カスタマーサービス、ナレッジベース、品質検査)なら2Uシングルカード推論サーバー1台で始められます。長期的な高負荷が確定してから4Uマルチカードに拡張してください。
Q4:AIサーバーは必ず液冷にすべき?A:いいえ。シングルカード700W以下でサーバールーム条件が良いシナリオなら空冷で十分です。液冷が必要なのはシングルカード1000W以上や高密度マルチラックデプロイの場合です。選定時は将来2〜3世代のGPUの消費電力トレンドに合わせて余裕を確保してください。
Q5:クラウドGPUがこれほど安いのに、なぜサーバーを購入するの?A:3つの理由があります——稼働率が約60%を超えると自前構築の方が安くなること、機密データは内部ネットワークから出せないこと、ローカル推論はネットワーク遅延がなくSLAを自社でコントロールできること。ほとんどの企業は最終的に「トレーニングはクラウド、推論はオンプレミス」のハイブリッドアーキテクチャを採用します。