¿Cómo elegir un servidor de IA? Guía completa 2026 de configuración de hardware para entrenamiento e inferencia
Introducción: por qué elegir el servidor de IA se convirtió en asignatura obligatoria en 2026
La estructura del gasto en computación de IA está cambiando radicalmente. Un análisis publicado por McKinsey en febrero de 2026 señala que hacia 2030 la inferencia superará al entrenamiento como carga dominante en los centros de datos de IA, con más de la mitad de toda la computación de IA y alrededor del 30%–40% de la demanda total de los centros de datos. Para las empresas, la lógica de compra de servidores pasa de «apilar tarjetas para entrenar» a «ejecutar inferencia con costes medidos»: elegir mal la configuración no cuesta un sobreprecio único, sino tres años pagando cada día la electricidad y el alquiler de una arquitectura equivocada.
Al mismo tiempo, el ritmo de iteración de las GPU se ha acelerado claramente: los 141GB de VRAM del H200 aún no se habían asentado cuando ya se despliegan los 192GB del B200 y los 288GB del B300, mientras el RTX PRO 6000 recorta el mercado de inferencia de gama media con 96GB y formato PCIe. Cuantos más modelos, más difícil elegir. Este artículo aclara la elección de servidores de IA en 2026 con un eje de decisión y dos tablas comparativas.
¿Cuál es exactamente la diferencia entre un servidor de entrenamiento y uno de inferencia?
Respuesta rápida: el entrenamiento es un megaproyecto puntual «intensivo en cómputo»; la inferencia es un servicio continuo «intensivo en VRAM y ancho de banda». El servidor de entrenamiento busca la potencia máxima de la interconexión multi-GPU (fabric NVLink/NVSwitch completa, alta densidad de potencia, refrigeración líquida); el servidor de inferencia busca un rendimiento estable por unidad de coste (VRAM que aloja el modelo, ancho de banda que despacha tokens, consumo por tarjeta controlado y fiabilidad 7×24).
En hardware, los clústeres de entrenamiento priorizan máquinas de 8 GPU en formato SXM con red InfiniBand; la inferencia admite un abanico mucho más amplio: estaciones de trabajo con un solo RTX PRO 6000, servidores multi-GPU 2U/4U e incluso pequeños nodos de inferencia en el borde. La realidad de 2026: la inmensa mayoría de los presupuestos de IA de las empresas se destina a inferencia, así que la selección de servidores debe seguir el principio «inferencia primero, entrenamiento según necesidad».
¿Por qué la VRAM importa más que la potencia de cómputo al elegir un servidor de IA?
Respuesta rápida: si el modelo no cabe en la VRAM, los TFLOPS más altos valen cero. Que un modelo pueda ejecutarse depende de cuánta VRAM ocupan los pesos + el KV Cache + la longitud de contexto; solo cuando cabe tienen sentido las comparaciones de ancho de banda, soporte FP4/FP8 y precio.
Regla práctica (2026): en precisión FP16, un modelo 70B necesita unos 140GB de VRAM: un solo H200 (141GB) lo aloja justo; de lo contrario, hacen falta dos H100. La cuantización FP8 reduce la necesidad a la mitad; FP4 la vuelve a reducir a la mitad, pero solo la arquitectura Blackwell (B200/B300/RTX PRO 6000) soporta FP4 de forma nativa. Cada vez que la ventana de contexto se duplica, el KV Cache crece casi linealmente: por eso entre «cabe» y «sirve bien» está el ancho de banda: 4.8 TB/s en el H200 y 8 TB/s en los B200/B300.
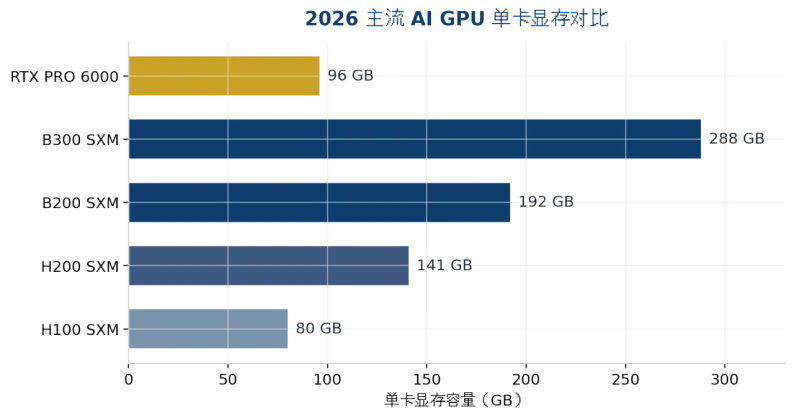
Figura 1: Comparación de VRAM por tarjeta de las principales GPU de IA en 2026 (fuentes de datos en el apéndice)
Cómo elegir entre las GPU dominantes de 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Respuesta rápida: para modelos de hasta 141GB, el H200 es la opción con mejor relación calidad-precio; elija el B200 si necesita FP4 o más VRAM; elija el B300 si una sola tarjeta debe alojar un modelo de más de 200GB o la presión del KV Cache es alta; elija el RTX PRO 6000 para inferencia de gama media y entornos PCIe.
Dimensión | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arquitectura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Ancho de banda de memoria | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Potencia FP4 | No soportada | 9 PFLOPS | 15 PFLOPS | Soportada (clase de una tarjeta) |
TDP / refrigeración | 700W / aire viable | 1000W / líquida recomendada | ~1400W / líquida prácticamente obligatoria | 600W / aire |
Posicionamiento típico | Inferencia 70B–100B, fine-tuning | Inferencia 100B+, entrenamiento | LLM de frontera en un solo nodo | Inferencia de gama media, estación/borde |
Referencia de alquiler cloud 2026 | ~$4.4/GPU·h | ~$5–7/GPU·h | ~$7.4–8.3/GPU·h | Compra de equipos completos sobre todo |
Tabla 1: Especificaciones clave y posicionamiento de las principales GPU de IA en 2026 (precios de referencia de mercado de agosto de 2026, muy volátiles; solicite una cotización actualizada antes de comprar)
Hay dos tendencias fáciles de pasar por alto: primero, el precio mediano del alquiler en la nube del H200 ha subido alrededor del 25% desde agosto de 2025, la brecha de precios entre Hopper y Blackwell se estrecha y la ventana de «ahorrar comprando la generación anterior» se está cerrando; segundo, el RTX PRO 6000 ya tiene una versión Server de 400W que permite instalar más tarjetas con el mismo presupuesto de potencia, más amigable para los proveedores de inferencia que facturan por token.
¿Qué tamaño de modelo exige qué máquina?
Respuesta rápida: estime el suelo de VRAM como «pesos del modelo × 1.2 (margen para el KV Cache)» y luego determine el número de GPU con la tabla siguiente; los modelos que superan un solo nodo pasan al paralelismo multimáquina, donde la red importa más que las GPU.
Modelo objetivo (2026) | Tamaño de los pesos | Configuración mínima | Formato recomendado |
7B–14B (clase Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 o tarjeta de estación de 48GB | Servidor de inferencia edge torre/2U |
32B–70B (cuantización FP8) | 40–80GB | RTX PRO 6000 ×1–2 o H200 ×1 | Servidor GPU 2U/4U |
70B FP16 / contexto largo | ~140GB+ | H200 ×1 (ajustado) o ×2 (holgado) | Servidor multi-GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (margen ~130GB) | Servidor 4U con refrigeración líquida |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 o B300 ×4 | Equipo SXM de 8 GPU |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2.3TB de VRAM en total) | Equipo insignia de 8 GPU con refrigeración líquida |
Tabla 2: Correspondencia entre tamaño del modelo y configuración del servidor (pesos según los checkpoints oficiales; en el despliegue real hay que añadir el KV Cache y la sobrecarga del runtime)
Esta tabla también explica por qué el chasis 4U es el «punto dulce» de los servidores de IA: 8 GPU de doble ancho, fuentes de alimentación redundantes y suficiente flujo de aire de refrigeración; solo el espacio de un 4U puede albergarlo todo a la vez. El 2U sirve para nodos de inferencia de 2–4 tarjetas; el 1U solo admite una tarjeta o funciona como nodo frontal de planificación/almacenamiento.
¿Refrigeración por aire o líquida? ¿Cómo definir las especificaciones térmicas y de rack?
Respuesta rápida: por debajo de 700W por tarjeta, el aire es suficiente; por encima de 1000W por tarjeta —o más de 20kW por armario— la refrigeración líquida pasa de «extra» a «requisito obligatorio». El TDP de ~1400W del B300 prácticamente impone la refrigeración líquida.
El orden correcto de selección es: primero el modelo y la GPU, luego la potencia total del equipo y, por último, deducir hacia atrás la refrigeración y las condiciones de la sala. Muchas empresas lo hacen al revés: compran las máquinas primero y descubren después que la alimentación eléctrica y la climatización no dan abasto, viéndose obligadas a reducir la frecuencia; es como pagar el precio completo por una GPU «castrada». Antes de comprar, confirme tres cosas: la alimentación del armario (kW), la temperatura y el caudal del aire de entrada, y el margen para las próximas 2–3 generaciones de GPU (después del B300, los TDP solo irán a más).
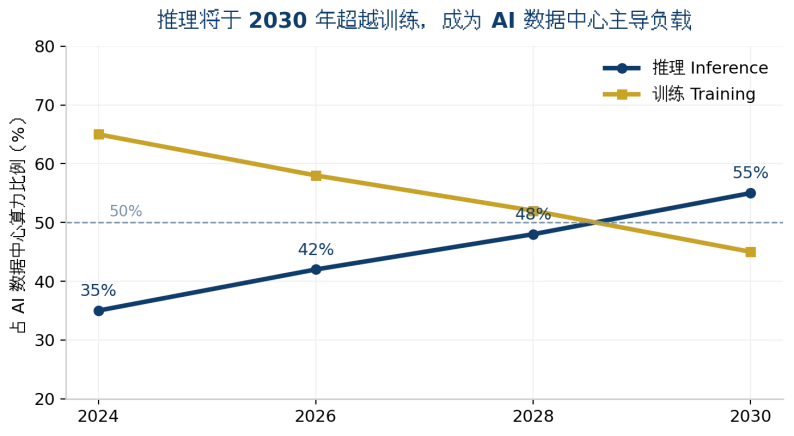
Figura 2: Hacia 2030 la inferencia superará al entrenamiento como carga dominante de los centros de datos de IA (ilustración de tendencia; fuentes de datos en el apéndice)
¿Alquiler en la nube o infraestructura propia? ¿Cómo hacer las cuentas?
Respuesta rápida: con una utilización inferior al 60%, alquile en la nube; con cargas altas y sostenidas, construya infraestructura propia. A precios de agosto de 2026, el alquiler en la nube de un H200 ronda los 4.4/GPU·hora: unos38K por un año completo a plena carga, cifra cercana al coste de comprar una tarjeta. Cuanta mayor utilización, más rápido se amortiza la infraestructura propia.
La cuenta de la infraestructura propia debe sumar tres partidas más: electricidad y operación de la refrigeración (alrededor del 20%–30% del coste total de propiedad), la depreciación por generaciones de GPU (en 2026 el H100 ya está profundamente devaluado; el riesgo de valor residual es real) y el cumplimiento de datos: para los clientes financieros, sanitarios y gubernamentales, los datos no salen de la intranet, por lo que el despliegue privado no es una opción sino una obligación. La arquitectura híbrida se está volviendo dominante: entrenamiento de picos en la nube, inferencia permanente en local.
ChangFan: servidores GPU y hardware de IA preparados para la era de la inferencia
Al final, la elección de un servidor de IA no se gana en las fichas técnicas, sino en la adecuación entre configuración y escenario. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) ofrece servidores GPU en rack y equipos de inferencia de IA en formatos 1U/2U/4U, con expansión multi-GPU, fuentes redundantes y diseño de temperatura amplia. El número de GPU, la configuración de VRAM y la refrigeración (aire/líquida) se personalizan según el tamaño del modelo objetivo: una base de hardware estable y fiable para el despliegue privado de LLM, nodos de inferencia en el borde y bases de conocimiento empresariales.
Si está evaluando la compra y el despliegue de servidores GPU de clase H200/B200/B300 o RTX PRO 6000, contacte con ChangFan para obtener asesoramiento de configuración y propuestas de equipos completos adaptados a su modelo objetivo (vendemos hardware y construimos equipos completos; no ofrecemos servicios de suscripción de software).
Preguntas frecuentes (FAQ)
P1: ¿Cuál es la configuración mínima para ejecutar un LLM de 70B? R: En FP16 se necesitan unos 140GB de VRAM, por lo que un solo H200 es la respuesta más económica; tras la cuantización FP8, dos RTX PRO 6000 (96GB×2) también lo consiguen, con menor coste y más flexibilidad de despliegue.
P2: ¿En qué mejora el B300 al B200 y merece la pena esperar? R: El B300 ofrece un 50% más de VRAM (288GB frente a 192GB) y 1.5× la potencia FP4, pero el mismo ancho de banda y un TDP de ~1400W que exige refrigeración líquida. Solo merece la pena actualizar cuando el modelo o el KV Cache superan la capacidad de un nodo con B200.
P3: ¿Con qué debería empezar una pyme que compra su primer servidor de IA? R: Defina primero el modelo que va a ejecutar. Para aplicaciones de 7B–14B (atención al cliente, bases de conocimiento, control de calidad), un servidor de inferencia 2U con una sola GPU basta para empezar; amplíe a 4U multi-GPU cuando confirme una carga alta y sostenida.
P4: ¿Es obligatoria la refrigeración líquida en un servidor de IA? R: No. Por debajo de 700W por tarjeta y con una sala en buenas condiciones, el aire es suficiente; la líquida solo hace falta por encima de 1000W por tarjeta o en despliegues de varios armarios de alta densidad. Al elegir, deje margen para la tendencia de consumo de las próximas 2–3 generaciones de GPU.
P5: Las GPU en la nube son tan baratas, ¿por qué comprar un servidor propio? R: Tres razones: por encima de ~60% de utilización, la infraestructura propia cuesta menos; los datos sensibles no pueden salir de la intranet; y la inferencia local no tiene latencia de red y el SLA es autogestionado. La mayoría de las empresas terminan con una arquitectura híbrida de «entrenar en la nube, inferir en local».