Jak vybrat AI server? Kompletní průvodce hardwarovou konfigurací 2026 pro trénování a inferenci
Úvod: proč se výběr AI serveru stal v roce 2026 povinnou výbavou
Struktura výdajů na AI výpočty se zásadně mění. Podle analýzy McKinsey z února 2026 předstihne inference do roku 2030 trénování jako dominantní zátěž v AI datových centrech – s více než polovinou všech AI výpočtů a zhruba 30–40 % celkové poptávky datových center. Pro podniky se logika nákupu serverů posouvá od „nakupit karty na trénování“ k „provozovat inferenci s pečlivým hlídáním nákladů“ – špatná konfigurace nestojí jednorázovou přeplacenost, ale tři roky každodenních účtů za elektřinu a nájem špatné architektury.
Zároveň se výrazně zrychlilo tempo inovací GPU: 141GB VRAM u H200 se ani nestačila zabydlet a už se rozšiřují 192GB u B200 a 288GB u B300, zatímco RTX PRO 6000 s 96GB a formátem PCIe ukrajuje trh inferencí střední třídy. Čím více modelů, tím těžší výběr. Tento článek objasňuje výběr AI serveru v roce 2026 pomocí jedné rozhodovací osy a dvou srovnávacích tabulek.
Jaký je vlastně rozdíl mezi trénovacím a inferenčním serverem?
Stručná odpověď: trénování je jednorázový „výpočetně náročný“ megaprojekt; inference je „na VRAM a šířku pásma náročná“ kontinuální služba. Trénovací server sleduje špičkový výkon multi-GPU propojení (plná NVLink/NVSwitch fabric, vysoká hustota výkonu, kapalinové chlazení); inferenční server sleduje stabilní propustnost na jednotku nákladů (VRAM pojme model, šířka pásma dodává tokeny, příkon karty pod kontrolou, spolehlivost 7×24).
Hardwarově dávají trénovací clustery přednost 8-GPU strojům ve formátu SXM se sítí InfiniBand; inference má mnohem širší možnosti – jednokartové pracovní stanice s RTX PRO 6000, multi-GPU servery 2U/4U a dokonce kompaktní inferenční uzly na okraji sítě. Realita roku 2026: drtivá většina podnikových AI rozpočtů jde na inferenci, takže servery je třeba vybírat podle zásady „inference na prvním místě, trénování podle potřeby“.
Proč je při výběru AI serveru VRAM důležitější než výpočetní výkon?
Stručná odpověď: pokud se model nevejde do VRAM, jsou i ty nejvyšší TFLOPS nulové. Zda model poběží, závisí na tom, kolik VRAM zaberou váhy + KV Cache + délka kontextu; teprve když se vejde, dávají smysl srovnání šířky pásma, podpory FP4/FP8 a ceny.
Praktické pravidlo (2026): v přesnosti FP16 potřebuje model 70B přibližně 140GB VRAM – jedna H200 (141GB) ho pojme přesně, jinak jsou nutné dvě H100; kvantizace FP8 potřebu sníží na polovinu; FP4 ji sníží znovu na polovinu, ale pouze architektura Blackwell (B200/B300/RTX PRO 6000) podporuje FP4 nativně. Každé zdvojnásobení kontextového okna zvětšuje využití KV Cache téměř lineárně – proto mezi „vejde se“ a „dobře obsluhuje“ stále stojí šířka pásma: H200 nabízí 4,8 TB/s, B200/B300 nabízejí 8 TB/s.
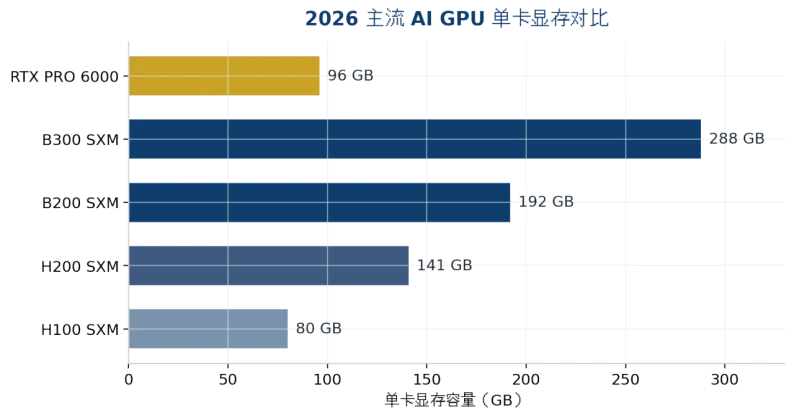
Obrázek 1: Srovnání VRAM na kartu u hlavních AI GPU v roce 2026 (zdroje dat v příloze)
Jak vybírat mezi GPU roku 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Stručná odpověď: pro modely do 141GB nabízí H200 nejlepší poměr ceny a výkonu; potřebujete-li FP4 nebo více VRAM, zvolte B200; má-li jediná karta pojmout model nad 200GB nebo je vysoký tlak KV Cache, zvolte B300; pro inference střední třídy a prostředí PCIe zvolte RTX PRO 6000.
Dimenze | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architektura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Šířka pásma paměti | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Výkon FP4 | Nepodporováno | 9 PFLOPS | 15 PFLOPS | Podporováno (třída jedné karty) |
TDP / chlazení | 700 W / vzduch možný | 1000 W / kapalina doporučená | ~1400 W / kapalina prakticky nutná | 600 W / vzduch |
Typické pozicionování | Inference 70B–100B, doladění | Inference 100B+, trénování | Špičkové LLM na jednom uzlu | Inference střední třídy, stanice/okraj |
Reference cloudového pronájmu 2026 | ~$4.4/GPU·hod. | ~$5–7/GPU·hod. | ~$7.4–8.3/GPU·hod. | Převážně nákup kompletních systémů |
Tabulka 1: Klíčové specifikace a pozicionování hlavních AI GPU v roce 2026 (ceny jsou tržní referenční hodnoty ze srpna 2026, velmi volatilní – před nákupem si vyžádejte aktuální nabídku)
Existují ještě dva snadno přehlédnutelné trendy: za prvé, mediánová cena cloudového pronájmu H200 od srpna 2025 vzrostla přibližně o 25 %, cenový rozdíl mezi Hopper a Blackwell se zmenšuje a okno „ušetřit starší generací“ se zavírá; za druhé, RTX PRO 6000 má nyní 400W serverovou verzi, která dovoluje umístit více karet do stejného výkonového rozpočtu – výhodnější pro poskytovatele inferencí účtujících za token.
Jak velký je model, tolik stroje potřebuje?
Stručná odpověď: odhadněte spodní hranici VRAM jako „váhy modelu × 1,2 (rezerva na KV Cache)“ a poté podle níže uvedené tabulky určete počet GPU; modely přesahující jeden uzel přecházejí na vícestrojový paralelismus, kde je síť důležitější než GPU.
Cílový model (2026) | Velikost vah | Minimální konfigurace | Doporučený formát |
7B–14B (třída Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 nebo 48GB stanice | Okrajový inferenční server tower/2U |
32B–70B (kvantizace FP8) | 40–80GB | RTX PRO 6000 ×1–2 nebo H200 ×1 | GPU server 2U/4U |
70B FP16 / dlouhý kontext | ~140GB+ | H200 ×1 (těsně) nebo ×2 (jistě) | Multi-GPU server 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (rezerva ~130GB) | Server 4U s kapalinovým chlazením |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 nebo B300 ×4 | 8-GPU SXM systém |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (celkem 2,3TB VRAM) | Vlajkový 8-GPU systém s kapalinovým chlazením |
Tabulka 2: Velikost modelu versus konfigurace serveru (váhy podle oficiálních checkpointů; při reálném nasazení je třeba přičíst KV Cache a režii runtime)
Tato tabulka také vysvětluje, proč je šasi 4U „zlatou střední cestou“ AI serverů: 8 dvouslotových GPU, redundantní zdroje a dostatečné chladicí vzduchové kanály – jen prostor 4U to vše pojme najednou. 2U vyhovuje inferenčním uzlům se 2–4 kartami; 1U pojme jen jednu kartu nebo slouží jako přední plánovací/úložný uzel.
Vzduchové nebo kapalinové chlazení? Jak určit tepelné a rackové specifikace?
Stručná odpověď: pod 700 W na kartu stačí vzduchové chlazení; nad 1000 W na kartu – nebo nad 20 kW na rack – se kapalinové chlazení mění z „bonus“ na „tvrdý požadavek“. TDP B300 kolem ~1400 W prakticky uzamyká kapalinové chlazení.
Správné pořadí výběru je: nejprve model a GPU, poté celkový výkon stroje a teprve potom zpětný výpočet chlazení a podmínek sálu. Mnoho firem to dělá naopak – nejdřív koupí stroje a pak zjistí, že napájení a klimatizace nestačí, a musí provozovat na snížené frekvenci: jako by za plnou cenu koupily „zkastrované“ GPU. Před nákupem si ověřte tři věci: napájení racku (kW), teplotu a objem přívodního vzduchu a rezervu pro příští 2–3 generace GPU (po B300 půjde TDP jen nahoru).
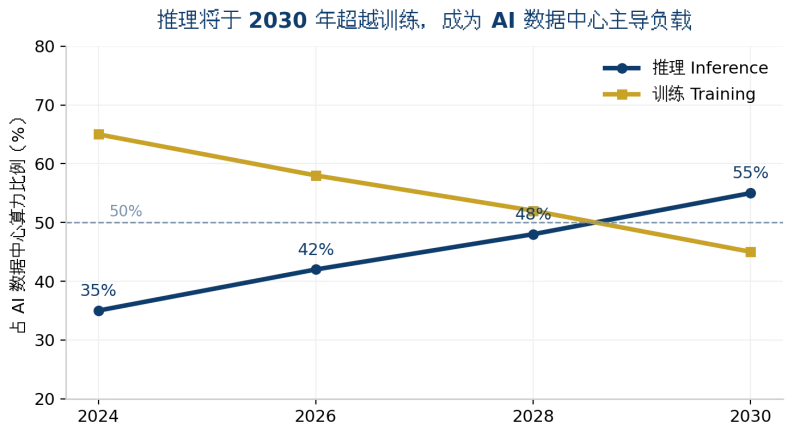
Obrázek 2: Inference do roku 2030 předstihne trénování jako dominantní zátěž AI datových center (ilustrace trendu; zdroje dat v příloze)
Cloudový pronájem nebo vlastní výstavba? Jak počítat?
Stručná odpověď: při vytížení pod 60 % se vyplatí cloudový pronájem, při trvale vysoké zátěži vlastní výstavba. Podle cen ze srpna 2026 stojí cloudový pronájem H200 přibližně 4,4 /GPU·hodinu – zhruba 38 tis. za celý rok na plné zatížení, což se blíží ceně nákupu jedné karty. Čím vyšší vytížení, tím rychleji se vlastní výstavba vrací.
Do kalkulace vlastní výstavby patří ještě tři položky: elektřina a provoz chlazení (přibližně 20–30 % celkových nákladů na vlastnictví), odpisy vlivem generací GPU (H100 je v roce 2026 již hluboko zlevněná – riziko zbytkové hodnoty je reálné) a soulad s daty: u finančních, zdravotnických a vládních zákazníků data nesmějí opustit intranet, takže privátní nasazení není volba, ale povinnost. Hybridní architektura se stává mainstreamem: špičkové trénování v cloudu, trvalá inference lokálně.
ChangFan: GPU servery a AI hardware připravené na éru inference
V konečném důsledku se výběr AI serveru nevyhrává v tabulkách parametrů, ale v souladu konfigurace se scénářem. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) nabízí rackové GPU servery a AI inferenční systémy ve formátech 1U/2U/4U, s multi-GPU rozšířením, redundantními zdroji a konstrukcí pro široký teplotní rozsah. Počet GPU, konfigurace VRAM a vzduchové/kapalinové chlazení lze přizpůsobit cílové velikosti modelu – stabilní a spolehlivý hardwarový základ pro privátní nasazení LLM, okrajové inferenční uzly a podnikové znalostní báze.
Pokud hodnotíte nákup a nasazení GPU serverů třídy H200/B200/B300 nebo RTX PRO 6000, obraťte se na ChangFan pro poradenství ke konfiguraci a nabídky kompletních systémů na míru vašeho cílového modelu (prodáváme hardware a stavíme kompletní systémy – softwarová předplatná nenabízíme).
Často kladené otázky (FAQ)
O1: Jaká je minimální konfigurace pro provoz modelu 70B LLM? O: V FP16 potřebujete přibližně 140GB VRAM, takže jedna H200 je nejekonomičtější odpověď; po kvantizaci FP8 úlohu zvládnou i dvě RTX PRO 6000 (96GB×2) – levněji a flexibilněji při nasazení.
O2: V čem je B300 lepší než B200 a vyplatí se čekat? O: B300 nabízí o 50 % více VRAM (288GB vs 192GB) a 1,5× výkon FP4, ale stejnou šířku pásma a TDP zvýšené na ~1400 W vyžadující kapalinové chlazení. Upgrade se vyplatí teprve tehdy, když model nebo KV Cache přesáhnou kapacitu uzlu s B200.
O3: Čím by měl začít malý či střední podnik při nákupu prvního AI serveru? O: Nejprve definujte model, který budete provozovat. Pro aplikace 7B–14B (zákaznický servis, znalostní báze, kontrola kvality) na start stačí jeden inferenční server 2U s jednou kartou; po potvrzení trvalé vysoké zátěže rozšiřte na multi-GPU 4U.
O4: Je kapalinové chlazení pro AI servery povinné? O: Ne. Pod 700 W na kartu a za dobrých podmínek sálu stačí vzduch; kapalinu vyžaduje až výkon nad 1000 W na kartu nebo husté vícerackové instalace. Při výběru nechte rezervu na trend spotřeby příštích 2–3 generací GPU.
O5: Cloudová GPU jsou tak levná – proč kupovat vlastní server? O: Tři důvody – nad ~60 % vytížení je vlastní výstavba levnější; citlivá data nesmějí opustit intranet; lokální inference nemá síťovou latenci a SLA je pod vlastní kontrolou. Většina firem nakonec přijme hybridní architekturu „trénovat v cloudu, inferovat lokálně“.