จะเลือกเซิร์ฟเวอร์ AI อย่างไร? คู่มือฉบับสมบูรณ์การกำหนดค่าฮาร์ดแวร์สำหรับการฝึกและการอนุมานปี 2026
บทนำ: ทำไมการเลือกเซิร์ฟเวอร์ AI จึงกลายเป็นบทเรียนบังคับของปี 2026
โครงสร้างการใช้จ่ายด้านกำลังประมวลผล AI กำลังเปลี่ยนแปลงอย่างพื้นฐาน การวิเคราะห์ที่ McKinsey เผยแพร่ในเดือนกุมภาพันธ์ 2026 ชี้ว่า ภายในปี 2030 การอนุมาน (inference) จะแซงหน้าการฝึกกลายเป็นโหลดหลักของศูนย์ข้อมูล AI คิดเป็นมากกว่าครึ่งหนึ่งของกำลังประมวลผล AI ทั้งหมด และประมาณ 30%–40% ของความต้องการศูนย์ข้อมูลโดยรวม นั่นหมายความว่าตรรกะการตัดสินใจจัดซื้อเซิร์ฟเวอร์ขององค์กรกำลังเปลี่ยนจาก "กองการ์ดเพื่อฝึก" ไปเป็น "วิ่งอนุมานอย่างประหยัดทุกบาท" — เลือกคอนฟิกผิด ค่าใช้จ่ายไม่ใช่แค่ซื้อแพงครั้งเดียว แต่คือการจ่ายค่าไฟและค่าเช่าสำหรับสถาปัตยกรรมที่ผิดทุกวันตลอดสามปีข้างหน้า
ขณะเดียวกัน จังหวะการพัฒนาผลิตภัณฑ์ GPU เร็วขึ้นอย่างเห็นได้ชัด: VRAM 141GB ของ H200 ยังไม่ทันอบอุ่น B200 ขนาด 192GB และ B300 ขนาด 288GB ก็เปิดตลาดแล้ว ส่วน RTX PRO 6000 ใช้ VRAM 96GB กับฟอร์มแฟกเตอร์ PCIe ตัดส่วนแบ่งตลาดอนุมานระดับกลาง เมื่อรุ่นมากขึ้น การเลือกกลับยากขึ้น บทความนี้ใช้แกนการตัดสินใจเพียงเส้นเดียวและตารางเปรียบเทียบสองใบ เพื่ออธิบายการเลือกเซิร์ฟเวอร์ AI ปี 2026 ให้ชัดเจน
เซิร์ฟเวอร์ฝึกกับเซิร์ฟเวอร์อนุมานต่างกันอย่างไร?
คำตอบแบบสั้น: การฝึกคือโครงการครั้งเดียวที่ "เข้มข้นด้านกำลังประมวลผล" ส่วนการอนุมานคือบริการต่อเนื่องที่ "เข้มข้นด้าน VRAM และแบนด์วิดท์" เซิร์ฟเวอร์ฝึกมุ่งกำลังประมวลผลสูงสุดของการเชื่อมต่อหลายการ์ด (NVLink/NVSwitch เชื่อมต่อเต็มรูปแบบ ความหนาแน่นพลังงานสูง ระบายความร้อนด้วยของเหลว); เซิร์ฟเวอร์อนุมานมุ่งปริมาณงานที่เสถียรต่อต้นทุนต่อหน่วย (VRAM ต้องจุโมเดลได้ แบนด์วิดท์ต้องปล่อยโทเคนได้ การ์ดใบเดียวใช้พลังงานควบคุมได้ และเชื่อถือได้ 7×24)
เมื่อลงสู่ฮาร์ดแวร์ คลัสเตอร์ฝึกให้ความสำคัญกับเครื่อง 8 การ์ดฟอร์มแฟกเตอร์ SXM และเครือข่าย IB ก่อน; ส่วนการปรับใช้อนุมานมีทางเลือกกว้างกว่า — เวิร์กสเตชัน RTX PRO 6000 การ์ดเดียว เซิร์ฟเวอร์หลายการ์ด 2U/4U หรือแม้แต่โหนดอนุมานขนาดเล็กฝั่งเอดจ์ ความจริงของปี 2026 คือ งบประมาณ AI ขององค์กรส่วนใหญ่ใช้ไปกับการอนุมาน การเลือกเซิร์ฟเวอร์จึงควร "ให้อนุมานมาก่อน ฝึกตามความจำเป็น"
เลือกเซิร์ฟเวอร์ AI ทำไม VRAM จึงสำคัญกว่ากำลังประมวลผล?
คำตอบแบบสั้น: ถ้าโมเดลใส่ไม่ลงใน VRAM TFLOPS สูงแค่ไหนก็เป็นศูนย์ โมเดลจะทำงานได้หรือไม่ขึ้นอยู่กับว่าน้ำหนัก + KV Cache + ความยาวบริบทใช้ VRAM เท่าใด; เมื่อใส่ลงได้แล้วเท่านั้น แบนด์วิดท์ การรองรับ FP4/FP8 และราคาจึงมีความหมายในการเปรียบเทียบ
กฎคร่าว ๆ (ปี 2026): ที่ความแม่นยำ FP16 โมเดล 70B ต้องการ VRAM ประมาณ 140GB H200 ใบเดียว (141GB) ใส่ได้พอดี มิฉะนั้นต้องใช้ H100 สองใบ; เมื่อควอนไทซ์เป็น FP8 ความต้องการลดลงครึ่งหนึ่ง; FP4 ลดลงอีกครึ่ง แต่มีเฉพาะสถาปัตยกรรม Blackwell (B200/B300/RTX PRO 6000) ที่รองรับ FP4 แบบเนทีฟ ทุกครั้งที่หน้าต่างบริบทยาวขึ้นเท่าตัว การใช้ KV Cache เพิ่มขึ้นเกือบเป็นเชิงเส้น — นี่คือเหตุผลที่ระหว่าง "ใส่ลงได้" กับ "ให้บริการได้ดี" ยังมีแบนด์วิดท์คั่นอยู่: H200 อยู่ที่ 4.8 TB/s ส่วน B200/B300 อยู่ที่ 8 TB/s
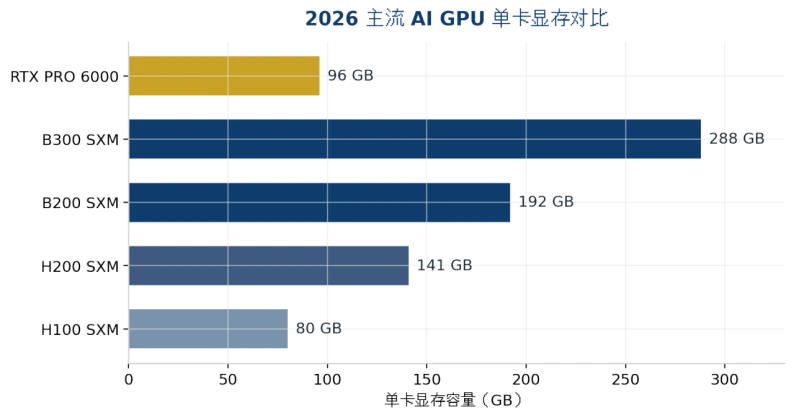
ภาพที่ 1: เปรียบเทียบ VRAM ต่อการ์ดของ GPU AI กระแสหลักปี 2026 (แหล่งข้อมูลดูในภาคผนวก)
จะเลือก GPU กระแสหลักปี 2026 อย่างไร: เปรียบเทียบ H200, B200, B300, RTX PRO 6000
คำตอบแบบสั้น: โมเดลไม่เกิน 141GB เลือก H200 คุ้มค่าที่สุด; ต้องการ FP4 หรือ VRAM มากกว่าเลือก B200; การ์ดใบเดียวต้องจุโมเดลเกิน 200GB หรือ KV Cache หนักเลือก B300; การอนุมานระดับกลางและสภาพแวดล้อม PCIe เลือก RTX PRO 6000
มิติ | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
สถาปัตยกรรม | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
แบนด์วิดท์หน่วยความจำ | 4.8 TB/s | 8 TB/s | 8 TB/s | ประมาณ 1.8 TB/s |
กำลังประมวลผล FP4 | ไม่รองรับ | 9 PFLOPS | 15 PFLOPS | รองรับ (ระดับการ์ดใบเดียว) |
TDP / การระบายความร้อน | 700W / ระบายด้วยอากาศได้ | 1000W / แนะนำระบายด้วยของเหลว | ประมาณ 1400W / จำเป็นต้องใช้ของเหลวโดยพื้นฐาน | 600W / ระบายด้วยอากาศ |
การวางตำแหน่งโดยทั่วไป | การอนุมาน 70B–100B การปรับจูน | การอนุมาน 100B+ การฝึก | รองรับโมเดลขนาดใหญ่ชายแดนบนเครื่องเดียว | การอนุมานระดับกลาง เวิร์กสเตชัน/เอดจ์ |
ข้อมูลอ้างอิงค่าเช่าคลาวด์ 2026 | ประมาณ $4.4/GPU·ชั่วโมง | ประมาณ $5–7/GPU·ชั่วโมง | ประมาณ $7.4–8.3/GPU·ชั่วโมง | เน้นจัดซื้อเครื่องสมบูรณ์ |
ตารางที่ 1: เปรียบเทียบสเปกสำคัญและการวางตำแหน่งของ GPU AI กระแสหลักปี 2026 (ราคาเป็นค่าอ้างอิงตลาดเดือนสิงหาคม 2026 ผันผวนมาก ต้องสอบถามราคาใหม่ก่อนจัดซื้อ)
ยังมีอีกสองแนวโน้มที่มักถูกมองข้าม: ประการแรก ราคาเช่าคลาวด์เฉลี่ยของ H200 เพิ่มขึ้นราว 25% นับตั้งแต่เดือนสิงหาคม 2025 ส่วนต่างราคาระหว่าง Hopper กับ Blackwell กำลังแคบลง หน้าต่างของ "ซื้อรุ่นเก่าประหยัด" กำลังปิดลง; ประการที่สอง RTX PRO 6000 เปิดตัวเวอร์ชัน Server 400W ภายใต้งบพลังงานเดียวกันสามารถติดตั้งการ์ดได้มากขึ้น เป็นมิตรกับผู้ให้บริการอนุมานที่คิดค่าบริการตามโทเคนยิ่งขึ้น
โมเดลใหญ่แค่ไหน เครื่องต้องแรงแค่ไหน?
คำตอบแบบสั้น: ประเมินขีดจำกัดล่างของ VRAM ด้วย "น้ำหนักโมเดล × 1.2 (เผื่อ KV Cache)" แล้วเทียบตารางด้านล่างเพื่อกำหนดจำนวน GPU; โมเดลที่เกินโหนดเดียวต้องเข้าสู่การประมวลผลขนานหลายเครื่อง ซึ่งเครือข่ายสำคัญกว่า GPU
โมเดลเป้าหมาย (2026) | ขนาดน้ำหนัก | คอนฟิกขั้นต่ำ | รูปแบบเครื่องที่แนะนำ |
7B–14B (ระดับ Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 หรือการ์ดเวิร์กสเตชัน 48GB | เซิร์ฟเวอร์อนุมานเอดจ์แบบทาวเวอร์/2U |
32B–70B (ควอนไทซ์ FP8) | 40–80GB | RTX PRO 6000 ×1–2 หรือ H200 ×1 | เซิร์ฟเวอร์ GPU 2U/4U |
70B FP16 / บริบทยาว | ประมาณ 140GB+ | H200 ×1 (พอดีตัว) หรือ ×2 (มั่นใจกว่า) | เซิร์ฟเวอร์หลายการ์ด 4U |
DeepSeek V4 Flash (156GB) | ประมาณ 156GB | B300 ×1 (เหลือเผื่อประมาณ 130GB) | เซิร์ฟเวอร์ระบายความร้อนด้วยของเหลว 4U |
GLM-5.2 FP8 (ประมาณ 756GB) | ประมาณ 756GB | H200 ×8 หรือ B300 ×4 | เครื่อง SXM 8 การ์ด |
Kimi K3 (1.56TB MXFP4) | ประมาณ 1.56TB | B300 ×8 (VRAM รวม 2.3TB) | เครื่องเรือธงระบายความร้อนด้วยของเหลว 8 การ์ด |
ตารางที่ 2: ตารางเทียบขนาดโมเดลกับการกำหนดค่าเซิร์ฟเวอร์ (น้ำหนักตาม checkpoint อย่างเป็นทางการ การปรับใช้จริงต้องบวก KV Cache และค่าโสหุ้ยขณะรันไทม์)
ตารางนี้ยังอธิบายว่าทำไมแชสซี 4U จึงเป็น "สเปกจุดหวาน" ของเซิร์ฟเวอร์ AI: GPU แบบสองสล็อต 8 ใบ พาวเวอร์ซัพพลายสำรอง และช่องลมระบายความร้อนที่เพียงพอ มีเฉพาะพื้นที่ 4U เท่านั้นที่รองรับได้พร้อมกัน 2U เหมาะกับโหนดอนุมาน 2–4 การ์ด ส่วน 1U เหมาะกับการ์ดเดียวหรือใช้เป็นโหนดตัวจัดการ/จัดเก็บข้อมูลด้านหน้าเท่านั้น
ระบายความร้อนด้วยอากาศหรือของเหลว? กำหนดสเปกการระบายความร้อนและแร็คอย่างไร?
คำตอบแบบสั้น: การ์ดใบเดียวต่ำกว่า 700W ระบายด้วยอากาศเพียงพอ; การ์ดใบเดียวเกิน 1000W หรือตู้แร็คเดียวเกิน 20kW การระบายความร้อนด้วยของเหลวเปลี่ยนจาก "ข้อดีเสริม" เป็น "เกณฑ์บังคับ" TDP ราว 1400W ของ B300 แทบล็อกให้ต้องใช้ของเหลว
ลำดับการเลือกที่ถูกต้องคือ: กำหนดโมเดลและ GPU ก่อน จากนั้นกำหนดพลังงานทั้งเครื่อง สุดท้ายค่อยคำนวณย้อนไปยังการระบายความร้อนและเงื่อนไขห้องเซิร์ฟเวอร์ องค์กรจำนวนมากทำกลับกัน — ซื้อเครื่องก่อน แล้วเพิ่งพบว่าไฟฟ้าและแอร์ของห้องเซิร์ฟเวอร์รับไม่ไหว ถูกบังคับให้ลดความถี่ทำงาน เท่ากับจ่ายเงินซื้อ GPU "พลังไม่เต็ม" ก่อนจัดซื้อต้องยืนยันสามข้อ: ไฟเลี้ยงตู้แร็ค (kW) อุณหภูมิและปริมาณลมเข้า และพื้นที่อัปเกรดสำหรับ GPU อีก 2–3 รุ่นข้างหน้า (หลัง B300 แล้ว TDP จะยิ่งสูงขึ้น)
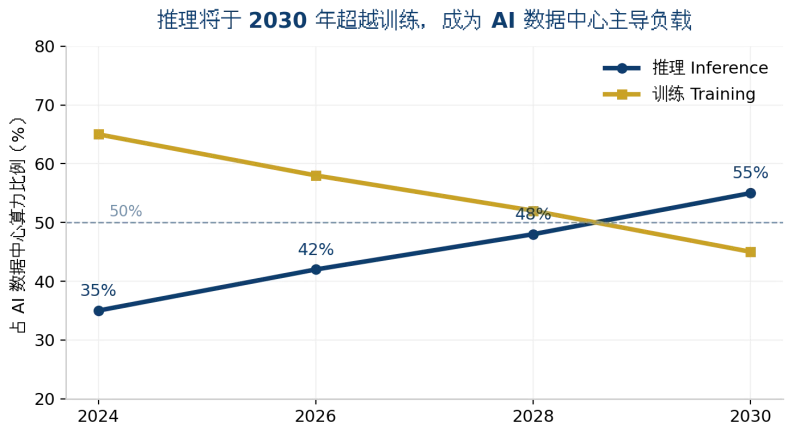
ภาพที่ 2: การอนุมานจะแซงหน้าการฝึกกลายเป็นโหลดหลักของศูนย์ข้อมูล AI ภายในปี 2030 (แนวโน้มโดยสังเขป แหล่งข้อมูลดูในภาคผนวก)
เช่าคลาวด์หรือสร้างเอง? คิดต้นทุนอย่างไร?
คำตอบแบบสั้น: อัตราการใช้งานต่ำกว่า 60% เลือกเช่าคลาวด์ โหลดสูงระยะยาวเลือกสร้างเอง ตามราคาตลาดเดือนสิงหาคม 2026 ค่าเช่าคลาวด์ H200 อยู่ที่ประมาณ 38,000 — ใกล้เคียงต้นทุนการซื้อการ์ดเองหนึ่งใบ เมื่ออัตราการใช้งานสูงขึ้น การสร้างเองย่อมคืนทุน
ฝ่ายสร้างเองยังต้องบวกอีกสามรายการ: ค่าไฟห้องเซิร์ฟเวอร์และการบำรุงรักษาระบายความร้อน (ประมาณ 20%–30% ของต้นทุนการเป็นเจ้าของโดยรวม) ค่าเสื่อมจากการเปลี่ยนรุ่น GPU (ปี 2026 นี้ H100 ถูกตัดราคาอย่างลึก ความเสี่ยงมูลค่าคงเหลือมีอยู่จริง) และการปฏิบัติตามข้อกำหนดข้อมูล — ข้อมูลของลูกค้ากลุ่มการเงิน การแพทย์ และรัฐวิสาหกิจออกจากเครือข่ายภายในไม่ได้ การปรับใช้ส่วนตัวจึงไม่ใช่ทางเลือกแต่เป็นคำถามบังคับ สถาปัตยกรรมไฮบริดกำลังกลายเป็นกระแสหลัก: ฝึกช่วงพีกบนคลาวด์ อนุมานประจำอยู่ในองค์กร
ChangFan Industrial Computing: เซิร์ฟเวอร์ GPU และฮาร์ดแวร์ AI ที่เตรียมพร้อมสำหรับยุคการอนุมาน
การเลือกเซิร์ฟเวอร์ AI ในที่สุดไม่ได้แข่งกันที่ตารางพารามิเตอร์ แต่อยู่ที่ "ความเหมาะสมระหว่างคอนฟิกกับสถานการณ์ใช้งาน" Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) นำเสนอเซิร์ฟเวอร์ GPU แบบแร็คเมาท์และเครื่องอนุมาน AI ครอบคลุม 1U/2U/4U รองรับการขยายหลายการ์ด พาวเวอร์ซัพพลายสำรอง และการออกแบบช่วงอุณหภูมิกว้าง สามารถปรับแต่งจำนวน GPU คอนฟิก VRAM และโซลูชันระบายความร้อนด้วยอากาศ/ของเหลวตามขนาดโมเดลเป้าหมาย เพื่อส่งมอบฐานฮาร์ดแวร์ที่เสถียรและเชื่อถือได้สำหรับสถานการณ์เช่นการปรับใช้โมเดลขนาดใหญ่แบบส่วนตัว โหนดอนุมานเอดจ์ และฐานความรู้องค์กร
หากคุณกำลังประเมินการจัดซื้อและปรับใช้เซิร์ฟเวอร์ GPU ระดับ H200/B200/B300 หรือ RTX PRO 6000 ยินดีติดต่อ ChangFan Industrial Computing เพื่อรับคำแนะนำการกำหนดค่าและโซลูชันเครื่องสมบูรณ์สำหรับโมเดลเป้าหมายของคุณ (เราขายฮาร์ดแวร์และผลิตเครื่องสมบูรณ์ ไม่มีบริการสมัครสมาชิกซอฟต์แวร์)
คำถามที่พบบ่อย (FAQ)
คำถามที่ 1: การรันโมเดลขนาดใหญ่ 70B ต้องการคอนฟิกขั้นต่ำอย่างไร? ตอบ: FP16 ต้องการ VRAM ประมาณ 140GB H200 ใบเดียวคือคำตอบที่ประหยัดที่สุด; เมื่อควอนไทซ์เป็น FP8 แล้ว RTX PRO 6000 สองใบ (96GB×2) ก็รับได้ ต้นทุนต่ำกว่าและปรับใช้ยืดหยุ่นกว่า
คำถามที่ 2: B300 แข็งแกร่งกว่า B200 ตรงไหน คุ้มที่จะรอหรือไม่? ตอบ: B300 มี VRAM มากกว่า 50% (288GB เทียบ 192GB) กำลังประมวลผล FP4 สูงกว่า 1.5 เท่า แต่แบนด์วิดท์เท่ากัน และ TDP เพิ่มเป็นราว 1400W ต้องใช้ระบายความร้อนด้วยของเหลว ควรอัปเกรดเมื่อโมเดลหรือ KV Cache เกินความจุของโหนด B200 เท่านั้น
คำถามที่ 3: SME ซื้อเซิร์ฟเวอร์ AI ครั้งแรก ควรเริ่มจากอะไร? ตอบ: กำหนดก่อนว่าจะรันโมเดลอะไร แอปพลิเคชันระดับ 7B–14B (บริการลูกค้า ฐานความรู้ ตรวจสอบคุณภาพ) เริ่มได้ด้วยเซิร์ฟเวอร์อนุมานการ์ดเดียว 2U เพียงเครื่องเดียว; เมื่อยืนยันโหลดสูงระยะยาวแล้วค่อยขยายเป็น 4U หลายการ์ด
คำถามที่ 4: เซิร์ฟเวอร์ AI จำเป็นต้องใช้ระบายความร้อนด้วยของเหลวหรือไม่? ตอบ: ไม่จำเป็น สถานการณ์ที่การ์ดใบเดียวต่ำกว่า 700W และห้องเซิร์ฟเวอร์มีเงื่อนไขดี ระบายด้วยอากาศเพียงพอ; การ์ดใบเดียวเกิน 1000W หรือการปรับใช้หลายตู้ความหนาแน่นสูงจึงต้องใช้ของเหลว เมื่อเลือกสเปกควรเผื่อขอบเขตตามแนวโน้มการใช้พลังงานของ GPU อีก 2–3 รุ่นข้างหน้า
คำถามที่ 5: GPU บนคลาวด์ถูกขนาดนี้ ทำไมยังต้องซื้อเซิร์ฟเวอร์เอง? ตอบ: สามเหตุผล — เมื่ออัตราการใช้งานเกินประมาณ 60% การสร้างเองมีต้นทุนต่ำกว่า; ข้อมูลที่ละเอียดอ่อนไม่อนุญาตให้ออก
จากเครือข่ายภายใน; การอนุมานในองค์กรไม่มีความหน่วงเครือข่ายและควบคุม SLA ได้เอง องค์กรส่วนใหญ่ในที่สุดใช้สถาปัตยกรรมไฮบริด "ฝึกบนคลาวด์ อนุมานในองค์กร"