العنوان الأول: كيف تختار خادم الذكاء الاصطناعي؟ الدليل الشامل 2026 لتكوين العتاد للتدريب والاستدلال
مقدمة: لماذا أصبح اختيار خادم الذكاء الاصطناعي مادة إلزامية في 2026
بنية الإنفاق على الحوسبة الذكية تتغير جذريًا. فقد أشار تحليل نشرته شركة McKinsey في فبراير 2026 إلى أن الاستدلال (inference) سيتجاوز التدريب بحلول 2030 ليصبح الحِمل المهيمن في مراكز بيانات الذكاء الاصطناعي، مستحوذًا على أكثر من نصف إجمالي حوسبة الذكاء الاصطناعي ونحو 30–40% من الطلب الكلي على مراكز البيانات. وهذا يعني أن منطق شراء الخوادم لدى المؤسسات ينتقل من «تكديس البطاقات للتدريب» إلى «تشغيل الاستدلال بترشيد دقيق للتكلفة» — فاختيار التكوين الخاطئ لا يكلف دفعة زائدة لمرة واحدة، بل ثلاث سنوات من فواتير الكهرباء والإيجار اليومية لمعمارية خاطئة.
وفي الوقت نفسه، تسارع إيقاع تحديث وحدات معالجة الرسوميات بوضوح: فلم تكد ذاكرة الفيديو 141GB في H200 تستقر حتى بدأ انتشار 192GB في B200 و288GB في B300، بينما تشق RTX PRO 6000 طريقها إلى سوق الاستدلال المتوسط بذاكرة 96GB وعامل الشكل PCIe. وكلما كثرت الطرازات، زادت صعوبة الاختيار. يوضح هذا المقال اختيار خادم الذكاء الاصطناعي في 2026 عبر محور قرار واحد وجدولي مقارنة.
ما الفرق الحقيقي بين خادم التدريب وخادم الاستدلال؟
الجواب المختصر: التدريب مشروع ضخم لمرة واحدة «كثيف الحوسبة»، والاستدلال خدمة مستمرة «كثيفة ذاكرة الفيديو والنطاق الترددي». خادم التدريب يسعى إلى ذروة الأداء في الربط البيني متعدد البطاقات (نسيج NVLink/NVSwitch الكامل، وكثافة قدرة عالية، وتبريد سائل)؛ أما خادم الاستدلال فيسعى إلى إنتاجية مستقرة لكل وحدة تكلفة (ذاكرة فيديو تسع النموذج، ونطاق ترددي يدفق الرموز، واستهلاك طاقة مضبوط لكل بطاقة، وموثوقية 7×24).
وعلى صعيد العتاد، تُفضَّل لعناقيد التدريب الأجهزة ذات 8 بطاقات بعامل الشكل SXM مع شبكة InfiniBand؛ أما الاستدلال فخياراته أوسع بكثير — محطات عمل ببطاقة RTX PRO 6000 واحدة، وخوادم متعددة البطاقات 2U/4U، وحتى عقد استدلال صغيرة عند الحافة. وواقع 2026 هو أن الغالبية العظمى من ميزانيات الذكاء الاصطناعي للمؤسسات تُنفق على الاستدلال، لذا ينبغي أن يتبع اختيار الخوادم مبدأ «الاستدلال أولًا، والتدريب عند الحاجة».
لماذا تتفوق ذاكرة الفيديو على القوة الحاسوبية عند اختيار خادم الذكاء الاصطناعي؟
الجواب المختصر: إذا لم يسع النموذج ذاكرة الفيديو، فأعلى قيم TFLOPS تساوي صفرًا. فقدرة النموذج على العمل تتوقف على مقدار ما تشغله الأوزان + KV Cache + طول السياق من ذاكرة الفيديو؛ وفقط بعد أن يسعه تصبح مقارنات النطاق الترددي ودعم FP4/FP8 والسعر ذات معنى.
القاعدة العملية (2026): بدقة FP16، يحتاج نموذج 70B إلى نحو 140GB من ذاكرة الفيديو — بطاقة H200 واحدة (141GB) تسعه بالضبط، وإلا فأنت بحاجة إلى بطاقتي H100؛ والتكميم إلى FP8 يخفض الاحتياج إلى النصف؛ وFP4 يخفضه إلى النصف مجددًا، لكن معمارية Blackwell وحدها (B200/B300/RTX PRO 6000) تدعم FP4 أصالةً. ومع كل مضاعفة لنافذة السياق، ينمو استهلاك KV Cache شبه خطيًا — ولهذا بين «يسعه» و«يخدمه جيدًا» يقف النطاق الترددي: تقدم H200 سرعة 4.8 TB/s، بينما تقدم B200/B300 سرعة 8 TB/s.
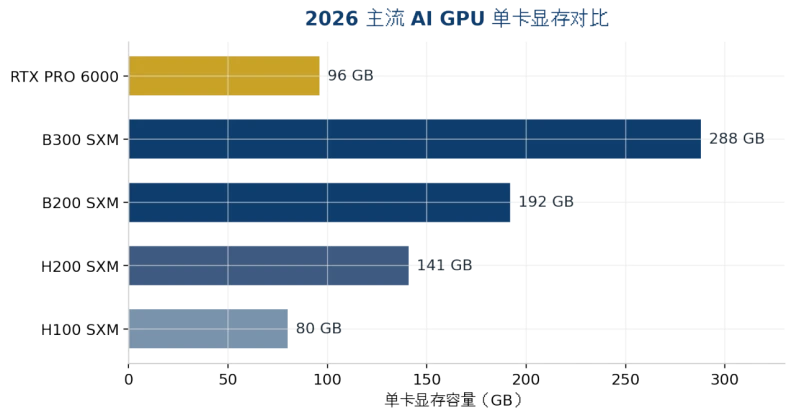
الشكل 1: مقارنة ذاكرة الفيديو للبطاقة الواحدة بين أبرز وحدات معالجة الرسوميات للذكاء الاصطناعي في 2026 (مصادر البيانات في الملحق)
كيف تختار بين وحدات معالجة الرسوميات السائدة في 2026: H200 مقابل B200 مقابل B300 مقابل RTX PRO 6000
الجواب المختصر: للنماذج في حدود 141GB، تقدم H200 أفضل قيمة مقابل السعر؛ اختر B200 عندما تحتاج FP4 أو ذاكرة فيديو أكبر؛ اختر B300 عندما يجب أن تسع بطاقة واحدة نموذجًا يتجاوز 200GB أو عند ارتفاع ضغط KV Cache؛ واختر RTX PRO 6000 للاستدلال المتوسط وبيئات PCIe.
البُعد | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
المعمارية | Hopper | Blackwell | Blackwell Ultra | Blackwell |
ذاكرة الفيديو | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
النطاق الترددي للذاكرة | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
قوة FP4 الحاسوبية | غير مدعومة | 9 PFLOPS | 15 PFLOPS | مدعومة (فئة البطاقة الواحدة) |
TDP / التبريد | 700W / الهوائي ممكن | 1000W / يوصى بالسائل | ~1400W / السائل لازم عمليًا | 600W / هوائي |
الموقع النموذجي | استدلال 70B–100B وضبط دقيق | استدلال 100B+ وتدريب | نماذج لغوية رائدة على عقدة واحدة | استدلال متوسط، محطة عمل/حافة |
مرجع الاستئجار السحابي 2026 | ~$4.4/GPU·ساعة | ~$5–7/GPU·ساعة | ~$7.4–8.3/GPU·ساعة | الشراء بالأنظمة المتكاملة غالبًا |
الجدول 1: المواصفات الرئيسية ومواقع أبرز وحدات معالجة الرسوميات للذكاء الاصطناعي في 2026 (الأسعار قيم مرجعية لسوق أغسطس 2026 وشديدة التقلب — اطلب عرض سعر جديدًا قبل الشراء)
وهناك اتجاهان يسهل إغفالهما: أولهما أن متوسط سعر الاستئجار السحابي لـ H200 ارتفع نحو 25% منذ أغسطس 2025، والفجوة السعرية بين Hopper وBlackwell تضيق، ونافذة «التوفير بالجيل السابق» تُغلق؛ وثانيهما أن RTX PRO 6000 صدرت بإصدار Server بقدرة 400W يتيح نشر مزيد من البطاقات ضمن ميزانية الطاقة نفسها — وهو أنسب لمزودي الاستدلال الذين يحاسبون بالرمز.
بقدر حجم النموذج يكون حجم الجهاز المطلوب؟
الجواب المختصر: قدِّر الحد الأدنى لذاكرة الفيديو بمعادلة «أوزان النموذج × 1.2 (هامش لـ KV Cache)»، ثم حدد عدد البطاقات من الجدول أدناه؛ أما النماذج التي تتجاوز عقدة واحدة فتنتقل إلى التوازي متعدد الأجهزة، حيث تصبح الشبكة أهم من وحدات معالجة الرسوميات.
النموذج المستهدف (2026) | حجم الأوزان | الحد الأدنى للتكوين | الشكل الموصى به للنظام |
7B–14B (فئة Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 أو بطاقة محطة عمل 48GB | خادم استدلال حافة برجي/2U |
32B–70B (تكميم FP8) | 40–80GB | RTX PRO 6000 ×1–2 أو H200 ×1 | خادم GPU بشكل 2U/4U |
70B FP16 / سياق طويل | ~140GB+ | H200 ×1 (بالكاد) أو ×2 (بأمان) | خادم متعدد البطاقات 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (هامش ~130GB) | خادم 4U بتبريد سائل |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 أو B300 ×4 | نظام SXM بثماني بطاقات |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (إجمالي 2.3TB من ذاكرة الفيديو) | نظام رائد بثماني بطاقات وتبريد سائل |
الجدول 2: مقابلة حجم النموذج مع تكوين الخادم (الأوزان وفق نقاط التحقق الرسمية؛ وعند النشر الفعلي يجب إضافة KV Cache وعبء بيئة التشغيل)
يفسر هذا الجدول أيضًا لماذا تُعد هيكلة 4U «المواصفة المثلى» لخوادم الذكاء الاصطناعي: 8 بطاقات مزدوجة العرض، ووحدات إمداد طاقة احتياطية، وقنوات هواء تبريد كافية — لا يتسع لها جميعًا إلا فضاء 4U. ويناسب 2U عقد الاستدلال من 2–4 بطاقات، بينما لا يسع 1U إلا بطاقة واحدة أو يعمل عقدة أمامية للجدولة/التخزين.
تبريد هوائي أم سائل؟ وكيف تُحدَّد المواصفات الحرارية ومواصفات الحامل؟
الجواب المختصر: دون 700W للبطاقة يكفي التبريد الهوائي؛ وفوق 1000W للبطاقة — أو ما يتجاوز 20kW للحامل الواحد — يتحول التبريد السائل من «ميزة إضافية» إلى «شرط صارم». واستهلاك B300 الحراري التصميمي البالغ نحو 1400W يفرض التبريد السائل عمليًا.
الترتيب الصحيح للاختيار هو: حدد النموذج والبطاقة أولًا، ثم قدرة الجهاز الكلية، وأخيرًا احسب عكسيًا متطلبات التبريد وظروف غرفة الخوادم. كثير من الشركات تفعل العكس — تشتري الأجهزة أولًا ثم تكتشف أن إمداد الكهرباء والتكييف لا يحتملان، فتُضطر إلى خفض التردد، وكأنها دفعت السعر الكامل مقابل بطاقة «مخصية». قبل الشراء تأكد من ثلاثة أمور: إمداد الحامل بالكهرباء (kW)، ودرجة حرارة هواء السحب وحجمه، والهامش لأجيال وحدات معالجة الرسوميات القادمة 2–3 (فبعد B300 لن ترتفع قيم TDP إلا أكثر).
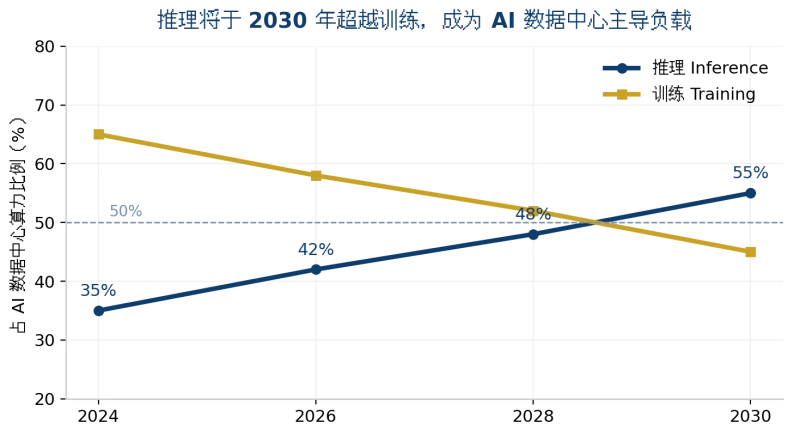
الشكل 2: سيتجاوز الاستدلال التدريب ليصبح الحِمل المهيمن في مراكز بيانات الذكاء الاصطناعي بحلول 2030 (رسم توضيحي للاتجاه؛ مصادر البيانات في الملحق)
استئجار سحابي أم بناء ذاتي؟ وكيف تُحسب التكاليف؟
الجواب المختصر: عند استغلال أقل من 60% اختر الاستئجار السحابي، وعند الأحمال العالية المستدامة اختر البناء الذاتي. وبأسعار أغسطس 2026، يبلغ الاستئجار السحابي لبطاقة H200 نحو 4.4 لكل GPU·ساعة — أي نحو38 ألفًا لسنة كاملة بالحِمل الكامل، وهو رقم قريب من تكلفة شراء بطاقة واحدة. وكلما ارتفع الاستغلال، أسرع البناء الذاتي في استرداد تكلفته.
وعلى حساب البناء الذاتي أن يضيف ثلاثة بنود أخرى: كهرباء غرفة الخوادم وتشغيل التبريد (نحو 20–30% من التكلفة الإجمالية للملكية)، والإهلاك الناتج عن أجيال وحدات معالجة الرسوميات (ففي 2026 أصبحت H100 منخفضة القيمة بعمق — وخطر القيمة المتبقية حقيقي)، والامتثال للبيانات — فعملاء المال والصحة والقطاع الحكومي لا تغادر بياناتهم الشبكة الداخلية، مما يجعل النشر الخاص ليس خيارًا بل التزامًا. والمعمارية الهجينة آخذة في التعميم: ذروة التدريب في السحابة، والاستدلال الدائم محليًا.
ChangFan: خوادم GPU وعتاد ذكاء اصطناعي مهيأة لعصر الاستدلال
في المحصلة، لا يُحسم اختيار خادم الذكاء الاصطناعي في جداول المواصفات، بل في مدى تطابق التكوين مع السيناريو. تقدم شركة Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) خوادم GPU رفيفة التركيب وأنظمة استدلال ذكاء اصطناعي بعوامل الشكل 1U/2U/4U، مع دعم التوسعة متعددة البطاقات ووحدات الطاقة الاحتياطية والتصميم واسع النطاق الحراري. ويمكن تخصيص عدد البطاقات وتكوين ذاكرة الفيديو وحل التبريد (هوائي/سائل) وفق حجم النموذج المستهدف — قاعدة عتاد مستقرة وموثوقة للنشر الخاص للنماذج اللغوية الكبيرة وعقد الاستدلال الطرفية وقواعد معرفة المؤسسات.
إذا كنتم تقيّمون شراء ونشر خوادم GPU من فئة H200/B200/B300 أو RTX PRO 6000، يسعدنا تواصلكم مع ChangFan للحصول على استشارة تكوين وعروض أنظمة متكاملة مصممة لنموذجكم المستهدف (نبيع العتاد ونصنع الأنظمة المتكاملة — ولا نقدم خدمات اشتراك برمجية).
الأسئلة الشائعة (FAQ)
س1: ما الحد الأدنى من التكوين لتشغيل نموذج لغوي كبير 70B؟ ج: بدقة FP16 تحتاج نحو 140GB من ذاكرة الفيديو، لذا فإن بطاقة H200 واحدة هي الجواب الأكثر اقتصادًا؛ وبعد التكميم إلى FP8، تفي بطاقتا RTX PRO 6000 (96GB×2) أيضًا بالغرض بتكلفة أقل ومرونة نشر أكبر.
س2: بم تتفوق B300 على B200، وهل يستحق الأمر الانتظار؟ ج: توفر B300 ذاكرة فيديو أكبر بنسبة 50% (288GB مقابل 192GB) وقوة FP4 أعلى بمقدار 1.5 ضعف، لكن بالنطاق الترددي نفسه واستهلاك حراري تصميمي يرتفع إلى نحو 1400W يتطلب تبريدًا سائلًا. ولا يستحق الترقية إلا عندما يتجاوز النموذج أو KV Cache سعة عقدة B200.
س3: بم تنصحون الشركات الصغيرة والمتوسطة عند شراء أول خادم ذكاء اصطناعي؟ ج: حددوا أولًا النموذج الذي ستشغلونه. لتطبيقات مستوى 7B–14B (خدمة العملاء وقواعد المعرفة وفحص الجودة) يكفي للبدء خادم استدلال 2U ببطاقة واحدة؛ وعند تأكيد الحِمل العالي المستدام توسعوا إلى 4U متعدد البطاقات.
س4: هل التبريد السائل إلزامي لخوادم الذكاء الاصطناعي؟ ج: لا. دون 700W للبطاقة ومع ظروف غرفة جيدة يكفي الهواء؛ ولا يلزم السائل إلا فوق 1000W للبطاقة أو في عمليات النشر الكثيفة متعددة الحوامل. وعند الاختيار، اتركوا هامشًا لاتجاه استهلاك أجيال وحدات معالجة الرسوميات القادمة 2–3.
س5: وحدات GPU السحابية رخيصة إلى هذا الحد — فلماذا شراء خادم خاص؟ ج: ثلاثة أسباب — فوق نحو 60% من الاستغلال يصبح البناء الذاتي أقل تكلفة؛ والبيانات الحساسة لا يسمح لها بمغادرة الشبكة الداخلية؛ والاستدلال المحلي بلا زمن استجابة شبكي وباتفاقية مستوى خدمة تحت سيطرتكم. وتنتهي معظم الشركات إلى معمارية هجينة «التدريب في السحابة والاستدلال محليًا».