Comment choisir un serveur IA ? Le guide complet 2026 de configuration matérielle pour l'entraînement et l'inférence
Introduction : pourquoi le choix d'un serveur IA est devenu un cours obligatoire en 2026
La structure des dépenses de calcul IA change fondamentalement. Selon une analyse publiée par McKinsey en février 2026, d'ici 2030 l'inférence dépassera l'entraînement pour devenir la charge dominante des data centers IA, représentant plus de la moitié de tout le calcul IA et environ 30 à 40 % de la demande totale des data centers. Pour les entreprises, la logique d'achat de serveurs passe de « l'empilement de cartes pour l'entraînement » à « l'inférence au coût maîtrisé » — une mauvaise configuration ne se paie pas une seule fois trop cher : elle se paie chaque jour pendant trois ans, en électricité et en loyer, pour une architecture inadaptée.
Dans le même temps, le rythme d'itération des GPU s'est nettement accéléré : à peine les 141 Go de VRAM du H200 sont-ils arrivés que les 192 Go du B200 et les 288 Go du B300 se déploient déjà, tandis que le RTX PRO 6000 taille sa part du marché de l'inférence milieu de gamme avec 96 Go et un format PCIe. Plus il y a de modèles, plus le choix devient difficile. Cet article clarifie le choix d'un serveur IA en 2026 à l'aide d'un axe de décision et de deux tableaux comparatifs.
Quelle est exactement la différence entre un serveur d'entraînement et un serveur d'inférence ?
Réponse rapide : l'entraînement est un mégaprojet ponctuel « intensif en calcul », l'inférence est un service continu « intensif en VRAM et en bande passante ». Le serveur d'entraînement recherche la puissance de crête d'une interconnexion multi-GPU (fabric NVLink/NVSwitch complète, haute densité de puissance, refroidissement liquide) ; le serveur d'inférence recherche un débit stable par unité de coût (VRAM qui contient le modèle, bande passante qui débite les tokens, consommation par carte maîtrisée, fiabilité 7×24).
Côté matériel, les clusters d'entraînement privilégient les machines 8 GPU au format SXM avec réseau InfiniBand ; l'inférence offre un éventail bien plus large — stations de travail mono-GPU RTX PRO 6000, serveurs multi-GPU 2U/4U, voire petits nœuds d'inférence en périphérie. La réalité de 2026 : l'immense majorité des budgets IA des entreprises va à l'inférence ; le choix des serveurs doit donc suivre le principe « l'inférence d'abord, l'entraînement à la demande ».
Pourquoi la VRAM compte-t-elle plus que la puissance de calcul dans le choix d'un serveur IA ?
Réponse rapide : si le modèle ne tient pas en VRAM, les TFLOPS les plus élevés valent zéro. La capacité d'un modèle à fonctionner dépend de la VRAM occupée par les poids + le KV Cache + la longueur de contexte ; ce n'est qu'une fois le modèle logé que la bande passante, la prise en charge FP4/FP8 et le prix deviennent des critères de comparaison pertinents.
Règle empirique (2026) : en précision FP16, un modèle 70B requiert environ 140 Go de VRAM — un seul H200 (141 Go) le contient tout juste, sinon il faut deux H100 ; la quantification FP8 divise le besoin par deux ; FP4 le divise encore par deux, mais seule l'architecture Blackwell (B200/B300/RTX PRO 6000) prend FP4 en charge nativement. Chaque doublement de la fenêtre de contexte fait croître le KV Cache de façon quasi linéaire — c'est pourquoi entre « ça tient » et « ça sert bien », il reste la bande passante : 4,8 To/s pour le H200, 8 To/s pour les B200/B300.
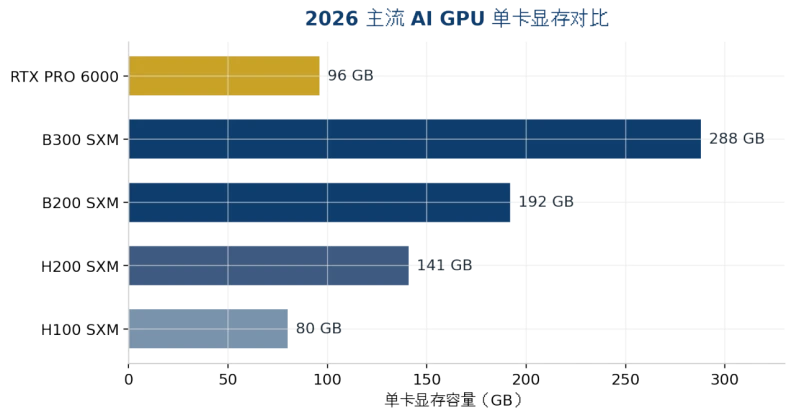
Figure 1 : Comparaison de la VRAM par carte des principaux GPU IA en 2026 (sources des données en annexe)
Comment choisir parmi les GPU phares de 2026 : H200 vs B200 vs B300 vs RTX PRO 6000
Réponse rapide : pour les modèles jusqu'à 141 Go, le H200 offre le meilleur rapport qualité-prix ; choisissez le B200 si vous avez besoin de FP4 ou de plus de VRAM ; choisissez le B300 si une seule carte doit contenir un modèle de plus de 200 Go ou si la pression du KV Cache est forte ; choisissez le RTX PRO 6000 pour l'inférence milieu de gamme et les environnements PCIe.
Dimension | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Architecture | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Bande passante mémoire | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Puissance FP4 | Non prise en charge | 9 PFLOPS | 15 PFLOPS | Prise en charge (classe mono-GPU) |
TDP / refroidissement | 700 W / air possible | 1000 W / liquide recommandé | ~1400 W / liquide quasi obligatoire | 600 W / air |
Positionnement type | Inférence 70B–100B, fine-tuning | Inférence 100B+, entraînement | LLM de pointe sur un seul nœud | Inférence milieu de gamme, station/périphérie |
Référence location cloud 2026 | ~$4.4/GPU·h | ~$5–7/GPU·h | ~$7.4–8.3/GPU·h | Achat de machines complètes surtout |
Tableau 1 : Spécifications clés et positionnement des principaux GPU IA en 2026 (prix indicatifs du marché en août 2026, très volatils — redemander un devis avant tout achat)
Deux tendances passent facilement inaperçues : premièrement, le prix médian de la location cloud du H200 a augmenté d'environ 25 % depuis août 2025, l'écart de prix entre Hopper et Blackwell se resserre, et la fenêtre « économiser avec l'ancienne génération » se referme ; deuxièmement, le RTX PRO 6000 existe désormais en version Server de 400 W, ce qui permet d'installer plus de cartes dans le même budget de puissance — un atout pour les fournisseurs d'inférence facturant au token.
Quelle taille de modèle pour quelle machine ?
Réponse rapide : estimez le plancher de VRAM par « poids du modèle × 1,2 (marge pour le KV Cache) », puis déterminez le nombre de GPU à l'aide du tableau ci-dessous ; les modèles dépassant un seul nœud passent au parallélisme multi-machines, où le réseau compte plus que les GPU.
Modèle cible (2026) | Taille des poids | Configuration minimale | Forme de machine recommandée |
7B–14B (classe Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 ou carte station 48 Go | Serveur d'inférence edge tour/2U |
32B–70B (quantification FP8) | 40–80GB | RTX PRO 6000 ×1–2 ou H200 ×1 | Serveur GPU 2U/4U |
70B FP16 / long contexte | ~140GB+ | H200 ×1 (juste) ou ×2 (confortable) | Serveur multi-GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (marge ~130 Go) | Serveur 4U à refroidissement liquide |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 ou B300 ×4 | Machine 8 GPU SXM |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3 To de VRAM au total) | Machine flagship 8 GPU à refroidissement liquide |
Tableau 2 : Correspondance entre taille de modèle et configuration serveur (poids selon les checkpoints officiels ; en déploiement réel, ajouter le KV Cache et la surcharge du runtime)
Ce tableau explique aussi pourquoi le châssis 4U est le « sweet spot » des serveurs IA : 8 GPU double largeur, alimentations redondantes et flux d'air de refroidissement suffisant — seul un 4U peut accueillir les trois à la fois. Le 2U convient aux nœuds d'inférence de 2 à 4 cartes ; le 1U n'accepte qu'une seule carte ou sert de nœud frontal d'ordonnancement/stockage.
Refroidissement à air ou liquide ? Comment définir les spécifications thermiques et rack ?
Réponse rapide : sous 700 W par carte, le refroidissement à air suffit ; au-delà de 1000 W par carte — ou de 20 kW par armoire — le refroidissement liquide passe de « bonus » à « exigence impérative ». Le TDP d'environ 1400 W du B300 impose de fait le refroidissement liquide.
L'ordre de sélection correct est : d'abord le modèle et le GPU, ensuite la puissance totale de la machine, et seulement après le calcul en retour du refroidissement et des conditions de la salle. Beaucoup d'entreprises font l'inverse — elles achètent les machines d'abord, puis découvrent que l'alimentation électrique et la climatisation ne suivent pas, et sont contraintes de brider les cartes : c'est payer plein tarif pour un GPU « castré ». Avant tout achat, vérifiez trois points : l'alimentation de l'armoire (kW), la température et le débit d'air entrant, et la marge pour les 2–3 prochaines générations de GPU (après le B300, les TDP ne feront qu'augmenter).
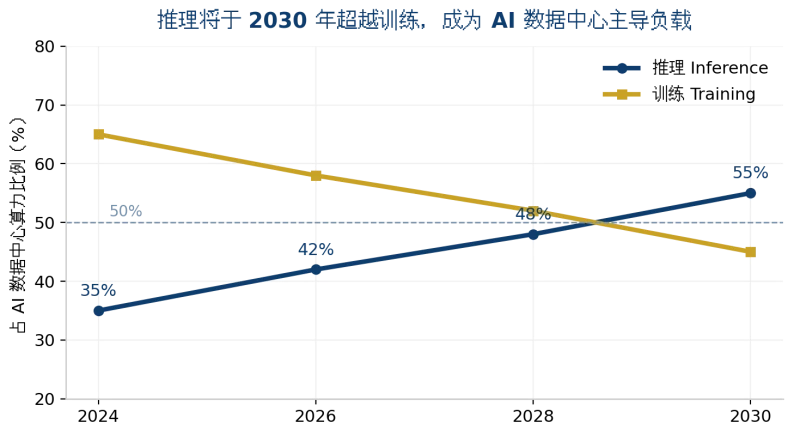
Figure 2 : D'ici 2030, l'inférence dépassera l'entraînement comme charge dominante des data centers IA (illustration de tendance ; sources des données en annexe)
Location cloud ou infrastructure propre ? Comment faire les comptes ?
Réponse rapide : sous 60 % d'utilisation, louez dans le cloud ; pour des charges élevées et durables, construisez votre propre infrastructure. Aux tarifs d'août 2026, la location cloud d'un H200 coûte environ 4,4 /GPU·heure — soit près de 38 000 pour une année complète à pleine charge, proche du prix d'achat d'une carte. Plus l'utilisation est élevée, plus l'infrastructure propre s'amortit vite.
Le bilan de l'infrastructure propre doit ajouter trois postes : l'électricité et l'exploitation du refroidissement (environ 20 à 30 % du coût total de possession), la dépréciation liée aux générations de GPU (en 2026, le H100 est déjà fortement dévalué — le risque de valeur résiduelle est réel), et la conformité des données — pour les clients de la finance, de la santé et du secteur public, les données ne quittent pas l'intranet : le déploiement privé n'est pas une option mais une obligation. L'architecture hybride devient la norme : entraînement de pointe dans le cloud, inférence permanente en local.
ChangFan : des serveurs GPU et du matériel IA pensés pour l'ère de l'inférence
En fin de compte, le choix d'un serveur IA ne se gagne pas sur les fiches techniques, mais sur l'adéquation entre configuration et scénario. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) propose des serveurs GPU rackables et des machines d'inférence IA en formats 1U/2U/4U, avec extension multi-GPU, alimentations redondantes et conception à température étendue. Le nombre de GPU, la configuration VRAM et le refroidissement (air/liquide) se personnalisent selon la taille du modèle cible — une base matérielle stable et fiable pour le déploiement privé de LLM, les nœuds d'inférence en périphérie et les bases de connaissances d'entreprise.
Si vous évaluez l'achat et le déploiement de serveurs GPU de classe H200/B200/B300 ou RTX PRO 6000, contactez ChangFan pour obtenir des conseils de configuration et des propositions de machines complètes adaptées à votre modèle cible (nous vendons du matériel et construisons des machines complètes — nous ne proposons pas de services d'abonnement logiciel).
Foire aux questions (FAQ)
Q1 : Quelle configuration minimale pour faire tourner un LLM 70B ? R : En FP16, il faut environ 140 Go de VRAM — un seul H200 est la réponse la plus économique ; après quantification FP8, deux RTX PRO 6000 (96 Go × 2) font également l'affaire, à moindre coût et avec plus de souplesse de déploiement.
Q2 : En quoi le B300 est-il supérieur au B200, et vaut-il la peine d'attendre ? R : Le B300 offre 50 % de VRAM en plus (288 Go contre 192 Go) et 1,5× la puissance FP4, mais une bande passante identique et un TDP porté à ~1400 W exigeant un refroidissement liquide. La mise à niveau ne vaut le coup que si votre modèle ou votre KV Cache dépasse la capacité d'un nœud B200.
Q3 : Par quoi une PME devrait-elle commencer pour son premier serveur IA ? R : Définissez d'abord le modèle à exécuter. Pour des applications 7B–14B (service client, base de connaissances, contrôle qualité), un serveur d'inférence 2U mono-GPU suffit pour démarrer ; passez au 4U multi-GPU une fois la charge élevée et durable confirmée.
Q4 : Le refroidissement liquide est-il obligatoire pour un serveur IA ? R : Non. Sous 700 W par carte avec une salle en bon état, l'air suffit ; le liquide ne s'impose qu'au-delà de 1000 W par carte ou dans les déploiements multi-armoires haute densité. Prévoyez une marge pour la tendance de consommation des 2–3 prochaines générations de GPU.
Q5 : Les GPU cloud sont si bon marché — pourquoi acheter son propre serveur ? R : Trois raisons — au-delà d'environ 60 % d'utilisation, l'infrastructure propre coûte moins cher ; les données sensibles ne peuvent pas quitter l'intranet ; l'inférence locale n'a pas de latence réseau et son SLA est maîtrisé. La plupart des entreprises aboutissent à une architecture hybride « entraînement dans le cloud, inférence en local ».