AI 서버는 어떻게 선택할까? 2026 학습 및 추론 하드웨어 구성 완전 가이드
- 광저우 창판 지능형 기술 유한회사
- 2026-10-10
서론: AI 서버 선택이 2026년의 필수 과목이 된 이유
AI 컴퓨팅 지출의 구조가 근본적으로 바뀌고 있습니다. McKinsey가 2026년 2월에 발표한 분석에 따르면, 2030년이면 추론(inference)이 학습을 추월해 AI 데이터센터의 주요 부하가 되어 전체 AI 컴퓨팅의 절반 이상, 데이터센터 총수요의 약 30%–40%를 차지합니다. 이는 기업의 서버 구매 논리가 "학습용 카드 쌓기"에서 "알뜰하게 추론 돌리기"로 바뀌고 있음을 의미합니다 — 구성을 잘못 선택하면 한 번 비싸게 사는 것으로 끝나지 않고, 향후 3년 동안 매일 잘못된 아키텍처에 전기료와 임대료를 내게 됩니다.
동시에 GPU 제품의 세대교체 속도가 눈에 띄게 빨라졌습니다. H200의 141GB VRAM이 채 자리 잡기도 전에 B200의 192GB와 B300의 288GB가 보급됐고, RTX PRO 6000은 96GB VRAM과 PCIe 폼팩터로 중급 추론 시장을 가져갔습니다. 모델이 많아질수록 선택은 오히려 어려워집니다. 본문은 하나의 의사결정 축과 두 장의 대조표로 2026년 AI 서버 선택을 명쾌하게 정리합니다.
학습 서버와 추론 서버는 도대체 무엇이 다를까?
한 줄 답변: 학습은 "컴퓨팅 집약적"인 일회성 대형 프로젝트이고, 추론은 "VRAM과 대역폭 집약적"인 지속형 서비스입니다. 학습 서버는 멀티카드 인터커넥트의 최고 컴퓨팅 성능을 추구하고 (NVLink/NVSwitch 풀 메시, 고전력 밀도, 액체 냉각), 추론 서버는 단위 비용 대비 안정적인 처리량을 추구합니다 (VRAM에 모델이 들어가고, 대역폭이 토큰을 뽑아내고, 단카드 전력이 제어되며, 7×24 안정적).
하드웨어로 내려오면, 학습 클러스터는 SXM 폼팩터의 8카드 완성형 서버와 IB 네트워크를 우선시하고, 추론 배포는 더 넓은 선택지가 있습니다 — 단카드 RTX PRO 6000 워크스테이션, 2U/4U 멀티카드 서버, 심지어 엣지 측 소형 추론 노드까지. 2026년의 현실은 대부분 기업의 AI 예산이 추론에 쓰인다는 것이며, 서버 선택 역시 "추론 우선, 학습은 필요에 따라"여야 합니다.
AI 서버 선택, 왜 VRAM이 컴퓨팅 성능보다 중요할까?
한 줄 답변: 모델이 VRAM에 들어가지 않으면 TFLOPS가 아무리 높아도 0입니다. 모델이 돌아갈 수 있는지는 가중치 + KV Cache + 컨텍스트 길이가 VRAM을 얼마나 차지하느냐에 달려 있으며, 들어간 다음에야 대역폭, FP4/FP8 지원, 가격을 비교할 의미가 생깁니다.
경험 법칙 (2026년): FP16 정밀도에서 70B 모델은 약 140GB VRAM이 필요하며, H200 한 장 (141GB)이면 딱 맞고 그렇지 않으면 H100 두 장이 필요합니다. FP8 양자화 후에는 필요량이 절반으로, FP4는 다시 절반으로 줄지만 FP4는 Blackwell 아키텍처 (B200/B300/RTX PRO 6000)만 네이티브로 지원합니다. 컨텍스트 윈도우가 두 배로 길어질 때마다 KV Cache 점유는 거의 선형으로 늘어납니다 — 이것이 "넣을 수 있다"와 "잘 서비스할 수 있다" 사이에 대역폭이라는 간극이 있는 이유입니다: H200은 4.8 TB/s, B200/B300은 8 TB/s입니다.
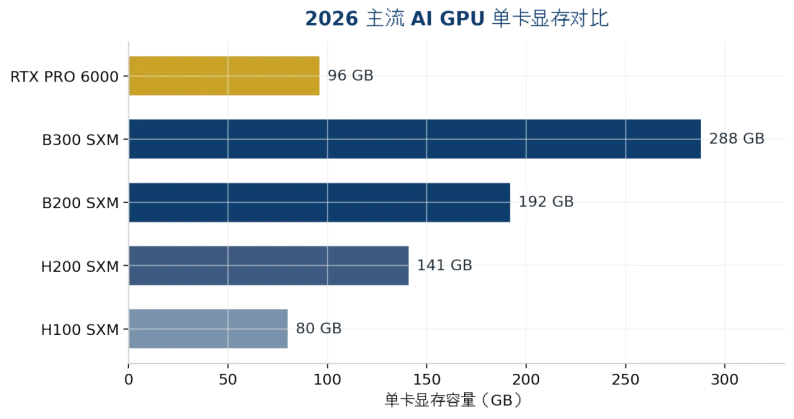
그림 1: 2026 주류 AI GPU 단카드 VRAM 비교 (데이터 출처는 부록 참조)
2026년 주류 GPU는 어떻게 고를까: H200, B200, B300, RTX PRO 6000 비교
한 줄 답변: 모델이 141GB 이내라면 H200이 가성비 최고, FP4나 더 큰 VRAM이 필요하면 B200, 단카드로 200GB 이상 모델을 담거나 KV Cache 부담이 크면 B300, 중급 추론과 PCIe 환경이라면 RTX PRO 6000을 선택하세요.
차원 | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
아키텍처 | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
메모리 대역폭 | 4.8 TB/s | 8 TB/s | 8 TB/s | 약 1.8 TB/s |
FP4 컴퓨팅 | 미지원 | 9 PFLOPS | 15 PFLOPS | 지원 (단카드급) |
TDP / 냉각 | 700W / 공랭 가능 | 1000W / 액체 냉각 권장 | 약 1400W / 사실상 액체 냉각 필요 | 600W / 공랭 |
대표 포지셔닝 | 70B–100B 추론, 파인튜닝 | 100B+ 추론, 학습 | 프론티어 대형 모델 단일 머신 수용 | 중급 추론, 워크스테이션/엣지 |
2026 클라우드 임대 참고 | 약 $4.4/GPU·시간 | 약 $5–7/GPU·시간 | 약 $7.4–8.3/GPU·시간 | 완성형 장비 구매 위주 |
표 1: 2026 주류 AI GPU 핵심 사양 및 포지셔닝 비교 (가격은 2026년 8월 시장 참고가로 변동이 크므로 구매 전 재견적 필요)
간과하기 쉬운 두 가지 트렌드가 더 있습니다. 첫째, H200의 클라우드 임대 중간가가 2025년 8월 이후 약 25% 상승했고 Hopper와 Blackwell의 가격 차이가 좁혀지면서 "구형을 사서 절약하는" 창이 닫히고 있습니다. 둘째, RTX PRO 6000은 400W Server 버전을 출시해 같은 전력 예산으로 더 많은 카드를 배치할 수 있어 토큰당 과금 추론 서비스 사업자에게 더 유리합니다.
모델이 얼마나 크면, 장비는 어느 정도로?
한 줄 답변: "모델 가중치 × 1.2 (KV Cache 여유분)"로 VRAM 하한을 추정한 뒤 아래 표와 대조해 GPU 수를 정하고, 단일 노드를 넘는 모델은 멀티머신 병렬로 넘어가며 이때는 GPU보다 네트워크가 더 중요합니다.
대상 모델 (2026) | 가중치 크기 | 최소 구성 | 권장 장비 형태 |
7B–14B (Qwen/Phi급) | 15–30GB (FP16) | RTX PRO 6000 ×1 또는 48GB 워크스테이션 카드 | 타워/2U 엣지 추론 서버 |
32B–70B (FP8 양자화) | 40–80GB | RTX PRO 6000 ×1–2 또는 H200 ×1 | 2U/4U GPU 서버 |
70B FP16 / 롱컨텍스트 | 약 140GB+ | H200 ×1 (아슬아슬) 또는 ×2 (여유) | 4U 멀티카드 서버 |
DeepSeek V4 Flash (156GB) | 약 156GB | B300 ×1 (여유 약 130GB) | 4U 액체 냉각 서버 |
GLM-5.2 FP8 (약 756GB) | 약 756GB | H200 ×8 또는 B300 ×4 | 8카드 SXM 완성형 |
Kimi K3 (1.56TB MXFP4) | 약 1.56TB | B300 ×8 (총 VRAM 2.3TB) | 8카드 액체 냉각 플래그십 완성형 |
표 2: 모델 규모와 서버 구성 대조표 (가중치는 공식 체크포인트 기준이며 실제 배포 시 KV Cache와 런타임 오버헤드를 더해야 함)
이 표는 4U 섀시가 AI 서버의 "스위트 스폿"인 이유도 설명합니다: 듀얼 슬롯 GPU 8장, 이중화 전원, 충분한 냉각 풍로를 동시에 수용할 수 있는 공간은 4U뿐입니다. 2U는 2–4카드 추론 노드에 적합하고, 1U는 단카드 또는 프런트엔드 스케줄링/스토리지 노드로만 적합합니다.
공랭이냐 수냉이냐? 냉각과 랙 사양은 어떻게 정할까?
한 줄 답변: 단카드 700W 이하는 공랭으로 충분하고, 단카드 1000W 이상이거나 랙당 전력이 20kW를 넘으면 액체 냉각이 "가산점"에서 "하드 요건"으로 바뀝니다. B300의 약 1400W TDP는 사실상 액체 냉각을 강제합니다.
올바른 선택 순서는 모델과 GPU를 먼저 정하고, 전체 장비 전력을 정한 다음, 냉각과 전산실 조건을 역산하는 것입니다. 많은 기업이 반대로 합니다 — 장비부터 샀다가 전산실의 전력과 에어컨이 감당하지 못한다는 것을 뒤늦게 알고 강제로 다운클럭해 돌리는데, 이는 돈을 내고 "반쪽짜리" GPU를 산 셈입니다. 구매 전 반드시 세 가지를 확인하세요: 랙 급전 (kW), 흡기 온도와 풍량, 향후 2–3세대 GPU의 업그레이드 여유 (B300 이후 TDP는 더 높아질 뿐입니다).
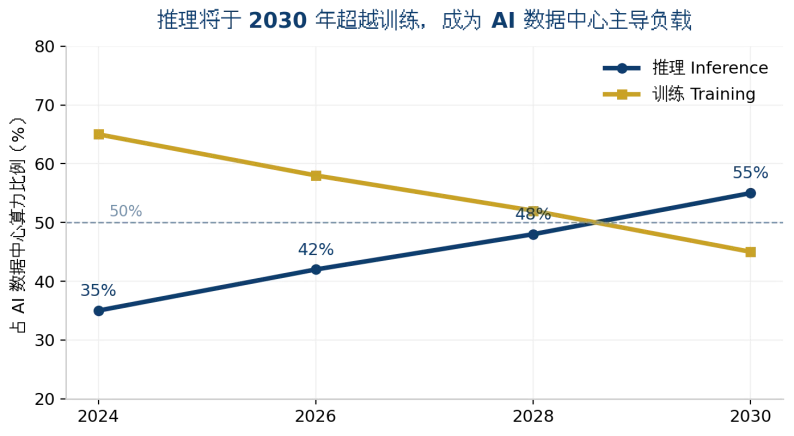
그림 2: 추론이 2030년 학습을 추월해 AI 데이터센터의 주요 부하가 된다 (트렌드 시각화, 데이터 출처는 부록 참조)
클라우드 임대냐 자체 구축이냐? 비용은 어떻게 계산할까?
한 줄 답변: 가동률이 60% 미만이면 클라우드 임대, 장기 고부하라면 자체 구축을 선택하세요. 2026년 8월 시세로 H200 클라우드 임대는 약 4.4/GPU·시간이며, 카드 한 장이 연중 풀가동되면 임대료가 약38,000 — 카드 한 장 자체 구매 비용에 근접합니다. 가동률이 높아지면 자체 구축이 곧 손익분기를 넘깁니다.
자체 구축파의 장부에는 세 가지가 더 얹힙니다: 전산실 전기료와 냉각 유지보수 (총소유비용의 약 20%–30%), GPU 세대교체 감가상각 (2026년 H100은 이미 깊게 할인되어 잔존가치 리스크가 실재합니다), 그리고 데이터 컴플라이언스 — 금융, 의료, 공공 고객의 데이터는 내부망을 벗어날 수 없어 프라이빗 배포는 선택이 아닌 필수입니다. 하이브리드 아키텍처가 주류가 되고 있습니다: 피크 학습은 클라우드로, 상주 추론은 온프레미스로.
ChangFan Industrial Computing: 추론 시대를 위한 GPU 서버와 AI 하드웨어
AI 서버 선택은 결국 스펙표 싸움이 아니라 "구성과 시나리오의 적합도" 싸움입니다. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan)은 1U/2U/4U를 아우르는 랙마운트 GPU 서버와 AI 추론 장비를 제공하며, 멀티카드 확장, 이중화 전원, 광온 설계를 지원하고 목표 모델 규모에 맞춰 GPU 수량, VRAM 구성, 공랭/수냉 냉각 방안을 커스터마이즈할 수 있습니다. 프라이빗 대형 모델 배포, 엣지 추론 노드, 기업 지식베이스 등 시나리오에 안정적이고 신뢰할 수 있는 하드웨어 기반을 제공합니다.
H200/B200/B300 또는 RTX PRO 6000급 GPU 서버의 구매와 배포를 검토 중이라면, ChangFan Industrial Computing에 문의해 목표 모델에 맞는 구성 제안과 완성형 장비 솔루션을 받아 보세요 (하드웨어 판매와 완성형 장비 제작 전문이며 소프트웨어 구독 서비스는 제공하지 않습니다).
자주 묻는 질문 (FAQ)
Q1: 70B 대형 모델을 돌리려면 최소 어떤 구성이 필요한가요? A: FP16은 약 140GB VRAM이 필요하며 H200 한 장이 가장 경제적인 답입니다. FP8 양자화 후에는 RTX PRO 6000 두 장 (96GB×2)으로도 충분하며 비용이 더 낮고 배포도 유연합니다.
Q2: B300이 B200보다 나은 점은 무엇이고 기다릴 가치가 있나요? A: B300은 VRAM이 50% 더 많고 (288GB 대 192GB) FP4 컴퓨팅이 1.5배 높지만, 대역폭은 같고 TDP가 약 1400W로 올라 액체 냉각이 필요합니다. 모델이나 KV Cache가 B200 노드 용량을 넘을 때만 업그레이드할 가치가 있습니다.
Q3: 중소기업이 처음 AI 서버를 사는데 무엇부터 시작하면 좋을까요? A: 먼저 돌릴 모델을 명확히 하세요. 7B–14B급 애플리케이션 (고객 서비스, 지식베이스, 품질 검사)은 2U 단카드 추론 서버 한 대로 시작하면 됩니다. 장기 고부하가 확정되면 4U 멀티카드로 확장하세요.
Q4: AI 서버는 반드시 액체 냉각이어야 하나요? A: 아닙니다. 단카드 700W 이하이고 전산실 조건이 좋은 시나리오는 공랭으로 충분하며, 단카드 1000W 이상이거나 고밀도 멀티랙 배포에서만 액체 냉각이 필요합니다. 선택 시 향후 2–3세대 GPU의 전력 추세에 맞춰 여유를 두세요.
Q5: 클라우드 GPU가 이렇게 싼데 왜 서버를 직접 사야 하나요? A: 세 가지 이유입니다 — 가동률이 약 60%를 넘으면 자체 구축이 더 저렴하고, 민감한 데이터는 내부망을 벗어날 수 없으며, 로컬 추론은 네트워크 지연이 없고 SLA를 자체 통제할 수 있습니다. 대부분 기업은 결국 "학습은 클라우드, 추론은 온프레미스" 하이브리드 아키텍처를 채택합니다.