AI सर्वर कैसे चुनें? ट्रेनिंग और इन्फरेंस के लिए संपूर्ण हार्डवेयर कॉन्फ़िगरेशन गाइड 2026
भूमिका: 2026 में AI सर्वर चयन अनिवार्य पाठ क्यों बन गया
AI कंप्यूटिंग खर्च की संरचना मौलिक रूप से बदल रही है। McKinsey द्वारा फ़रवरी 2026 में प्रकाशित विश्लेषण के अनुसार, 2030 तक इन्फरेंस (inference) ट्रेनिंग से आगे निकलकर AI डेटा सेंटरों का प्रमुख वर्कलोड बन जाएगा — कुल AI कंप्यूटिंग का आधे से अधिक और डेटा सेंटरों की कुल मांग का लगभग 30–40%। इसका अर्थ है कि उद्यमों के सर्वर खरीदने का तर्क «ट्रेनिंग के लिए कार्ड जमा करने» से बदलकर «इन्फरेंस को बचत से चलाने» की ओर जा रहा है — गलत कॉन्फ़िगरेशन की कीमत एक बार का अतिरिक्त भुगतान नहीं, बल्कि आगामी तीन वर्षों तक हर दिन गलत आर्किटेक्चर का बिजली और किराए का बिल है।
साथ ही, GPU उत्पादों की पुनरावृत्ति की गति स्पष्ट रूप से तेज़ हो गई है: H200 की 141GB VRAM अभी पूरी तरह जम भी नहीं पाई थी कि B200 की 192GB और B300 की 288GB फैलने लगीं, जबकि RTX PRO 6000 ने 96GB VRAM और PCIe फ़ॉर्म फ़ैक्टर के साथ मध्य-स्तरीय इन्फरेंस बाज़ार का हिस्सा काट लिया। मॉडल जितने ज़्यादा, चुनाव उतना ही कठिन। यह लेख एक निर्णय अक्ष और दो तुलना तालिकाओं के माध्यम से 2026 का AI सर्वर चयन स्पष्ट करता है।
ट्रेनिंग सर्वर और इन्फरेंस सर्वर में असल में क्या अंतर है?
संक्षिप्त उत्तर: ट्रेनिंग एक «कम्प्यूट-गहन» एकमुश्त बड़ा प्रोजेक्ट है, इन्फरेंस एक «VRAM और बैंडविड्थ-गहन» निरंतर सेवा। ट्रेनिंग सर्वर मल्टी-कार्ड इंटरकनेक्ट की चरम क्षमता चाहता है (पूर्ण NVLink/NVSwitch फ़ैब्रिक, उच्च पावर घनत्व, लिक्विड कूलिंग); इन्फरेंस सर्वर प्रति यूनिट लागत पर स्थिर थ्रूपुट चाहता है (VRAM जिसमें मॉडल समा जाए, बैंडविड्थ जो टोकन निकाले, प्रति कार्ड नियंत्रित बिजली, और 7×24 विश्वसनीयता)।
हार्डवेयर के स्तर पर, ट्रेनिंग क्लस्टर SXM फ़ॉर्म फ़ैक्टर की 8-कार्ड मशीनों और IB नेटवर्किंग को प्राथमिकता देते हैं; इन्फरेंस के लिए विकल्प कहीं अधिक विस्तृत हैं — सिंगल-कार्ड RTX PRO 6000 वर्कस्टेशन, 2U/4U मल्टी-कार्ड सर्वर, यहाँ तक कि एज पर छोटे इन्फरेंस नोड भी। 2026 की वास्तविकता यह है कि उद्यमों के AI बजट का अधिकांश हिस्सा इन्फरेंस पर खर्च होता है, इसलिए सर्वर चयन भी «इन्फरेंस पहले, ट्रेनिंग आवश्यकतानुसार» के सिद्धांत पर होना चाहिए।
AI सर्वर चुनते समय VRAM कंप्यूट पावर से अधिक महत्वपूर्ण क्यों है?
संक्षिप्त उत्तर: मॉडल VRAM में नहीं समाता तो सबसे अधिक TFLOPS भी शून्य के बराबर है। कोई मॉडल चल सकता है या नहीं, यह इस पर निर्भर करता है कि वेट्स + KV Cache + कॉन्टेक्स्ट लंबाई कितनी VRAM घेरती है; मॉडल समा जाने के बाद ही बैंडविड्थ, FP4/FP8 समर्थन और कीमत की तुलना सार्थक बनती है।
अनुभवजन्य नियम (2026): FP16 परिशुद्धता पर 70B मॉडल को लगभग 140GB VRAM चाहिए — एक H200 (141GB) ठीक-ठीक समा देती है, वरना दो H100 चाहिए; FP8 क्वांटाइज़ेशन आवश्यकता आधी कर देता है; FP4 फिर आधा, लेकिन FP4 का मूल समर्थन केवल Blackwell आर्किटेक्चर (B200/B300/RTX PRO 6000) करता है। कॉन्टेक्स्ट विंडो दोगुनी होने पर KV Cache का उपयोग लगभग रैखिक रूप से बढ़ता है — इसीलिए «समा जाना» और «अच्छी सेवा» के बीच बैंडविड्थ खड़ी है: H200 की गति 4.8 TB/s और B200/B300 की 8 TB/s है।
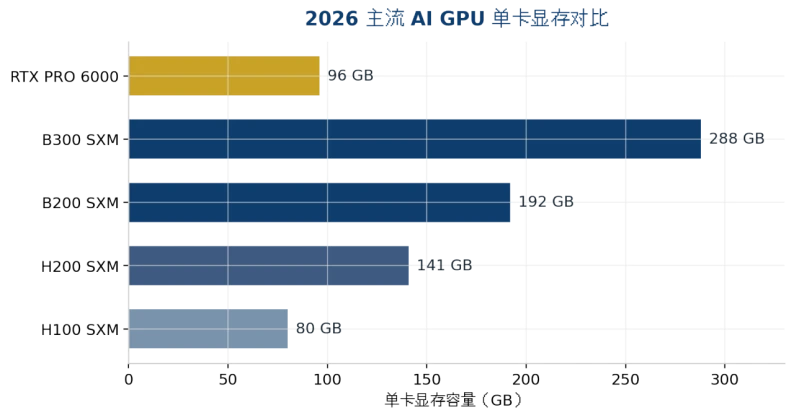
चित्र 1: 2026 के प्रमुख AI GPUs की एकल कार्ड VRAM तुलना (डेटा स्रोत परिशिष्ट में)
2026 के प्रमुख GPUs में से कैसे चुनें: H200 बनाम B200 बनाम B300 बनाम RTX PRO 6000
संक्षिप्त उत्तर: 141GB तक के मॉडलों के लिए H200 सर्वोत्तम मूल्य-प्रदर्शन देती है; FP4 या अधिक VRAM चाहिए तो B200 चुनें; एक कार्ड में 200GB से बड़ा मॉडल समाना हो या KV Cache दबाव अधिक हो तो B300; मध्य-स्तरीय इन्फरेंस और PCIe वातावरण के लिए RTX PRO 6000 चुनें।
आयाम | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
आर्किटेक्चर | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
मेमोरी बैंडविड्थ | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
FP4 कंप्यूट | समर्थित नहीं | 9 PFLOPS | 15 PFLOPS | समर्थित (सिंगल-कार्ड श्रेणी) |
TDP / कूलिंग | 700W / हवा संभव | 1000W / लिक्विड अनुशंसित | ~1400W / लिक्विड व्यावहारिक रूप से आवश्यक | 600W / हवा |
सामान्य पोज़िशनिंग | 70B–100B इन्फरेंस, फ़ाइन-ट्यूनिंग | 100B+ इन्फरेंस, ट्रेनिंग | एक नोड पर फ्रंटियर LLMs | मध्य इन्फरेंस, वर्कस्टेशन/एज |
2026 क्लाउड किराया संदर्भ | ~$4.4/GPU·घंटा | ~$5–7/GPU·घंटा | ~$7.4–8.3/GPU·घंटा | अधिकतर संपूर्ण मशीन खरीद |
तालिका 1: 2026 के प्रमुख AI GPUs की प्रमुख विशिष्टताएँ और पोज़िशनिंग (कीमतें अगस्त 2026 के बाज़ार संदर्भ मान हैं, अत्यधिक अस्थिर — खरीद से पहले नया कोटेशन लें)
दो रुझान ऐसे भी हैं जो आसानी से छूट जाते हैं: पहला, अगस्त 2025 से H200 का क्लाउड किराया औसतन लगभग 25% बढ़ चुका है, Hopper और Blackwell का मूल्य अंतर सिकुड़ रहा है और «पुरानी पीढ़ी से बचत» की खिड़की बंद हो रही है; दूसरा, RTX PRO 6000 का 400W वाला Server संस्करण आ गया है जिससे उसी पावर बजट में अधिक कार्ड लगाए जा सकते हैं — प्रति टोकन बिलिंग करने वाले इन्फरेंस प्रदाताओं के लिए अधिक अनुकूल।
मॉडल जितना बड़ा, मशीन उतनी ही बड़ी?
संक्षिप्त उत्तर: VRAM की न्यूनतम सीमा «मॉडल वेट्स × 1.2 (KV Cache के लिए मार्जिन)» से आँकें, फिर नीचे दी गई तालिका से GPU संख्या तय करें; एक नोड से आगे निकलने वाले मॉडल मल्टी-मशीन समानांतर में जाते हैं, जहाँ नेटवर्क GPU से अधिक महत्वपूर्ण हो जाता है।
लक्ष्य मॉडल (2026) | वेट्स का आकार | न्यूनतम कॉन्फ़िगरेशन | अनुशंसित मशीन रूप |
7B–14B (Qwen/Phi श्रेणी) | 15–30GB (FP16) | RTX PRO 6000 ×1 या 48GB वर्कस्टेशन कार्ड | टावर/2U एज इन्फरेंस सर्वर |
32B–70B (FP8 क्वांटाइज़ेशन) | 40–80GB | RTX PRO 6000 ×1–2 या H200 ×1 | 2U/4U GPU सर्वर |
70B FP16 / लंबा कॉन्टेक्स्ट | ~140GB+ | H200 ×1 (कसकर) या ×2 (सुरक्षित) | 4U मल्टी-कार्ड सर्वर |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (लगभग 130GB मार्जिन) | 4U लिक्विड-कूल्ड सर्वर |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 या B300 ×4 | 8-कार्ड SXM मशीन |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (कुल 2.3TB VRAM) | 8-कार्ड लिक्विड-कूल्ड फ़्लैगशिप मशीन |
तालिका 2: मॉडल आकार और सर्वर कॉन्फ़िगरेशन का मिलान (वेट्स आधिकारिक checkpoint के अनुसार; वास्तविक तैनाती में KV Cache और रनटाइम ओवरहेड जोड़ें)
यह तालिका यह भी समझाती है कि 4U चेसिस AI सर्वरों की «स्वीट स्पॉट» क्यों है: 8 ड्युअल-विड्थ GPUs, रिडंडंट पावर सप्लाई और पर्याप्त कूलिंग एयरफ़्लो — यह सब एक साथ केवल 4U की जगह में ही समा सकता है। 2U दो से चार कार्ड वाले इन्फरेंस नोड के लिए उपयुक्त है, जबकि 1U में केवल एक कार्ड समाती है या यह फ्रंट-एंड शेड्यूलिंग/स्टोरेज नोड के काम आता है।
एयर कूलिंग या लिक्विड कूलिंग? थर्मल और रैक विशिष्टताएँ कैसे तय करें?
संक्षिप्त उत्तर: प्रति कार्ड 700W से कम पर एयर कूलिंग पर्याप्त है; प्रति कार्ड 1000W से अधिक — या प्रति रैक 20kW से ज़्यादा — पर लिक्विड कूलिंग «अतिरिक्त सुविधा» से «कठोर आवश्यकता» बन जाती है। B300 का लगभग 1400W TDP व्यावहारिक रूप से लिक्विड कूलिंग ही तय कर देता है।
चयन का सही क्रम यह है: पहले मॉडल और GPU तय करें, फिर पूरी मशीन की पावर, और अंत में कूलिंग और मशीन रूम की स्थितियों का उल्टा हिसाब लगाएँ। कई कंपनियाँ उल्टा करती हैं — पहले मशीनें खरीद लेती हैं, फिर पता चलता है कि बिजली आपूर्ति और एयर कंडीशनिंग नहीं झेल पाएँगी, और मजबूरन घटी हुई आवृत्ति पर चलाना पड़ता है; मानो पूरी कीमत देकर «दुर्बल» GPU खरीद ली। खरीद से पहले तीन बातें अवश्य पुष्ट करें: रैक पावर सप्लाई (kW), इनलेट हवा का तापमान और मात्रा, और आगामी 2–3 GPU पीढ़ियों के लिए अपग्रेड गुंजाइश (B300 के बाद TDP और बढ़ेगा ही)।
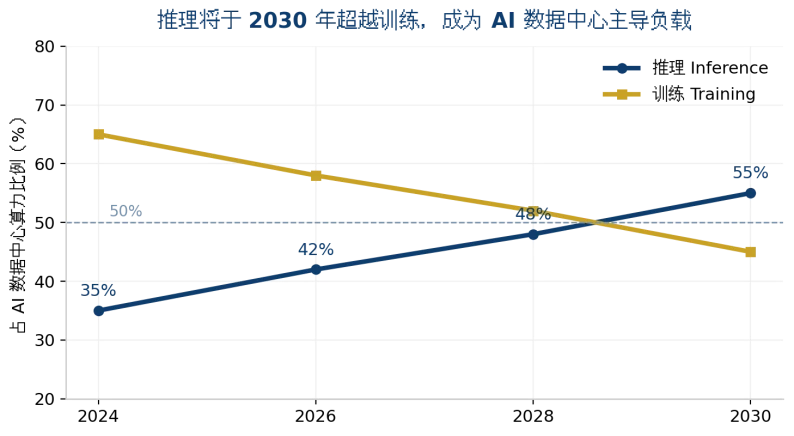
चित्र 2: 2030 तक इन्फरेंस ट्रेनिंग से आगे निकलकर AI डेटा सेंटरों का प्रमुख वर्कलोड बन जाएगा (रुझान आरेख; डेटा स्रोत परिशिष्ट में)
क्लाउड किराया या स्वयं निर्माण? लागत का हिसाब कैसे?
संक्षिप्त उत्तर: उपयोग 60% से कम हो तो क्लाउड किराया, दीर्घकालिक उच्च लोड पर स्वयं निर्माण। अगस्त 2026 के भाव के अनुसार H200 का क्लाउड किराया लगभग 4.4 प्रति GPU·घंटा है — एक कार्ड का पूरे साल पूर्ण लोड का किराया लगभग38 हज़ार, जो एक कार्ड खरीदने की लागत के करीब है। उपयोग जितना अधिक, स्वयं निर्माण उतनी जल्दी लागत निकाल लेता है।
स्वयं निर्माण के हिसाब में तीन चीज़ें और जोड़नी होंगी: मशीन रूम की बिजली और कूलिंग संचालन (कुल स्वामित्व लागत का लगभग 20–30%), GPU पीढ़ियों का अवमूल्यन (2026 में H100 गहराई से सस्ती हो चुकी है — अवशेष मूल्य का जोखिम वास्तविक है), और डेटा अनुपालन — वित्त, चिकित्सा और सरकारी ग्राहकों का डेटा आंतरिक नेटवर्क से बाहर नहीं जा सकता, इसलिए निजी तैनाती विकल्प नहीं बल्कि अनिवार्यता है। हाइब्रिड आर्किटेक्चर मुख्यधारा बन रही है: चरम ट्रेनिंग क्लाउड पर, स्थायी इन्फरेंस स्थानीय।
ChangFan: इन्फरेंस युग के लिए तैयार GPU सर्वर और AI हार्डवेयर
अंततः AI सर्वर का चयन स्पेसिफिकेशन तालिकाओं पर नहीं, बल्कि «कॉन्फ़िगरेशन और परिदृश्य के मिलान» पर जीता जाता है। Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) 1U/2U/4U फ़ॉर्म फ़ैक्टर में रैक-माउंट GPU सर्वर और AI इन्फरेंस मशीनें प्रदान करती है, मल्टी-कार्ड विस्तार, रिडंडंट पावर और वाइड-टेम्परेचर डिज़ाइन के साथ। लक्ष्य मॉडल के आकार के अनुसार GPU संख्या, VRAM कॉन्फ़िगरेशन और एयर/लिक्विड कूलिंग अनुकूलित की जा सकती है — निजी LLM तैनाती, एज इन्फरेंस नोड और एंटरप्राइज़ नॉलेज बेस के लिए स्थिर और विश्वसनीय हार्डवेयर आधार।
यदि आप H200/B200/B300 या RTX PRO 6000 श्रेणी के GPU सर्वरों की खरीद और तैनाती का मूल्यांकन कर रहे हैं, तो लक्ष्य मॉडल के अनुरूप कॉन्फ़िगरेशन सलाह और संपूर्ण मशीन प्रस्तावों के लिए ChangFan से संपर्क करें (हम हार्डवेयर बेचते हैं और संपूर्ण मशीनें बनाते हैं — सॉफ़्टवेयर सब्सक्रिप्शन सेवाएँ प्रदान नहीं करते)।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
प्र1: 70B बड़ा मॉडल चलाने के लिए न्यूनतम कॉन्फ़िगरेशन क्या चाहिए? उ: FP16 पर लगभग 140GB VRAM चाहिए, इसलिए एक H200 सबसे किफ़ायती उत्तर है; FP8 क्वांटाइज़ेशन के बाद दो RTX PRO 6000 (96GB×2) भी काम चला सकती हैं, कम लागत और अधिक लचीली तैनाती के साथ।
प्र2: B300 किस मामले में B200 से बेहतर है और क्या इंतज़ार करना चाहिए? उ: B300 में 50% अधिक VRAM है (288GB बनाम 192GB) और FP4 कंप्यूट 1.5 गुना अधिक, लेकिन बैंडविड्थ समान है और TDP बढ़कर लगभग 1400W हो गया है जिसे लिक्विड कूलिंग चाहिए। अपग्रेड तभी सार्थक है जब मॉडल या KV Cache B200 नोड की क्षमता से बाहर निकल जाए।
प्र3: छोटी-मध्यम कंपनी पहला AI सर्वर खरीदते समय किससे शुरुआत करे? उ: पहले तय करें कि कौन सा मॉडल चलाना है। 7B–14B स्तर के एप्लिकेशन (कस्टमर सर्विस, नॉलेज बेस, क्वालिटी इंस्पेक्शन) के लिए शुरुआत में एक 2U सिंगल-कार्ड इन्फरेंस सर्वर काफ़ी है; स्थायी उच्च लोड पक्का होने पर 4U मल्टी-कार्ड तक बढ़ाएँ।
प्र4: क्या AI सर्वर के लिए लिक्विड कूलिंग अनिवार्य है? उ: नहीं। प्रति कार्ड 700W से कम और मशीन रूम की अच्छी स्थिति में हवा काफ़ी है; लिक्विड केवल प्रति कार्ड 1000W से अधिक या उच्च-घनत्व बहु-रैक तैनाती में आवश्यक है। चयन के समय आगामी 2–3 GPU पीढ़ियों के बिजली रुझान के लिए मार्जिन रखें।
प्र5: क्लाउड GPU इतनी सस्ती है तो अपना सर्वर क्यों खरीदें? उ: तीन कारण — लगभग 60% से अधिक उपयोग पर स्वयं निर्माण सस्ता पड़ता है; संवेदनशील डेटा आंतरिक नेटवर्क से बाहर नहीं जा सकता; स्थानीय इन्फरेंस में नेटवर्क विलंबता नहीं और SLA आपके नियंत्रण में। अधिकांश उद्यम अंततः «ट्रेनिंग क्लाउड पर, इन्फरेंस स्थानीय» वाले हाइब्रिड मॉडल पर आ जाते हैं।