Paano Pumili ng AI Server? Kumpletong Gabay sa Konpigurasyon ng Hardware para sa Training at Inference 2026
Panimula: Bakit Naging Kinakailangang Aralin ng 2026 ang Pagpili ng AI Server
Ang istruktura ng paggasta sa AI compute ay nagbabago nang pangsaligan. Ayon sa pagsusuring inilabas ng McKinsey noong Pebrero 2026, pagsapit ng 2030, malalampasan ng inference ang training bilang nangungunang workload ng AI data center — mahigit kalahati ng lahat ng AI compute at humigit-kumulang 30%–40% ng kabuuang pangangailangan ng data center. Ibig sabihin, ang lohika ng pagbili ng server ng mga negosyo ay lumilipat mula sa "pagsasansalansan ng card para sa training" patungo sa "masinop na pagpapatakbo ng inference" — kapag mali ang konpigurasyon, ang kapalit ay hindi isang beses lang na pagkamahal, kundi araw-araw na bayad sa kuryente at upa para sa maling arkitektura sa loob ng tatlong taon.
Kasabay nito, mabilis na humahagod ang iterasyon ng mga GPU: ang 141GB VRAM ng H200 ay hindi pa man lamang "umiinit", lumabas na ang B200 na 192GB at B300 na 288GB, habang ang RTX PRO 6000 na may 96GB VRAM at PCIe form ay humiwa ng bahagi ng mid-range inference market. Mas maraming modelo, mas mahirap pumili. Gumagamit ang artikulong ito ng isang decision axis at dalawang comparison table upang linawin ang pagpili ng AI server sa 2026.
Ano ba talaga ang pagkakaiba ng training server at inference server?
Mabilisang sagot: ang training ay isang beses na proyektong "compute-intensive", ang inference ay tuloy-tuloy na serbisyong "VRAM at bandwidth intensive". Ang training server ay humahangad ng peak compute ng multi-card interconnect (buong NVLink/NVSwitch interconnect, mataas na power density, liquid cooling); ang inference server ay humahangad ng matatag na throughput sa bawat yunit ng gastos (kasya ang modelo sa VRAM, kayang ilabas ng bandwidth ang mga token, kontrolado ang power ng isang card, maaasahan 7×24).
Sa hardware, inuuna ng training cluster ang 8-card SXM na buong makina at IB networking; ang inference deployment naman ay may mas malawak na opsyon — single-card RTX PRO 6000 workstation, 2U/4U multi-card server, maging maliliit na inference node sa edge. Ang realidad ng 2026: halos lahat ng AI budget ng mga negosyo ay napupunta sa inference, kaya ang pagpili ng server ay dapat ding "inference muna, training ayon sa pangangailangan".
Sa pagpili ng AI server, bakit mas mahalaga ang VRAM kaysa compute?
Mabilisang sagot: kapag hindi kasya ang modelo sa VRAM, kahit gaano kataas ang TFLOPS ay wala ring silbi. Ang kaya bang tumakbo ng isang modelo ay nakadepende sa kung gaano karaming VRAM ang kinakain ng weights + KV Cache + context length; kapag nakasya na, saka pa lang magkakaroon ng saysay ang paghahambing ng bandwidth, FP4/FP8 support, at presyo.
Rule of thumb (2026): sa FP16 precision, ang 70B model ay nangangailangan ng humigit-kumulang 140GB VRAM — eksaktong kasya ang isang H200 (141GB), kung hindi ay kailangan ng dalawang H100; pagkatapos ng FP8 quantization, kalahati ang pangangailangan; sa FP4 kalahati ulit, ngunit tanging ang Blackwell architecture (B200/B300/RTX PRO 6000) ang may native na FP4 support. Tuwing dumodoble ang context window, halos linear na lumalaki ang KV Cache usage — kaya sa pagitan ng "kasyang ilagay" at "magandang paglingkuran" ay may bandwidth na nakahigit: ang H200 ay 4.8 TB/s, ang B200/B300 ay 8 TB/s.
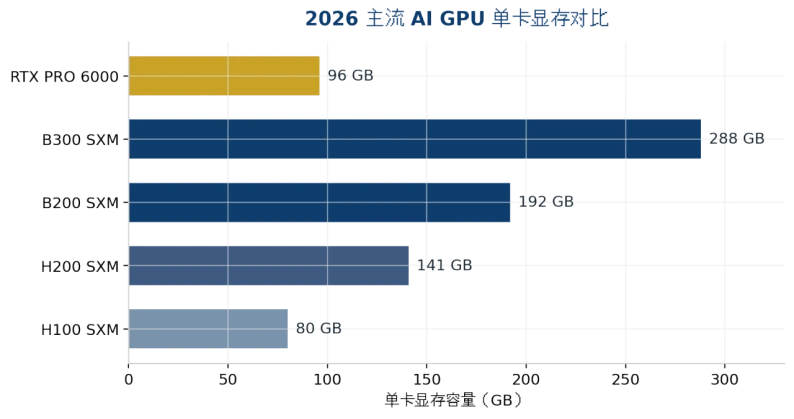
Larawan 1: Paghahambing ng VRAM bawat card ng mga pangunahing AI GPU ng 2026 (tingnan ang appendix para sa pinagmulan ng datos)
Paano pumili ng pangunahing GPU ng 2026: paghahambing ng H200, B200, B300, RTX PRO 6000
Mabilisang sagot: sa mga modelong nasa loob ng 141GB, ang H200 ang pinakasulit; kapag kailangan ng FP4 o mas malaking VRAM, B200; kapag ang isang card ay kailangang magkasa ng modelong higit 200GB o mabigat ang KV Cache, B300; sa mid-range inference at PCIe environment, RTX PRO 6000.
Dimensyon | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arkitektura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Memory bandwidth | 4.8 TB/s | 8 TB/s | 8 TB/s | Humigit-kumulang 1.8 TB/s |
FP4 compute | Hindi suportado | 9 PFLOPS | 15 PFLOPS | Suportado (single-card level) |
TDP / Cooling | 700W / kaya ang air cooling | 1000W / inirerekomenda ang liquid cooling | Humigit-kumulang 1400W / halos kailangan ng liquid cooling | 600W / air cooling |
Tipikal na positioning | 70B–100B inference, fine-tuning | 100B+ inference, training | Single-machine hosting ng frontier na malaking modelo | Mid-range inference, workstation/edge |
2026 cloud rental reference | Humigit-kumulang $4.4/GPU·oras | Humigit-kumulang $5–7/GPU·oras | Humigit-kumulang $7.4–8.3/GPU·oras | Pangunahing pagbili ng buong makina |
Talahanayan 1: Paghahambing ng mga pangunahing spec at positioning ng mga AI GPU ng 2026 (ang presyo ay sangguniang halaga ng merkado noong Agosto 2026, mabilis magbago, kailangang humingi muli ng quote bago bumili)
May dalawa pang trend na madaling makaligtaan: una, ang median cloud rental price ng H200 ay tumaas nang humigit-kumulang 25% mula Agosto 2025, lumiliit ang price gap ng Hopper at Blackwell, at nagsasara na ang bintana ng "bumili ng lumang modelo para makatipid"; ikalawa, naglabas ang RTX PRO 6000 ng 400W Server version — sa parehong power budget ay mas maraming card ang maikakabit, mas mabuti para sa mga inference service provider na singil bawat token.
Gaano kalaki ang modelo, gaano kalakas ang makina?
Mabilisang sagot: tantiyahin ang VRAM floor gamit ang "model weights × 1.2 (may reserba para sa KV Cache)", pagkatapos ay itapat sa talahanayan sa ibaba upang matukoy ang bilang ng GPU; ang mga modelong lampas sa isang node ay papasok sa multi-machine parallel, kung saan mas mahalaga ang network kaysa GPU.
Target na modelo (2026) | Laki ng weights | Minimum na konpigurasyon | Inirerekomendang anyo ng makina |
7B–14B (Qwen/Phi class) | 15–30GB (FP16) | RTX PRO 6000 ×1 o 48GB workstation card | Tower/2U edge inference server |
32B–70B (FP8 quantized) | 40–80GB | RTX PRO 6000 ×1–2 o H200 ×1 | 2U/4U GPU server |
70B FP16 / mahabang context | Humigit-kumulang 140GB+ | H200 ×1 (napipilitan) o ×2 (ligtas) | 4U multi-card server |
DeepSeek V4 Flash (156GB) | Humigit-kumulang 156GB | B300 ×1 (may labis na humigit-kumulang 130GB) | 4U liquid-cooled server |
GLM-5.2 FP8 (humigit-kumulang 756GB) | Humigit-kumulang 756GB | H200 ×8 o B300 ×4 | 8-card SXM na buong makina |
Kimi K3 (1.56TB MXFP4) | Humigit-kumulang 1.56TB | B300 ×8 (kabuuang 2.3TB VRAM) | 8-card liquid-cooled flagship na makina |
Talahanayan 2: Tapatang laki ng modelo at konpigurasyon ng server (ang weights ay ayon sa opisyal na checkpoint, ang aktuwal na deployment ay kailangang magdagdag ng KV Cache at runtime overhead)
Ipinapaliwanag din ng talahanayang ito kung bakit ang 4U chassis ang "sweet spot" ng AI server: 8 dual-width GPU, redundant power supply, at sapat na cooling airflow — tanging ang 4U space ang kayang magkasya ng lahat nang sabay-sabay. Ang 2U ay angkop sa 2–4 card inference node, ang 1U ay angkop lamang sa single card o bilang front-end scheduling/storage node.
Air cooling o liquid cooling? Paano itatakda ang cooling at rack specs?
Mabilisang sagot: sa single card na wala pang 700W, sapat ang air cooling; sa single card na lampas 1000W, o kapag ang isang rack ay lampas 20kW, ang liquid cooling ay nagiging "hard requirement" mula sa "dagdag na puntos". Ang TDP na humigit-kumulang 1400W ng B300 ay halos nakakandado na sa liquid cooling.
Ang tamang pagkakasunod-sunod ng pagpili: itakda muna ang modelo at GPU, pagkatapos ang kabuuang power ng makina, sa dulo pa lang kalkulahin pabalik ang cooling at kondisyon ng server room. Maraming negosyo ang gumagawa nang baliktad — bumibili muna ng makina, saka lamang natutuklasang hindi kaya ng power supply at aircon ng server room, napipilitang mag-downclock, na katumbas ng pagbili ng GPU na "kulang sa lakas". Bago bumili, tiyakin ang tatlong bagay: power supply ng rack (kW), temperatura at dami ng papasok na hangin, at upgrade space para sa susunod na 2–3 henerasyon ng GPU (pagkatapos ng B300, ang TDP ay lalo lang tataas).
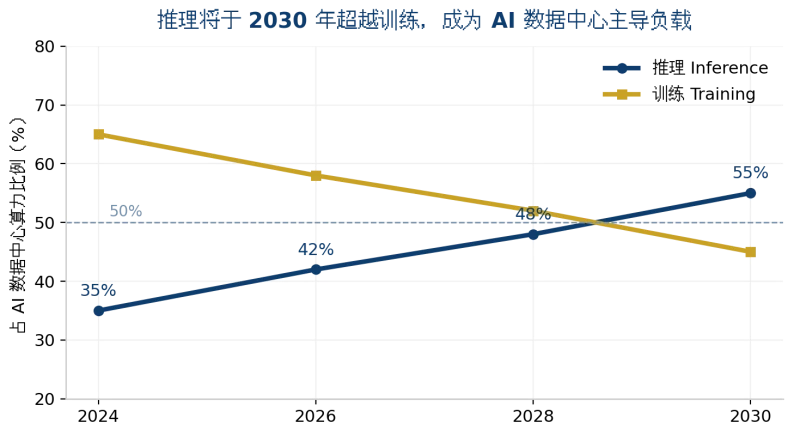
Larawan 2: Malalampasan ng inference ang training bilang nangungunang workload ng AI data center pagsapit ng 2030 (ilustrasyon ng trend, tingnan ang appendix para sa pinagmulan ng datos)
Cloud rental o self-built? Paano kalkulahin ang gastos?
Mabilisang sagot: kapag ang utilization ay wala pang 60%, cloud rental; kapag pangmatagalang mataas ang load, self-built. Sa presyo ng Agosto 2026, ang cloud rental ng H200 ay humigit-kumulang 4.4/GPU·oras, ang isang card na buong taong full load ay gagastos ng humigit-kumulang38,000 sa upa — halos katumbas ng pagbili ng sariling card; kapag tumataas ang utilization, bumabawi ang self-built.
Ang panig ng self-built ay kailangan pang idagdag ang tatlong bagay: kuryente at cooling maintenance ng server room (humigit-kumulang 20%–30% ng total cost of ownership), depreciation mula sa GPU iteration (sa 2026, ang H100 ay malalim na naka-diskwento, totoo ang residual value risk), at data compliance — ang datos ng mga kliyenteng pinansyal, medikal, at gobyerno ay hindi maaaring lumabas ng internal network, kaya ang private deployment ay hindi pagpipilian kundi obligasyon. Ang hybrid architecture ay nagiging mainstream: peak training sa cloud, resident inference sa lokal.
ChangFan Industrial Computing: Mga GPU Server at AI Hardware na Handa para sa Inference Era
Sa huli, ang pagpili ng AI server ay hindi paligsahan ng parameter table, kundi "ang pagkakatugma ng konpigurasyon sa senaryo". Ang Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan Industrial Computing / ChangFan) ay nagbibigay ng rackmount GPU server at AI inference machine na sumasaklaw sa 1U/2U/4U, may suporta sa multi-card expansion, redundant power supply, at wide-temperature design, at maaaring i-customize ang bilang ng GPU, VRAM configuration, at air/liquid cooling solution ayon sa target na laki ng modelo — naghahatid ng matatag at maaasahang hardware foundation para sa mga senaryo tulad ng private large-model deployment, edge inference node, at enterprise knowledge base.
Kung sinusuri ninyo ang pagbili at deployment ng H200/B200/B300 o RTX PRO 6000 class GPU server, malugod na makipag-ugnayan sa ChangFan Industrial Computing para sa configuration advice at whole-machine solution na angkop sa target model ninyo (nagbebenta kami ng hardware at gumagawa ng buong makina, hindi nagbibigay ng software subscription service).
Mga Madalas Itanong (FAQ)
T1: Ano ang minimum na konpigurasyon para magpatakbo ng 70B na malaking modelo? S: Sa FP16 kailangan ng humigit-kumulang 140GB VRAM, ang isang H200 ang pinaka-ekonomikong sagot; pagkatapos ng FP8 quantization, kaya rin ng dalawang RTX PRO 6000 (96GB×2), mas mababa ang gastos at mas flexible ang deployment.
T2: Saan mas malakas ang B300 kaysa B200, sulit bang hintayin? S: Ang B300 ay may 50% na mas maraming VRAM (288GB laban sa 192GB), 1.5 beses na mas mataas ang FP4 compute, ngunit pareho ang bandwidth at tumataas ang TDP sa humigit-kumulang 1400W kaya kailangan ng liquid cooling. Sulit lang i-upgrade kapag ang modelo o KV Cache ay lampas na sa kapasidad ng B200 node.
T3: Sa mga SME na unang beses bibili ng AI server, ano ang inirerekomendang panimula? S: Tukuyin muna ang modelong tatakbo. Ang mga aplikasyong 7B–14B (customer service, knowledge base, quality inspection) ay maaaring magsimula sa isang 2U single-card inference server; kapag nakumpirma na ang pangmatagalang mataas na load, saka palawakin sa 4U multi-card.
T4: Kailangan bang liquid cooling ang AI server? S: Hindi. Sa mga senaryong single card na wala pang 700W at maganda ang kondisyon ng server room, sapat ang air cooling; single card na lampas 1000W o high-density multi-rack deployment pa lang ang nangangailangan ng liquid cooling. Sa pagpili, magreserba ng margin ayon sa power trend ng susunod na 2–3 henerasyon ng GPU.
T5: Napakamura ng cloud GPU, bakit pa kailangang bumili ng sariling server? S: Tatlong dahilan — kapag ang utilization ay lampas humigit-kumulang 60%, mas mura ang self-built; ang sensitibong datos ay hindi pinapayagang lumabas ng internal network; ang local inference ay walang network latency at kontrolado ang sariling SLA. Karamihan ng negosyo ay sa huli ay gumagamit ng hybrid architecture na "training sa cloud, inference sa lokal".