Πώς να επιλέξετε διακομιστή AI; Ο πλήρης οδηγός διαμόρφωσης υλικού 2026 για εκπαίδευση και συμπερασμό
Εισαγωγή: γιατί η επιλογή διακομιστή AI έγινε υποχρεωτικό μάθημα το 2026
Η δομή των δαπανών για υπολογιστική ισχύ AI αλλάζει ριζικά. Σύμφωνα με ανάλυση της McKinsey που δημοσιεύτηκε τον Φεβρουάριο του 2026, έως το 2030 ο συμπερασμός (inference) θα ξεπεράσει την εκπαίδευση ως κυρίαρχος φόρτος στα κέντρα δεδομένων AI — με πάνω από το μισό του συνόλου της υπολογιστικής AI και περίπου 30–40% της συνολικής ζήτησης των κέντρων δεδομένων. Για τις επιχειρήσεις, η λογική αγοράς διακομιστών μετατοπίζεται από το «στοίβαγμα καρτών για εκπαίδευση» στο «τρέξιμο συμπερασμού με οικονομία» — το λάθος στη διαμόρφωση δεν κοστίζει μια εφάπαξ υπερπληρωμή, αλλά τρία χρόνια καθημερινών λογαριασμών ρεύματος και ενοικίου για τη λάθος αρχιτεκτονική.
Παράλληλα, ο ρυθμός εξέλιξης των GPU έχει επιταχυνθεί εμφανώς: η VRAM 141GB της H200 δεν πρόλαβε να «εγκατασταθεί» και ήδη αναπτύσσονται τα 192GB της B200 και τα 288GB της B300, ενώ η RTX PRO 6000 με 96GB και μορφή PCIe κερδίζει την αγορά συμπερασμού μεσαίας κατηγορίας. Όσο περισσότερα τα μοντέλα, τόσο δυσκολότερη η επιλογή. Το άρθρο αυτό ξεκαθαρίζει την επιλογή διακομιστή AI το 2026 με έναν άξονα απόφασης και δύο συγκριτικούς πίνακες.
Ποια είναι ακριβώς η διαφορά μεταξύ διακομιστή εκπαίδευσης και διακομιστή συμπερασμού;
Σύντομη απάντηση: η εκπαίδευση είναι ένα εφάπαξ «υπολογιστικά εντατικό» μεγα-έργο, ο συμπερασμός μια συνεχής υπηρεσία «εντατική σε VRAM και εύρος ζώνης». Ο διακομιστής εκπαίδευσης επιδιώκει κορυφαία απόδοση διασύνδεσης πολλών GPU (πλήρες NVLink/NVSwitch fabric, υψηλή πυκνότητα ισχύος, υγρή ψύξη), ο διακομιστής συμπερασμού επιδιώκει σταθερή απόδοση ανά μονάδα κόστους (VRAM που χωρά το μοντέλο, εύρος ζώνης που παράγει tokens, ελεγχόμενη κατανάλωση ανά κάρτα, αξιοπιστία 7×24).
Σε επίπεδο υλικού, τα clusters εκπαίδευσης προτιμούν μηχανές 8 GPU σε μορφή SXM με δίκτυο InfiniBand· ο συμπερασμός έχει πολύ ευρύτερες επιλογές — σταθμούς εργασίας μονής GPU RTX PRO 6000, διακομιστές πολλών GPU 2U/4U, ακόμη και μικρούς κόμβους συμπερασμού στην άκρη δικτύου. Η πραγματικότητα του 2026: η συντριπτική πλειονότητα των εταιρικών προϋπολογισμών AI πηγαίνει στον συμπερασμό, επομένως η επιλογή διακομιστών πρέπει να ακολουθεί την αρχή «πρώτα ο συμπερασμός, η εκπαίδευση κατ' απαίτηση».
Γιατί η VRAM μετρά περισσότερο από την υπολογιστική ισχύ στην επιλογή διακομιστή AI;
Σύντομη απάντηση: αν το μοντέλο δεν χωρά στη VRAM, ακόμη και τα υψηλότερα TFLOPS ισούνται με μηδέν. Το αν μπορεί να τρέξει ένα μοντέλο εξαρτάται από το πόση VRAM καταλαμβάνουν τα βάρη + το KV Cache + το μήκος πλαισίου· μόνο αφού χωρέσει αποκτούν νόημα οι συγκρίσεις εύρους ζώνης, υποστήριξης FP4/FP8 και τιμής.
Εμπειρικός κανόνας (2026): σε ακρίβεια FP16, ένα μοντέλο 70B χρειάζεται περίπου 140GB VRAM — μία μόνο H200 (141GB) το χωρά ακριβώς, διαφορετικά χρειάζονται δύο H100· η κβάντωση FP8 υποδιπλασιάζει την απαίτηση· η FP4 την υποδιπλασιάζει ξανά, αλλά μόνο η αρχιτεκτονική Blackwell (B200/B300/RTX PRO 6000) υποστηρίζει FP4 εγγενώς. Κάθε διπλασιασμός του παραθύρου πλαισίου αυξάνει τη χρήση KV Cache σχεδόν γραμμικά — γι' αυτό ανάμεσα στο «χωρά» και στο «εξυπηρετεί καλά» στέκεται το εύρος ζώνης: η H200 προσφέρει 4,8 TB/s, οι B200/B300 προσφέρουν 8 TB/s.
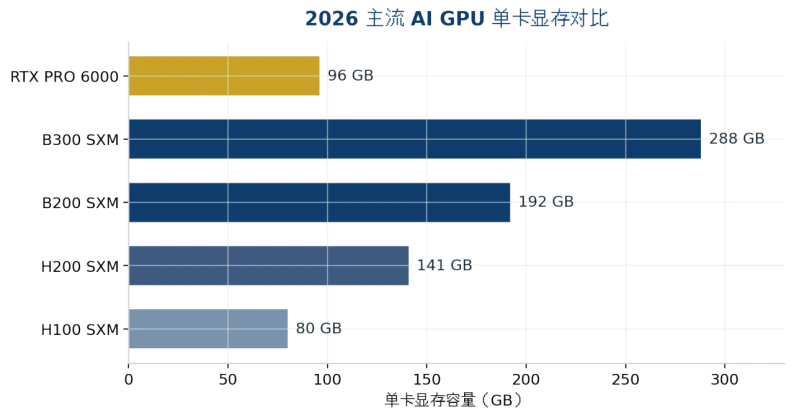
Σχήμα 1: Σύγκριση VRAM ανά κάρτα των κορυφαίων GPU AI το 2026 (πηγές δεδομένων στο παράρτημα)
Πώς να επιλέξετε ανάμεσα στις GPU του 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Σύντομη απάντηση: για μοντέλα έως 141GB, η H200 προσφέρει την καλύτερη σχέση τιμής-απόδοσης· επιλέξτε B200 όταν χρειάζεστε FP4 ή περισσότερη VRAM· επιλέξτε B300 όταν μία κάρτα πρέπει να χωρέσει μοντέλο άνω των 200GB ή η πίεση KV Cache είναι υψηλή· επιλέξτε RTX PRO 6000 για συμπερασμό μεσαίας κατηγορίας και περιβάλλοντα PCIe.
Διάσταση | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Αρχιτεκτονική | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Εύρος ζώνης μνήμης | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Ισχύς FP4 | Δεν υποστηρίζεται | 9 PFLOPS | 15 PFLOPS | Υποστηρίζεται (κλάση μονής κάρτας) |
TDP / ψύξη | 700W / αέρας εφικτός | 1000W / υγρή ψύξη συνιστώμενη | ~1400W / υγρή ψύξη ουσιαστικά απαραίτητη | 600W / αέρας |
Τυπική τοποθέτηση | Συμπερασμός 70B–100B, fine-tuning | Συμπερασμός 100B+, εκπαίδευση | LLM αιχμής σε έναν κόμβο | Συμπερασμός μεσαίας κλάσης, σταθμός/άκρη |
Αναφορά ενοικίασης cloud 2026 | ~$4.4/GPU·ώρα | ~$5–7/GPU·ώρα | ~$7.4–8.3/GPU·ώρα | Κυρίως αγορά ολοκληρωμένων συστημάτων |
Πίνακας 1: Βασικές προδιαγραφές και τοποθέτηση των κορυφαίων GPU AI το 2026 (οι τιμές είναι τιμές αναφοράς αγοράς Αυγούστου 2026, πολύ ευμετάβλητες — ζητήστε νέα προσφορά πριν την αγορά)
Υπάρχουν επίσης δύο τάσεις που ξεφεύγουν εύκολα: πρώτον, η διάμεση τιμή ενοικίασης cloud της H200 έχει αυξηθεί περίπου 25% από τον Αύγουστο του 2025, η τιμολογιακή απόσταση Hopper–Blackwell στενεύει και το παράθυρο «εξοικονόμησης με την παλιά γενιά» κλείνει· δεύτερον, η RTX PRO 6000 διατίθεται πλέον και σε έκδοση Server 400W, που επιτρέπει περισσότερες κάρτες στο ίδιο ενεργειακό μπάτζετ — πιο φιλική για παρόχους συμπερασμού με χρέωση ανά token.
Όσο μεγάλο το μοντέλο, τόση μηχανή χρειάζεται;
Σύντομη απάντηση: υπολογίστε το κατώτατο όριο VRAM ως «βάρη μοντέλου × 1,2 (περιθώριο για KV Cache)» και στη συνέχεια καθορίστε τον αριθμό GPU από τον παρακάτω πίνακα· τα μοντέλα που ξεπερνούν έναν κόμβο περνούν σε παραλληλισμό πολλών μηχανών, όπου το δίκτυο μετρά περισσότερο από τις GPU.
Μοντέλο-στόχος (2026) | Μέγεθος βαρών | Ελάχιστη διαμόρφωση | Προτεινόμενη μορφή |
7B–14B (κλάση Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 ή κάρτα σταθμού 48GB | Διακομιστής συμπερασμού άκρης tower/2U |
32B–70B (κβάντωση FP8) | 40–80GB | RTX PRO 6000 ×1–2 ή H200 ×1 | Διακομιστής GPU 2U/4U |
70B FP16 / μακρύ πλαίσιο | ~140GB+ | H200 ×1 (οριακά) ή ×2 (με σιγουριά) | Διακομιστής πολλών GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (περιθώριο ~130GB) | Διακομιστής 4U με υγρή ψύξη |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 ή B300 ×4 | Σύστημα SXM 8 GPU |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB συνολική VRAM) | Κορυφαίο σύστημα 8 GPU με υγρή ψύξη |
Πίνακας 2: Μέγεθος μοντέλου έναντι διαμόρφωσης διακομιστή (βάρη σύμφωνα με επίσημα checkpoints· στην πραγματική ανάπτυξη προσθέστε KV Cache και επιβάρυνση runtime)
Ο πίνακας αυτός εξηγεί επίσης γιατί το σασί 4U είναι το «sweet spot» των διακομιστών AI: 8 GPU διπλού πλάτους, εφεδρικά τροφοδοτικά και επαρκείς αεραγωγοί ψύξης — μόνο ο χώρος των 4U τα χωρά όλα μαζί. Το 2U ταιριάζει σε κόμβους συμπερασμού 2–4 καρτών· το 1U χωρά μόνο μία κάρτα ή λειτουργεί ως εμπρόσθιος κόμβος χρονοπρογραμματισμού/αποθήκευσης.
Αέρας ή υγρή ψύξη; Πώς καθορίζονται οι θερμικές και οι προδιαγραφές rack;
Σύντομη απάντηση: κάτω από 700W ανά κάρτα αρκεί η αερόψυξη· πάνω από 1000W ανά κάρτα — ή πάνω από 20kW ανά rack — η υγρή ψύξη μετατρέπεται από «πλεονέκτημα» σε «σκληρή απαίτηση». Το TDP ~1400W της B300 ουσιαστικά επιβάλλει υγρή ψύξη.
Η σωστή σειρά επιλογής είναι: πρώτα το μοντέλο και η GPU, μετά η συνολική ισχύς της μηχανής και μόνο τότε ο ανάστροφος υπολογισμός ψύξης και συνθηκών αίθουσας. Πολλές εταιρείες κάνουν το αντίστροφο — αγοράζουν πρώτα τις μηχανές και μετά ανακαλύπτουν ότι η ηλεκτροδότηση και ο κλιματισμός δεν επαρκούν, αναγκαζόμενες σε υποχρονισμό: σαν να πλήρωσαν πλήρη τιμή για μια «ακρωτηριασμένη» GPU. Πριν την αγορά επιβεβαιώστε τρία πράγματα: ηλεκτροδότηση rack (kW), θερμοκρασία και παροχή εισερχόμενου αέρα, και περιθώριο για τις επόμενες 2–3 γενιές GPU (μετά την B300 τα TDP θα ανεβαίνουν).
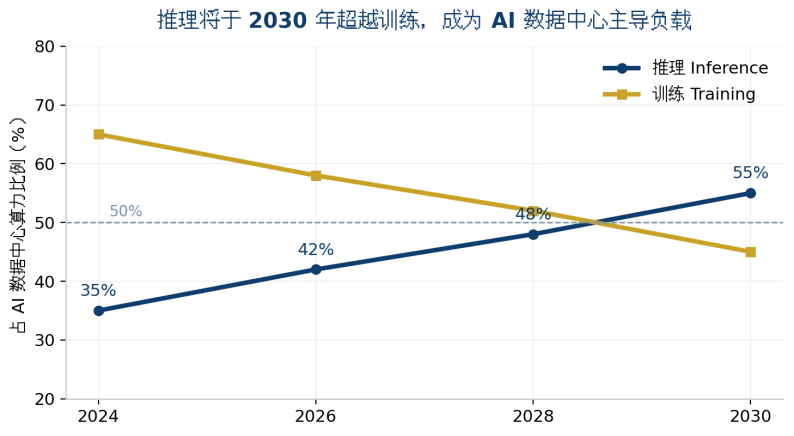
Σχήμα 2: Ο συμπερασμός θα ξεπεράσει την εκπαίδευση ως κυρίαρχος φόρτος των κέντρων δεδομένων AI έως το 2030 (απεικόνιση τάσης· πηγές δεδομένων στο παράρτημα)
Ενοικίαση cloud ή ιδιωτική υποδομή; Πώς υπολογίζονται τα κόστη;
Σύντομη απάντηση: με αξιοποίηση κάτω από 60% συμφέρει η ενοικίαση cloud· με διαρκώς υψηλό φόρτο συμφέρει η ιδιωτική υποδομή. Με τις τιμές του Αυγούστου 2026, η ενοικίαση cloud μιας H200 κοστίζει περίπου 4,4/GPU·ώρα — περίπου38 χιλιάδες για έναν ολόκληρο χρόνο πλήρους φόρτου, κοντά στο κόστος αγοράς μιας κάρτας. Όσο μεγαλύτερη η αξιοποίηση, τόσο γρηγορότερα αποσβένεται η ιδιωτική υποδομή.
Στον λογαριασμό της ιδιωτικής υποδομής προστίθενται τρεις ακόμη κατηγορίες: ηλεκτρισμός και λειτουργία ψύξης (περίπου 20–30% του συνολικού κόστους κτήσης), απόσβεση λόγω γενεών GPU (η H100 το 2026 έχει ήδη βαθιά υποτιμηθεί — ο κίνδυνος υπολειμματικής αξίας είναι πραγματικός) και συμμόρφωση δεδομένων: για πελάτες χρηματοοικονομικών, υγείας και δημοσίου, τα δεδομένα δεν βγαίνουν από το intranet, επομένως η ιδιωτική ανάπτυξη δεν είναι επιλογή αλλά υποχρέωση. Η υβριδική αρχιτεκτονική γίνεται κυρίαρχη: αιχμή εκπαίδευσης στο cloud, μόνιμος συμπερασμός τοπικά.
ChangFan: διακομιστές GPU και υλικό AI έτοιμα για την εποχή του συμπερασμού
Τελικά, η επιλογή διακομιστή AI δεν κρίνεται στα φύλλα προδιαγραφών αλλά στην αντιστοίχιση διαμόρφωσης και σεναρίου. Η Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) προσφέρει rack διακομιστές GPU και συστήματα συμπερασμού AI σε μορφές 1U/2U/4U, με επέκταση πολλών GPU, εφεδρικά τροφοδοτικά και σχεδιασμό ευρέως εύρους θερμοκρασίας. Ο αριθμός GPU, η διαμόρφωση VRAM και η ψύξη (αέρας/υγρό) προσαρμόζονται στο μέγεθος του μοντέλου-στόχου — μια σταθερή και αξιόπιστη βάση υλικού για ιδιωτική ανάπτυξη LLM, κόμβους συμπερασμού στην άκρη και εταιρικές βάσεις γνώσης.
Εάν αξιολογείτε την αγορά και ανάπτυξη διακομιστών GPU κλάσης H200/B200/B300 ή RTX PRO 6000, επικοινωνήστε με τη ChangFan για συμβουλές διαμόρφωσης και προτάσεις ολοκληρωμένων συστημάτων προσαρμοσμένες στο μοντέλο-στόχο σας (πουλάμε υλικό και κατασκευάζουμε ολοκληρωμένα συστήματα — δεν προσφέρουμε υπηρεσίες συνδρομής λογισμικού).
Συχνές ερωτήσεις (FAQ)
Ε1: Ποια είναι η ελάχιστη διαμόρφωση για να τρέξει ένα LLM 70B; Α: Σε FP16 χρειάζεστε περίπου 140GB VRAM, οπότε μία μόνο H200 είναι η πιο οικονομική απάντηση· μετά την κβάντωση FP8, δύο κάρτες RTX PRO 6000 (96GB×2) καλύπτουν επίσης την ανάγκη, με χαμηλότερο κόστος και μεγαλύτερη ευελιξία ανάπτυξης.
Ε2: Με τι είναι καλύτερη η B300 από τη B200 και αξίζει η αναμονή; Α: Η B300 προσφέρει 50% περισσότερη VRAM (288GB έναντι 192GB) και 1,5× την ισχύ FP4, αλλά ίδιο εύρος ζώνης και TDP αυξημένο σε ~1400W που απαιτεί υγρή ψύξη. Η αναβάθμιση αξίζει μόνο όταν το μοντέλο ή το KV Cache ξεπερνά τη χωρητικότητα κόμβου με B200.
Ε3: Με τι να ξεκινήσει μια ΜΜΕ που αγοράζει τον πρώτο της διακομιστή AI; Α: Ορίστε πρώτα το μοντέλο που θα τρέχει. Για εφαρμογές 7B–14B (εξυπηρέτηση πελατών, βάση γνώσης, έλεγχος ποιότητας), ένας διακομιστής συμπερασμού 2U με μία κάρτα αρκεί για εκκίνηση· επεκτείνετε σε 4U πολλών GPU όταν επιβεβαιωθεί διαρκώς υψηλός φόρτος.
Ε4: Είναι υποχρεωτική η υγρή ψύξη για διακομιστές AI; Α: Όχι. Κάτω από 700W ανά κάρτα και με καλές συνθήκες αίθουσας αρκεί ο αέρας· υγρή ψύξη χρειάζεται μόνο πάνω από 1000W ανά κάρτα ή σε πυκνές εγκαταστάσεις πολλών rack. Κατά την επιλογή, αφήστε περιθώριο για την τάση κατανάλωσης των επόμενων 2–3 γενεών GPU.
Ε5: Οι GPU στο cloud είναι τόσο φθηνές — γιατί να αγοράσω δικό μου διακομιστή; Α: Τρεις λόγοι — πάνω από ~60% αξιοποίηση, η ιδιωτική υποδομή κοστίζει λιγότερο· τα ευαίσθητα δεδομένα δεν μπορούν να βγουν από το intranet· ο τοπικός συμπερασμός δεν έχει καθυστέρηση δικτύου και το SLA είναι υπό δικό σας έλεγχο. Οι περισσότερες επιχειρήσεις καταλήγουν σε υβριδική αρχιτεκτονική «εκπαίδευση στο cloud, συμπερασμός τοπικά».