Como escolher um servidor de IA? O guia completo 2026 de configuração de hardware para treinamento e inferência
Introdução: por que a escolha do servidor de IA virou disciplina obrigatória em 2026
A estrutura dos gastos com computação de IA está mudando radicalmente. Uma análise publicada pela McKinsey em fevereiro de 2026 aponta que, até 2030, a inferência ultrapassará o treinamento como carga dominante nos data centers de IA, representando mais da metade de toda a computação de IA e cerca de 30%–40% da demanda total dos data centers. Para as empresas, a lógica de compra de servidores migra de «empilhar placas para treinar» para «rodar inferência com custo calculado» — escolher a configuração errada não custa um sobrepreço único, mas três anos pagando todos os dias a conta de luz e o aluguel da arquitetura errada.
Ao mesmo tempo, o ritmo de iteração das GPUs acelerou visivelmente: os 141GB de VRAM da H200 mal se acomodaram e já chegam os 192GB da B200 e os 288GB da B300, enquanto a RTX PRO 6000 fatia o mercado de inferência intermediária com 96GB e formato PCIe. Quanto mais modelos, mais difícil escolher. Este artigo esclarece a seleção de servidores de IA em 2026 com um eixo de decisão e duas tabelas comparativas.
Qual é exatamente a diferença entre um servidor de treinamento e um servidor de inferência?
Resposta rápida: o treinamento é um megaprojeto pontual «intensivo em computação»; a inferência é um serviço contínuo «intensivo em VRAM e largura de banda». O servidor de treinamento busca o pico de computação da interconexão multi-GPU (fabric NVLink/NVSwitch completa, alta densidade de potência, refrigeração líquida); o servidor de inferência busca throughput estável por unidade de custo (VRAM que comporta o modelo, largura de banda que entrega tokens, consumo por placa sob controle, confiabilidade 7×24).
Em termos de hardware, os clusters de treinamento priorizam máquinas de 8 GPUs no formato SXM com rede InfiniBand; a inferência oferece um leque bem mais amplo — estações de trabalho com uma única RTX PRO 6000, servidores multi-GPU 2U/4U e até pequenos nós de inferência na borda. A realidade de 2026: a imensa maioria dos orçamentos de IA das empresas vai para a inferência, portanto a seleção de servidores deve seguir o princípio «inferência primeiro, treinamento sob demanda».
Por que a VRAM importa mais do que a computação na escolha de um servidor de IA?
Resposta rápida: se o modelo não cabe na VRAM, os TFLOPS mais altos valem zero. A capacidade de executar um modelo depende de quanta VRAM os pesos + o KV Cache + o comprimento do contexto ocupam; somente depois de acomodado é que largura de banda, suporte a FP4/FP8 e preço passam a fazer sentido como critérios de comparação.
Regra prática (2026): em precisão FP16, um modelo 70B precisa de cerca de 140GB de VRAM — uma única H200 (141GB) o comporta exatamente, caso contrário são necessárias duas H100; a quantização FP8 reduz a necessidade pela metade; FP4 reduz de novo pela metade, mas apenas a arquitetura Blackwell (B200/B300/RTX PRO 6000) suporta FP4 nativamente. Cada vez que a janela de contexto dobra, o KV Cache cresce quase linearmente — é por isso que entre «cabe» e «atende bem» existe a largura de banda: a H200 entrega 4,8 TB/s, as B200/B300 entregam 8 TB/s.
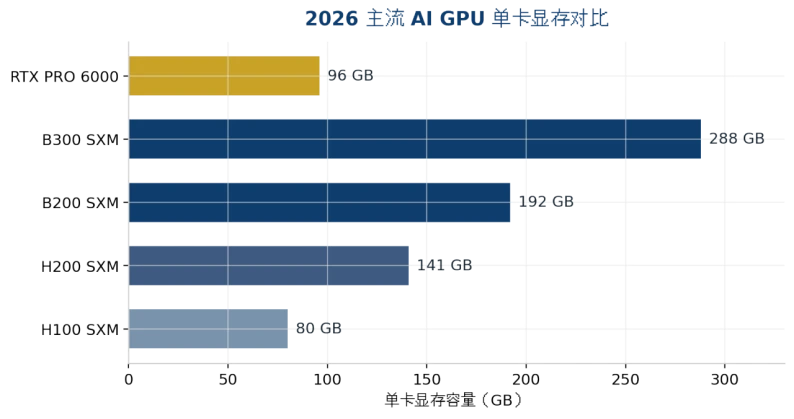
Figura 1: Comparação de VRAM por placa das principais GPUs de IA em 2026 (fontes dos dados no apêndice)
Como escolher entre as GPUs de 2026: H200 vs B200 vs B300 vs RTX PRO 6000
Resposta rápida: para modelos de até 141GB, a H200 oferece o melhor custo-benefício; escolha a B200 quando precisar de FP4 ou mais VRAM; escolha a B300 quando uma única placa precisar comportar um modelo acima de 200GB ou a pressão do KV Cache for alta; escolha a RTX PRO 6000 para inferência intermediária e ambientes PCIe.
Dimensão | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Arquitetura | Hopper | Blackwell | Blackwell Ultra | Blackwell |
VRAM | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Largura de banda de memória | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Computação FP4 | Não suportada | 9 PFLOPS | 15 PFLOPS | Suportada (classe de uma placa) |
TDP / refrigeração | 700W / ar possível | 1000W / líquida recomendada | ~1400W / líquida praticamente obrigatória | 600W / ar |
Posicionamento típico | Inferência 70B–100B, fine-tuning | Inferência 100B+, treinamento | LLMs de fronteira em um único nó | Inferência intermediária, estação/borda |
Referência de aluguel em nuvem 2026 | ~$4.4/GPU·h | ~$5–7/GPU·h | ~$7.4–8.3/GPU·h | Compra de sistemas completos sobretudo |
Tabela 1: Especificações-chave e posicionamento das principais GPUs de IA em 2026 (preços de referência de mercado de agosto de 2026, muito voláteis — solicite nova cotação antes da compra)
Há ainda duas tendências fáceis de ignorar: primeiro, o preço mediano do aluguel em nuvem da H200 subiu cerca de 25% desde agosto de 2025, a diferença de preço entre Hopper e Blackwell está diminuindo e a janela de «economizar com a geração anterior» está se fechando; segundo, a RTX PRO 6000 ganhou uma versão Server de 400W, que permite instalar mais placas no mesmo orçamento de energia — mais amigável para provedores de inferência que cobram por token.
Qual o tamanho do modelo, qual o tamanho da máquina?
Resposta rápida: estime o piso de VRAM como «pesos do modelo × 1,2 (margem para o KV Cache)» e depois determine o número de GPUs com a tabela abaixo; modelos que excedem um único nó passam para o paralelismo multimáquina, onde a rede importa mais do que as GPUs.
Modelo-alvo (2026) | Tamanho dos pesos | Configuração mínima | Formato recomendado |
7B–14B (classe Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 ou placa de estação de 48GB | Servidor de inferência de borda torre/2U |
32B–70B (quantização FP8) | 40–80GB | RTX PRO 6000 ×1–2 ou H200 ×1 | Servidor GPU 2U/4U |
70B FP16 / contexto longo | ~140GB+ | H200 ×1 (justo) ou ×2 (seguro) | Servidor multi-GPU 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (margem ~130GB) | Servidor 4U com refrigeração líquida |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 ou B300 ×4 | Sistema SXM de 8 GPUs |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (2,3TB de VRAM no total) | Sistema flagship de 8 GPUs com refrigeração líquida |
Tabela 2: Correspondência entre tamanho do modelo e configuração do servidor (pesos conforme os checkpoints oficiais; na implantação real, some o KV Cache e a sobrecarga do runtime)
Essa tabela também explica por que o chassi 4U é o «ponto ideal» dos servidores de IA: 8 GPUs de largura dupla, fontes redundantes e fluxo de ar de refrigeração suficiente — só o espaço de um 4U acomoda tudo ao mesmo tempo. O 2U serve para nós de inferência de 2–4 placas; o 1U aceita apenas uma placa ou funciona como nó frontal de agendamento/armazenamento.
Refrigeração a ar ou líquida? Como definir as especificações térmicas e de rack?
Resposta rápida: abaixo de 700W por placa, o ar é suficiente; acima de 1000W por placa — ou mais de 20kW por armário — a refrigeração líquida deixa de ser «diferencial» e vira «exigência rígida». O TDP de ~1400W da B300 praticamente impõe a refrigeração líquida.
A ordem correta de seleção é: primeiro o modelo e a GPU, depois a potência total da máquina e, por fim, o cálculo reverso da refrigeração e das condições da sala. Muitas empresas fazem o contrário — compram as máquinas primeiro e descobrem depois que a alimentação elétrica e o ar-condicionado não dão conta, sendo forçadas a reduzir a frequência: é como pagar o preço cheio por uma GPU «castrada». Antes da compra, confirme três itens: alimentação do armário (kW), temperatura e vazão do ar de entrada e margem para as próximas 2–3 gerações de GPUs (depois da B300, os TDPs só vão subir).
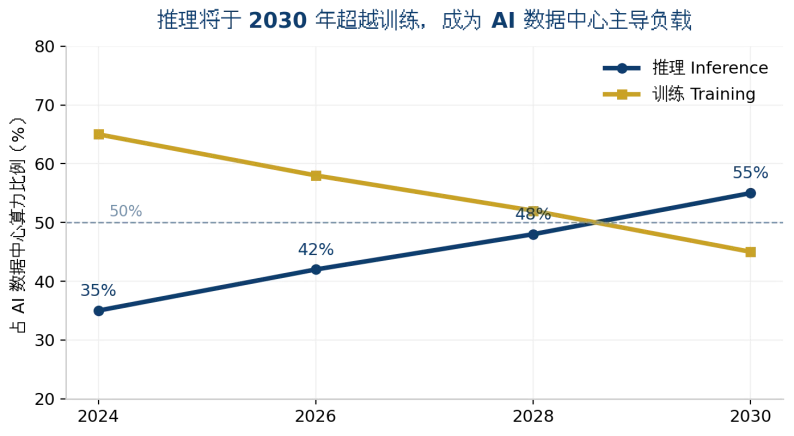
Figura 2: Até 2030, a inferência ultrapassará o treinamento como carga dominante dos data centers de IA (ilustração de tendência; fontes dos dados no apêndice)
Aluguel em nuvem ou infraestrutura própria? Como fazer as contas?
Resposta rápida: com utilização abaixo de 60%, alugue na nuvem; com cargas altas e contínuas, construa infraestrutura própria. Nos preços de agosto de 2026, o aluguel em nuvem de uma H200 custa cerca de US4,4/GPU·hora — aproximadamente US 38 mil por um ano inteiro em carga total, valor próximo ao custo de comprar uma placa. Quanto maior a utilização, mais rápido a infraestrutura própria se paga.
A conta da infraestrutura própria precisa somar mais três itens: energia elétrica e operação da refrigeração (cerca de 20%–30% do custo total de propriedade), a depreciação por gerações de GPU (em 2026, a H100 já está profundamente desvalorizada — o risco de valor residual é real) e a conformidade de dados: para clientes de finanças, saúde e governo, os dados não saem da intranet, tornando a implantação privada não uma escolha, mas uma obrigação. A arquitetura híbrida está se tornando dominante: treinamento de pico na nuvem, inferência permanente local.
ChangFan: servidores GPU e hardware de IA preparados para a era da inferência
No fim das contas, a escolha do servidor de IA não se vence nas fichas técnicas, mas na aderência entre configuração e cenário. A Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) oferece servidores GPU em rack e sistemas de inferência de IA nos formatos 1U/2U/4U, com expansão multi-GPU, fontes redundantes e design de temperatura ampliada. O número de GPUs, a configuração de VRAM e a refrigeração (ar/líquida) podem ser personalizados conforme o tamanho do modelo-alvo — uma base de hardware estável e confiável para implantação privada de LLMs, nós de inferência na borda e bases de conhecimento empresariais.
Se você está avaliando a compra e a implantação de servidores GPU das classes H200/B200/B300 ou RTX PRO 6000, entre em contato com a ChangFan para obter orientação de configuração e propostas de sistemas completos sob medida para o seu modelo-alvo (vendemos hardware e montamos sistemas completos — não oferecemos serviços de assinatura de software).
Perguntas frequentes (FAQ)
P1: Qual é a configuração mínima para rodar um LLM de 70B? R: Em FP16 são necessários cerca de 140GB de VRAM, portanto uma única H200 é a resposta mais econômica; após a quantização FP8, duas RTX PRO 6000 (96GB×2) também dão conta, com custo menor e mais flexibilidade de implantação.
P2: Em que a B300 é melhor que a B200 e vale a pena esperar? R: A B300 oferece 50% mais VRAM (288GB contra 192GB) e 1,5× a computação FP4, mas a mesma largura de banda e um TDP elevado a ~1400W que exige refrigeração líquida. O upgrade só compensa quando o modelo ou o KV Cache excedem a capacidade de um nó com B200.
P3: Por onde uma PME deve começar ao comprar seu primeiro servidor de IA? R: Defina primeiro o modelo a ser executado. Para aplicações de 7B–14B (atendimento ao cliente, base de conhecimento, inspeção de qualidade), um servidor de inferência 2U com uma GPU basta para começar; expanda para 4U multi-GPU quando a carga alta e contínua estiver confirmada.
P4: A refrigeração líquida é obrigatória em servidores de IA? R: Não. Abaixo de 700W por placa e com boas condições de sala, o ar é suficiente; a líquida só é necessária acima de 1000W por placa ou em implantações de vários armários de alta densidade. Na seleção, deixe margem para a tendência de consumo das próximas 2–3 gerações de GPUs.
P5: As GPUs em nuvem são tão baratas — por que comprar um servidor próprio? R: Três motivos — acima de ~60% de utilização, a infraestrutura própria custa menos; dados sensíveis não podem sair da intranet; e a inferência local não tem latência de rede, com SLA sob controle próprio. A maioria das empresas acaba adotando a arquitetura híbrida «treinar na nuvem, inferir localmente».