Как выбрать ИИ-сервер? Полное руководство 2026 года по аппаратной конфигурации для обучения и инференса
Введение: почему выбор ИИ-сервера стал обязательным навыком 2026 года
Структура расходов на ИИ-вычисления претерпевает фундаментальные изменения. Согласно аналитике McKinsey, опубликованной в феврале 2026 года, к 2030 году инференс обгонит обучение и станет доминирующей нагрузкой в ИИ-дата-центрах — более половины всех ИИ-вычислений и примерно 30–40% общего спроса дата-центров. Логика закупки серверов смещается от «набрать побольше карт под обучение» к «экономно крутить инференс» — ошибка в конфигурации обходится не разовой переплатой, а тремя годами ежедневных счетов за электричество и аренду неправильной архитектуры.
Параллельно заметно ускорился цикл обновления GPU: 141 ГБ видеопамяти H200 ещё не успели «обжиться», как уже разворачиваются 192 ГБ у B200 и 288 ГБ у B300, а RTX PRO 6000 с 96 ГБ и форм-фактором PCIe отвоёвывает рынок инференса среднего уровня. Чем больше моделей, тем сложнее выбор. В этой статье мы сводим выбор ИИ-сервера 2026 года к одной оси принятия решений и двум сравнительным таблицам.
Чем на самом деле отличается сервер обучения от сервера инференса?
Короткий ответ: обучение — это разовый «вычислительно-ёмкий» мегапроект, инференс — непрерывный сервис, «ёмкий по видеопамяти и пропускной способности». Сервер обучения гонится за пиковой производительностью многокарточной связки (полная связность NVLink/NVSwitch, высокая плотность мощности, жидкостное охлаждение); сервер инференса — за стабильной пропускной способностью на единицу стоимости (модель помещается в видеопамять, пропускная способность выдаёт токены, энергопотребление карты под контролем, надёжность 7×24).
В железе это выглядит так: для кластеров обучения предпочтительны 8-карточные машины форм-фактора SXM с сетью InfiniBand; у инференса выбор шире — однокарточные рабочие станции на RTX PRO 6000, многокарточные серверы 2U/4U и даже компактные узлы инференса на периферии. Реальность 2026 года: львиная доля корпоративных ИИ-бюджетов уходит на инференс, поэтому и серверы стоит выбирать по принципу «инференс в приоритете, обучение — по потребности».
Почему при выборе ИИ-сервера видеопамять важнее вычислительной мощности?
Короткий ответ: если модель не помещается в видеопамять, любые TFLOPS равны нулю. Сможет ли модель работать, определяется тем, сколько видеопамяти занимают веса + KV Cache + длина контекста; только после этого имеют смысл сравнения по пропускной способности, поддержке FP4/FP8 и цене.
Эмпирическое правило (2026 год): в точности FP16 модели 70B требуется около 140 ГБ видеопамяти — одна H200 (141 ГБ) вмещает её впритык, иначе нужны две H100; квантование в FP8 сокращает потребность вдвое; FP4 — ещё вдвое, но нативно FP4 поддерживает только архитектура Blackwell (B200/B300/RTX PRO 6000). При каждом удвоении контекстного окна объём KV Cache растёт почти линейно — поэтому между «помещается» и «хорошо обслуживает» стоит пропускная способность: у H200 это 4,8 ТБ/с, у B200/B300 — 8 ТБ/с.
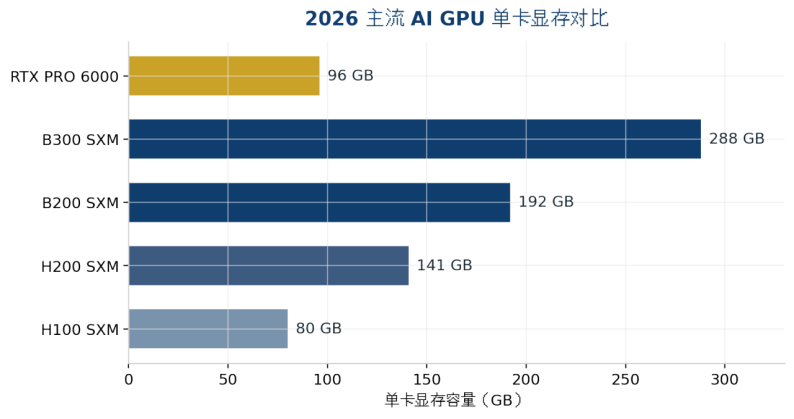
Рис. 1: Сравнение видеопамяти одной карты у основных ИИ-GPU 2026 года (источники данных — в приложении)
Как выбрать среди основных GPU 2026 года: сравнение H200, B200, B300 и RTX PRO 6000
Короткий ответ: для моделей в пределах 141 ГБ самый выгодный вариант — H200; если нужны FP4 или больше видеопамяти — B200; если одна карта должна вмещать модель свыше 200 ГБ или велико давление KV Cache — B300; для инференса среднего уровня и PCIe-сред — RTX PRO 6000.
Параметр | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
Архитектура | Hopper | Blackwell | Blackwell Ultra | Blackwell |
Видеопамять | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
Пропускная способность памяти | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
Производительность FP4 | Не поддерживается | 9 PFLOPS | 15 PFLOPS | Поддерживается (класс одной карты) |
TDP / охлаждение | 700 Вт / возможно воздушное | 1000 Вт / рекомендуется жидкостное | ~1400 Вт / практически обязательно жидкостное | 600 Вт / воздушное |
Типовое позиционирование | Инференс 70B–100B, дообучение | Инференс 100B+, обучение | Фронтирные LLM на одном узле | Инференс среднего уровня, рабочие станции/периферия |
Ориентир облачной аренды 2026 | ~$4.4/GPU·ч | ~$5–7/GPU·ч | ~$7.4–8.3/GPU·ч | В основном закупка целых машин |
Таблица 1: Ключевые характеристики и позиционирование основных ИИ-GPU 2026 года (цены — рыночные ориентиры на август 2026 года, сильно колеблются; перед закупкой запросите актуальную цену)
Есть и две легко упускаемые тенденции: во-первых, медианная цена облачной аренды H200 с августа 2025 года выросла примерно на 25%, разрыв в цене между Hopper и Blackwell сокращается, и окно «сэкономить на прошлом поколении» закрывается; во-вторых, у RTX PRO 6000 появилась серверная версия на 400 Вт — в тот же энергобюджет помещается больше карт, что выгодно провайдерам инференса с поминутной тарификацией за токен.
Насколько велика модель — настолько велика и машина?
Короткий ответ: оцените нижнюю границу видеопамяти как «веса модели × 1,2 (запас под KV Cache)», затем по таблице ниже определите число GPU; модели, не помещающиеся в один узел, переходят на многомашинный параллелизм — и там сеть важнее GPU.
Целевая модель (2026) | Размер весов | Минимальная конфигурация | Рекомендуемый форм-фактор |
7B–14B (класс Qwen/Phi) | 15–30GB (FP16) | RTX PRO 6000 ×1 или рабочая станция 48 ГБ | Напольный/2U периферийный сервер инференса |
32B–70B (квантование FP8) | 40–80GB | RTX PRO 6000 ×1–2 или H200 ×1 | GPU-сервер 2U/4U |
70B FP16 / длинный контекст | ~140GB+ | H200 ×1 (впритык) или ×2 (с запасом) | Многокарточный сервер 4U |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (запас ~130 ГБ) | Сервер 4U с жидкостным охлаждением |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 или B300 ×4 | 8-карточная машина SXM |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (суммарно 2,3 ТБ видеопамяти) | Флагманская 8-карточная машина с жидкостным охлаждением |
Таблица 2: Соответствие размера модели и конфигурации сервера (веса — по официальным checkpoint; при реальном развёртывании добавьте KV Cache и накладные расходы среды выполнения)
Эта таблица также объясняет, почему корпус 4U — «золотая середина» ИИ-серверов: 8 двухслотовых GPU, резервированные блоки питания и достаточные вентиляционные каналы одновременно помещаются только в 4U. Формат 2U подходит для узлов инференса на 2–4 карты, а 1U — лишь для одной карты или в роли фронтального узла планирования/хранения.
Воздушное или жидкостное охлаждение? Как определить тепловой и стоечный бюджет?
Короткий ответ: до 700 Вт на карту достаточно воздушного охлаждения; свыше 1000 Вт на карту — или при мощности стойки более 20 кВт — жидкостное охлаждение из «бонуса» превращается в «жёсткое требование». TDP B300 около 1400 Вт практически однозначно означает жидкостное охлаждение.
Правильная последовательность выбора: сначала модель и GPU, затем мощность всей машины, и только потом обратный расчёт охлаждения и условий машинного зала. Многие компании делают наоборот — сначала покупают железо, а потом выясняют, что электропитание и кондиционирование не выдерживают, и вынуждены работать на пониженной частоте: по сути, за полную цену куплена «кастрированная» GPU. Перед закупкой обязательно подтвердите три вещи: питание стойки (кВт), температуру и объём приточного воздуха, а также запас под 2–3 следующих поколения GPU (после B300 TDP будет только расти).
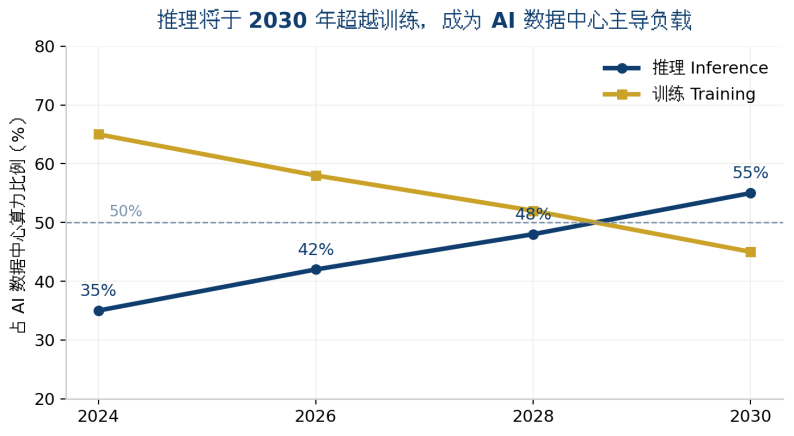
Рис. 2: К 2030 году инференс обгонит обучение как доминирующая нагрузка ИИ-дата-центров (иллюстрация тренда; источники данных — в приложении)
Облачная аренда или собственная инфраструктура? Как считать экономику?
Короткий ответ: при загрузке ниже 60% выгоднее облачная аренда, при устойчиво высокой нагрузке — собственное железо. По ценам августа 2026 года аренда H200 в облаке стоит около 4,4 за GPU·час — примерно 38 тыс. за полный год круглосуточной работы, что близко к стоимости покупки одной карты. Чем выше загрузка, тем быстрее окупается собственный сервер.
В расчёт собственной инфраструктуры нужно добавить ещё три статьи: электричество и эксплуатация охлаждения (около 20–30% совокупной стоимости владения), амортизация от смены поколений GPU (в 2026 году H100 уже глубоко подешевела — риск остаточной стоимости реален), а также комплаенс по данным: у финансовых, медицинских и государственных заказчиков данные не покидают внутренний контур, поэтому приватное развёртывание — не выбор, а необходимость. Мейнстримом становится гибридная архитектура: пиковое обучение — в облаке, постоянный инференс — локально.
ChangFan: GPU-серверы и ИИ-оборудование для эпохи инференса
В конечном счёте выбор ИИ-сервера выигрывается не в таблицах характеристик, а в соответствии конфигурации сценарию. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) предлагает стоечные GPU-серверы и машины ИИ-инференса в форм-факторах 1U/2U/4U с поддержкой многокарточного расширения, резервированным питанием и широким температурным диапазоном. Число GPU, объём видеопамяти и схема охлаждения (воздушная/жидкостная) настраиваются под целевой размер модели — стабильная и надёжная аппаратная основа для приватного развёртывания больших языковых моделей, периферийных узлов инференса и корпоративных баз знаний.
Если вы оцениваете закупку и развёртывание GPU-серверов класса H200/B200/B300 или RTX PRO 6000, обращайтесь в ChangFan — подберём конфигурацию и готовое машинное решение под вашу целевую модель (мы продаём оборудование и собираем целые машины; услуги по подписке на ПО не предоставляем).
Часто задаваемые вопросы (FAQ)
Q1: Какая минимальная конфигурация нужна для запуска модели 70B? A: В FP16 требуется около 140 ГБ видеопамяти, поэтому одна H200 — самый экономичный ответ; после квантования в FP8 задачу решают и две RTX PRO 6000 (96 ГБ × 2) — дешевле и гибче в развёртывании.
Q2: Чем B300 лучше B200 и стоит ли ждать? A: У B300 на 50% больше видеопамяти (288 ГБ против 192 ГБ) и в 1,5 раза выше производительность FP4, но пропускная способность та же, а TDP вырос до ~1400 Вт и требует жидкостного охлаждения. Переходить стоит, только если модель или KV Cache перерастают ёмкость узла на B200.
Q3: Что посоветуете малому и среднему бизнесу для первого ИИ-сервера? A: Сначала определите, какую модель будете запускать. Для приложений уровня 7B–14B (клиентская поддержка, базы знаний, контроль качества) для старта достаточно одного сервера инференса 2U с одной картой; при подтверждённой постоянной высокой нагрузке расширяйтесь до многокарточного 4U.
Q4: Обязательно ли жидкостное охлаждение для ИИ-сервера? A: Нет. До 700 Вт на карту при хороших условиях машинного зала достаточно воздушного; жидкостное нужно свыше 1000 Вт на карту или при плотном размещении нескольких стоек. При выборе закладывайте запас под энергопотребление 2–3 следующих поколений GPU.
Q5: Облачные GPU так дёшевы — зачем покупать собственный сервер? A: Три причины: при загрузке выше ~60% собственное железо дешевле; чувствительные данные не могут покидать внутренний контур; локальный инференс — без сетевых задержек и с собственным SLA. Большинство компаний в итоге приходят к гибридной схеме «обучение в облаке, инференс локально».