2026 پہلا عنوان: اے آئی سرور کا انتخاب کیسے کریں؟ ٹریننگ اور انفرنس کے لیے ہارڈویئر کنفیگریشن کی مکمل گائیڈ
تمہید: 2026 میں اے آئی سرور کا انتخاب لازمی سبق کیوں بن گیا
اے آئی کمپیوٹنگ اخراجات کی ساخت بنیادی تبدیلی سے گزر رہی ہے۔ McKinsey کی فروری 2026 میں شائع کردہ تجزیے کے مطابق 2030 تک انفرنس (inference) ٹریننگ سے آگے نکل کر اے آئی ڈیٹا سینٹرز کا غالب ورک لوڈ بن جائے گی — تمام اے آئی کمپیوٹنگ کا نصف سے زائد اور ڈیٹا سینٹرز کی مجموعی مانگ کا تقریباً 30–40 فیصد۔ اس کا مطلب ہے کہ اداروں کے سرور خریدنے کی منطق «ٹریننگ کے لیے کارڈوں کا انبار» سے بدل کر «انفرنس کو کفایت سے چلانا» ہو رہی ہے — غلط کنفیگریشن کی قیمت ایک بار کی اضافی ادائیگی نہیں بلکہ آنے والے تین سال تک ہر روز غلط آرکیٹیکچر کے بجلی اور کرایے کے بل ہیں۔
اسی دوران GPU پروڈکٹس کی تازہ کاری کی رفتار نمایاں طور پر تیز ہو گئی ہے: H200 کی 141GB وی رام ابھی جم بھی نہیں پائی تھی کہ B200 کی 192GB اور B300 کی 288GB پھیلنے لگیں، جبکہ RTX PRO 6000 نے 96GB وی رام اور PCIe فارم فیکٹر کے ساتھ درمیانے درجے کی انفرنس مارکیٹ کا حصہ کاٹ لیا۔ ماڈل جتنے زیادہ، انتخاب اتنا ہی مشکل۔ یہ مضمون ایک فیصلہ ساز محور اور دو موازنہ جدولوں کے ذریعے 2026 کے اے آئی سرور انتخاب کو واضح کرتا ہے۔
ٹریننگ سرور اور انفرنس سرور میں اصل فرق کیا ہے؟
مختصر جواب: ٹریننگ ایک «کمپیوٹ ساز» یک مرتبہ کا بڑا منصوبہ ہے، انفرنس ایک «وی رام اور بینڈوتھ ساز» مسلسل خدمت۔ ٹریننگ سرور ملٹی کارڈ انٹرکنیکٹ کی عروجی طاقت چاہتا ہے (مکمل NVLink/NVSwitch فیبرک، اعلیٰ پاور ڈینسٹی، لیکوڈ کولنگ)؛ انفرنس سرور فی یونٹ لاگت پر مستحکم تھروپٹ چاہتا ہے (وی رام جس میں ماڈل سما جائے، بینڈوتھ جو ٹوکن نکالے، فی کارڈ کنٹرول شدہ بجلی، اور 7×24 وشوسنییتا)۔
ہارڈویئر کی سطح پر ٹریننگ کلسٹرز کے لیے SXM فارم فیکٹر کی 8 کارڈ مشینیں اور IB نیٹ ورکنگ کو ترجیح دی جاتی ہے؛ انفرنس کے لیے اختیارات کہیں وسیع ہیں — سنگل کارڈ RTX PRO 6000 ورک سٹیشنز، 2U/4U ملٹی کارڈ سرورز، یہاں تک کہ ایج پر چھوٹے انفرنس نوڈز بھی۔ 2026 کی حقیقت یہ ہے کہ اداروں کے اے آئی بجٹ کا بیشتر حصہ انفرنس پر خرچ ہوتا ہے، اس لیے سرور کا انتخاب بھی «انفرنس اول، ٹریننگ حسبِ ضرورت» کے اصول پر ہونا چاہیے۔
اے آئی سرور کے انتخاب میں وی رام کمپیوٹ پاور سے اہم کیوں ہے؟
مختصر جواب: ماڈل وی رام میں نہ سما سکے تو بلند ترین TFLOPS بھی صفر کے برابر ہے۔ کوئی ماڈل چل سکتا ہے یا نہیں، یہ اس پر منحصر ہے کہ وزن + KV Cache + سیاق کی لمبائی کتنی وی رام گھیرتی ہے؛ جب ماڈل سما جائے تب ہی بینڈوتھ، FP4/FP8 سپورٹ اور قیمت کے موازنے کا کوئی مطلب بنتا ہے۔
اصولِ تجربہ (2026): FP16 درستگی پر 70B ماڈل کو تقریباً 140GB وی رام درکار ہوتی ہے — ایک H200 (141GB) بالکل بس میں سما دیتی ہے، ورنہ دو H100 چاہئیں؛ FP8 کوانٹائزیشن ضرورت نصف کر دیتی ہے؛ FP4 مزید نصف، لیکن FP4 کی مقامی حمایت صرف Blackwell آرکیٹیکچر (B200/B300/RTX PRO 6000) کرتی ہے۔ سیاق کی ونڈو دوگنی ہونے پر KV Cache کا استعمال تقریباً خطی طور پر بڑھتا ہے — اسی لیے «سما جانا» اور «اچھی خدمت» کے درمیان بینڈوتھ حائل ہے: H200 کی رفتار 4.8 TB/s اور B200/B300 کی 8 TB/s ہے۔
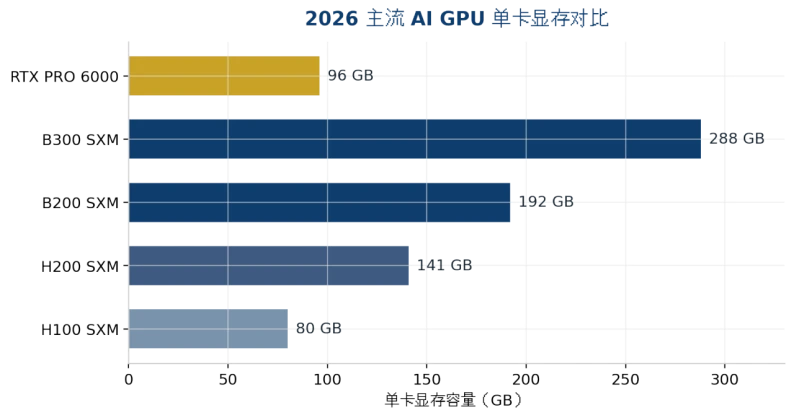
شکل 1: 2026 کی نمایاں اے آئی GPUs کی فی کارڈ وی رام کا موازنہ (ماخذِ معلومات ضمیمہ میں)
2026 کی نمایاں GPUs میں انتخاب کیسے کریں: H200 بمقابلہ B200 بمقابلہ B300 بمقابلہ RTX PRO 6000
مختصر جواب: 141GB تک کے ماڈلز کے لیے H200 بہترین قیمت و کارکردگی فراہم کرتی ہے؛ FP4 یا زیادہ وی رام درکار ہو تو B200 منتخب کریں؛ ایک کارڈ میں 200GB سے بڑا ماڈل سمانا ہو یا KV Cache کا دباؤ زیادہ ہو تو B300؛ درمیانے درجے کی انفرنس اور PCIe ماحول کے لیے RTX PRO 6000 منتخب کریں۔
جہت | H200 SXM | B200 SXM | B300 SXM | RTX PRO 6000 |
آرکیٹیکچر | Hopper | Blackwell | Blackwell Ultra | Blackwell |
وی رام | 141GB HBM3e | 192GB HBM3e | 288GB HBM3e | 96GB GDDR7 |
میموری بینڈوتھ | 4.8 TB/s | 8 TB/s | 8 TB/s | ~1.8 TB/s |
FP4 کمپیوٹ | سپورٹ نہیں | 9 PFLOPS | 15 PFLOPS | سپورٹ شدہ (سنگل کارڈ درجہ) |
TDP / کولنگ | 700W / ہوا ممکن | 1000W / لیکوڈ تجویز | ~1400W / لیکوڈ عملاً لازم | 600W / ہوا |
معمول کی پوزیشننگ | 70B–100B انفرنس، فائن ٹیوننگ | 100B+ انفرنس، ٹریننگ | ایک نوڈ پر فرنٹئیر LLMs | درمیانی انفرنس، ورک سٹیشن/ایج |
2026 کلاؤڈ کرایہ حوالہ | ~$4.4/GPU·گھنٹہ | ~$5–7/GPU·گھنٹہ | ~$7.4–8.3/GPU·گھنٹہ | زیادہ تر مکمل مشین خریداری |
جدول 1: 2026 کی نمایاں اے آئی GPUs کی اہم وضاحتیں اور پوزیشننگ (قیمتیں اگست 2026 کی مارکیٹ حوالہاتی ہیں، بہت غیر مستحکم — خرید سے قبل نیا نرخ نامہ لیں)
دو رجحانات ایسے بھی ہیں جو آسانی سے نظرانداز ہو جاتے ہیں: پہلا یہ کہ اگست 2025 سے H200 کا کلاؤڈ کرایہ اوسطاً تقریباً 25 فیصد بڑھ چکا ہے، Hopper اور Blackwell کی قیمتوں کا فرق سکڑ رہا ہے اور «پرانا ماڈل خرید کر بچت» والی کھڑکی بند ہو رہی ہے؛ دوسرا یہ کہ RTX PRO 6000 کا 400W والا Server ورژن آ چکا ہے جس سے اسی پاور بجٹ میں زیادہ کارڈ لگائے جا سکتے ہیں — فی ٹوکن بلنگ کرنے والے انفرنس فراہم کنندگان کے لیے زیادہ سازگار۔
ماڈل جتنا بڑا، مشین اتنی ہی بڑی؟
مختصر جواب: وی رام کی کم از کم حد «ماڈل وزن × 1.2 (KV Cache کے لیے گنجائش)» سے تخمینہ لگائیں، پھر نیچے دیے گئے جدول سے GPU کی تعداد طے کریں؛ ایک نوڈ سے باہر نکلنے والے ماڈلز ملٹی مشین متوازی میں داخل ہوتے ہیں جہاں نیٹ ورک GPU سے زیادہ اہم ہو جاتا ہے۔
ہدف ماڈل (2026) | وزن کا حجم | کم از کم کنفیگریشن | تجویز کردہ مشین شکل |
7B–14B (Qwen/Phi درجہ) | 15–30GB (FP16) | RTX PRO 6000 ×1 یا 48GB ورک سٹیشن کارڈ | ٹاور/2U ایج انفرنس سرور |
32B–70B (FP8 کوانٹائزیشن) | 40–80GB | RTX PRO 6000 ×1–2 یا H200 ×1 | 2U/4U GPU سرور |
70B FP16 / طویل سیاق | ~140GB+ | H200 ×1 (کس کر) یا ×2 (محفوظ) | 4U ملٹی کارڈ سرور |
DeepSeek V4 Flash (156GB) | ~156GB | B300 ×1 (تقریباً 130GB گنجائش باقی) | 4U لیکوڈ کولڈ سرور |
GLM-5.2 FP8 (~756GB) | ~756GB | H200 ×8 یا B300 ×4 | 8 کارڈ SXM مشین |
Kimi K3 (1.56TB MXFP4) | ~1.56TB | B300 ×8 (کل 2.3TB وی رام) | 8 کارڈ لیکوڈ کولڈ فلیگ شپ مشین |
جدول 2: ماڈل سائز اور سرور کنفیگریشن کی مطابقت (وزن سرکاری checkpoint کے مطابق؛ حقیقی تعیناتی میں KV Cache اور رن ٹائم اضافہ شامل کریں)
یہ جدول یہ بھی واضح کرتا ہے کہ 4U چیسیز اے آئی سرورز کی «میٹھی وضاحت» کیوں ہے: 8 ڈبل وڈتھ GPUs، ریڈنڈنٹ پاور سپلائز اور کافی کولنگ ایئر فلو — یہ سب ایک ساتھ صرف 4U کی جگہ میں سما سکتا ہے۔ 2U دو سے چار کارڈ والے انفرنس نوڈز کے لیے موزوں ہے، جبکہ 1U صرف ایک کارڈ میں سماتا ہے یا فرنٹ اینڈ شیڈیولنگ/اسٹوریج نوڈ کے کام آتا ہے۔
ایئر کولنگ یا لیکوڈ کولنگ؟ تھرمل اور ریک وضاحتیں کیسے طے کریں؟
مختصر جواب: فی کارڈ 700W سے کم پر ایئر کولنگ کافی ہے؛ فی کارڈ 1000W سے زیادہ — یا فی ریک 20kW سے زائد — پر لیکوڈ کولنگ «اضافی سہولت» سے «سخت شرط» بن جاتی ہے۔ B300 کا تقریباً 1400W TDP عملاً لیکوڈ کولنگ ہی مقرر کر دیتا ہے۔
انتخاب کی درست ترتیب یہ ہے: پہلے ماڈل اور GPU طے کریں، پھر پوری مشین کی پاور، اور آخر میں کولنگ اور مشین روم کے حالات کا الٹا حساب لگائیں۔ بہت سی کمپنیاں الٹا کرتی ہیں — پہلے مشینیں خرید لیتی ہیں، پھر معلوم ہوتا ہے کہ بجلی اور ایئر کنڈیشنگ برداشت نہیں کر سکتیں، اور مجبوراً گھٹا ہوا فریکوئنسی پر چلانا پڑتا ہے؛ گویا پوری قیمت دے کر «بغیر طاقت» GPU خرید لی۔ خرید سے پہلے تین چیزیں ضرور یقینی کریں: ریک پاور سپلائی (kW)، اندر آنے والی ہوا کا درجہ حرارت اور حجم، اور آئندہ 2–3 نسلوں کے لیے اپ گریڈ گنجائش (B300 کے بعد TDP مزید بڑھے گا ہی)۔
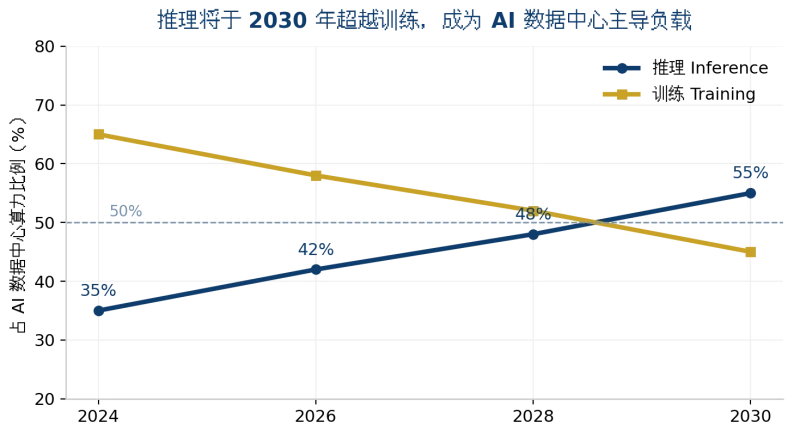
شکل 2: 2030 تک انفرنس ٹریننگ سے آگے نکل کر اے آئی ڈیٹا سینٹرز کا غالب ورک لوڈ بن جائے گی (رجحان کی تصویری وضاحت؛ ماخذِ معلومات ضمیمہ میں)
کلاؤڈ کرایہ یا اپنی تعمیر؟ لاگت کا حساب کیسے؟
مختصر جواب: استعمال 60 فیصد سے کم ہو تو کلاؤڈ کرایہ، طویل مدتی اونچے لوڈ پر اپنی تعمیر۔ اگست 2026 کے نرخوں کے مطابق H200 کا کلاؤڈ کرایہ تقریباً 4.4 فی GPU·گھنٹہ ہے — ایک کارڈ کا پورے سال بھر بھرپور استعمال کا کرایہ تقریباً38 ہزار، جو ایک کارڈ خریدنے کی لاگت کے قریب ہے۔ استعمال جتنا زیادہ، اپنی تعمیر اتنی جلد سرمایہ نکال لیتی ہے۔
اپنی تعمیر کے حساب میں تین اشیاء اور بھی شامل کرنی ہوں گی: مشین روم کی بجلی اور کولنگ آپریشن (مجموعی ملکیتی لاگت کا تقریباً 20–30 فیصد)، GPU نسلوں کی فرسودگی (2026 میں H100 کی قیمت بہت گھر چکی ہے — بقایا قیمت کا خطرہ حقیقی ہے)، اور ڈیٹا کمپلائنس — مالی، طبی اور سرکاری گاہکوں کا ڈیٹا اندرونی نیٹ ورک سے باہر نہیں جا سکتا، اس لیے نجی تعیناتی انتخاب نہیں بلکہ لازم ہے۔ ہائبرڈ آرکیٹیکچر مقبول ہو رہی ہے: عروجی ٹریننگ کلاؤڈ پر، مستقل انفرنس مقامی۔
ChangFan: انفرنس کے دور کے لیے تیار GPU سرورز اور اے آئی ہارڈویئر
آخرکار اے آئی سرور کا انتخاب وضاحتی جدولوں پر نہیں بلکہ «کنفیگریشن اور منظرنامے کے میل» پر جیتا جاتا ہے۔ Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) 1U/2U/4U فارم فیکٹرز میں ریک ماؤنٹ GPU سرورز اور اے آئی انفرنس مشینیں پیش کرتی ہے، ملٹی کارڈ توسیع، ریڈنڈنٹ پاور اور وسیع درجہ حرارت ڈیزائن کے ساتھ۔ ہدف ماڈل کے سائز کے مطابق GPU تعداد، وی رام کنفیگریشن اور ایئر/لیکوڈ کولنگ حسبِ منشا بنائی جا سکتی ہے — نجی LLM تعیناتی، ایج انفرنس نوڈز اور ادارہ جاتی نالج بیسز کے لیے مستحکم اور قابلِ اعتماد ہارڈویئر بنیاد۔
اگر آپ H200/B200/B300 یا RTX PRO 6000 درجے کے GPU سرورز کی خریداری اور تعیناتی کا جائزہ لے رہے ہیں تو ہدف ماڈل کے مطابق کنفیگریشن مشورے اور مکمل مشین تجاویز کے لیے ChangFan سے رابطہ کریں (ہم ہارڈویئر بیچتے ہیں اور مکمل مشینیں بناتے ہیں — سافٹ ویئر سبسکرپشن خدمات فراہم نہیں کرتے)۔
اکثر پوچھے گئے سوالات (FAQ)
س1: 70B بڑے ماڈل چلانے کے لیے کم از کم کنفیگریشن کیا چاہیے؟ ج: FP16 پر تقریباً 140GB وی رام درکار ہے، اس لیے ایک H200 سب سے کفایتی جواب ہے؛ FP8 کوانٹائزیشن کے بعد دو RTX PRO 6000 (96GB×2) بھی کام چلا سکتی ہیں، کم لاگت اور زیادہ لچکدار تعیناتی کے ساتھ۔
س2: B300 کس لحاظ سے B200 سے بہتر ہے اور کیا انتظار کرنا چاہیے؟ ج: B300 میں 50 فیصد زیادہ وی رام ہے (288GB بمقابلہ 192GB) اور FP4 کمپیوٹ 1.5 گنا زیادہ، لیکن بینڈوتھ وہی ہے اور TDP بڑھ کر تقریباً 1400W ہو گیا ہے جسے لیکوڈ کولنگ چاہیے۔ اپ گریڈ صرف اس وقت سودمند ہے جب ماڈل یا KV Cache B200 نوڈ کی گنجائش سے باہر نکل جائے۔
س3: چھوٹی درمیانی کمپنی پہلا اے آئی سرور خریدتے وقت کس سے آغاز کرے؟ ج: پہلے طے کریں کہ کون سا ماڈل چلانا ہے۔ 7B–14B درجے کی ایپلیکیشنز (کسٹمر سروس، نالج بیس، کوالٹی انسپکشن) کے لیے آغاز میں ایک 2U سنگل کارڈ انفرنس سرور کافی ہے؛ مستقل اونچا لوڈ یقینی ہونے پر 4U ملٹی کارڈ تک بڑھائیں۔
س4: کیا اے آئی سرور کے لیے لیکوڈ کولنگ لازم ہے؟ ج: نہیں۔ فی کارڈ 700W سے کم اور مشین روم کے اچھے حالات میں ہوا کافی ہے؛ لیکوڈ صرف فی کارڈ 1000W سے زیادہ یا کثیر ریک اعلیٰ کثافت تعیناتی میں درکار ہے۔ انتخاب کے وقت آئندہ 2–3 GPU نسلوں کے بجلی کے رجحان کے لیے گنجائش رکھیں۔
س5: کلاؤڈ GPU اتنی سستی ہے تو اپنا سرور کیوں خریدیں؟ ج: تین وجوہ — تقریباً 60 فیصد سے زیادہ استعمال پر اپنی تعمیر سستی پڑتی ہے؛ حساس ڈیٹا اندرونی نیٹ ورک سے باہر نہیں جا سکتا؛ مقامی انفرنس میں نیٹ ورک لیٹینسی نہیں اور SLA آپ کے کنٹرول میں۔ بیشتر ادارے آخرکار «ٹریننگ کلاؤڈ پر، انفرنس مقامی» والے ہائبرڈ ماڈل پر آ جاتے ہیں۔
ضمیمہ: SEO & GEO