Sự trỗi dậy của Edge AI: Tại sao các mô hình nhỏ đang kéo năng lực tính toán từ đám mây trở lại
Trả lời nhanh: AI biên có nghĩa là chạy suy luận mô hình trực tiếp trên phần cứng cục bộ hoặc thiết bị gần nơi dữ liệu được tạo ra, mà không cần gửi lên đám mây. Mô hình nhỏ (SLM) là các mô hình ngôn ngữ nhỏ gọn (thường từ 1 đến 14 tỷ tham số) được thiết kế để chạy hiệu quả trên phần cứng này. Sự kết hợp của cả hai cho phép các tổ chức chạy suy luận AI tại chỗ với độ trễ 50 đến 200 mili giây, không phụ thuộc vào kết nối mạng — đồng thời duy trì chủ quyền dữ liệu hoàn toàn và giảm chi phí suy luận tới 75% so với API đám mây.
Đây là một sự thay đổi cấu trúc, không phải xu hướng nhất thời.
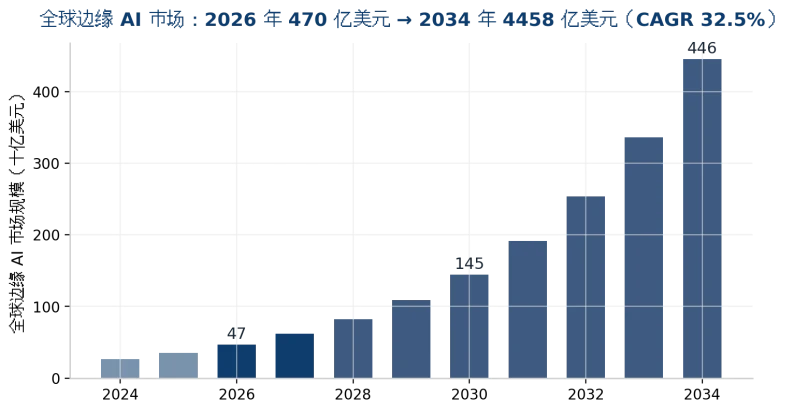
Gartner dự đoán rằng đến cuối năm 2027, 40% tổ chức sẽ sử dụng AI biên để xử lý dữ liệu nhạy cảm trong môi trường vận hành của họ — trong khi năm 2023 tỷ lệ này dưới 5%. Nguyên nhân là sự hội tụ của các áp lực kinh tế, quy định và kỹ thuật.
Bài viết này trả lời ba câu hỏi quan trọng: tại sao mô hình nhỏ đột nhiên đủ tốt; triển khai AI biên giải quyết những vấn đề thực tế nào; và các tổ chức cần phần cứng gì vào năm 2026 để triển khai AI biên.
Sự hội tụ của ba động lực cấu trúc
Động lực thứ nhất là kinh tế: chi phí suy luận đám mây rất biến động và khó dự đoán. Động lực thứ hai là quy định: các quy định như GDPR, HIPAA và luật nội địa hóa dữ liệu của Trung Quốc đã khiến việc gửi dữ liệu nhạy cảm đến hạ tầng đám mây bên ngoài trở nên khó khăn hoặc bất khả thi đối với nhiều tổ chức. Động lực thứ ba là kỹ thuật: mô hình nhỏ bây giờ có thể thực hiện nhiều tác vụ mà hai năm trước cần LLM khổng lồ.
Ba động lực này đã mở ra một cửa sổ triển khai không chỉ cho các gã khổng lồ công nghệ mà còn cho các doanh nghiệp vừa và nhỏ.
Mô hình nhỏ so với mô hình lớn: Điều gì thực sự thay đổi
Nhãn «nhỏ» trong SLM gây hiểu lầm. Năm 2026, một mô hình có 7 đến 14 tỷ tham số được coi là «nhỏ» — nhưng Phi-4 của Microsoft, với 14 tỷ tham số, đạt độ chính xác 94% trong chuẩn đo toán GSM8K, trong khi GPT-5 đạt 87%. Đây không phải ngoại lệ: trong các lĩnh vực chuyên môn với dữ liệu có cấu trúc, mô hình nhỏ được tinh chỉnh liên tục vượt trội hơn mô hình tổng quát lớn hơn gấp trăm lần.
Lý do rất đơn giản: đào tạo theo lĩnh vực. Một mô hình nhỏ được đào tạo trên tài liệu y tế, hợp đồng pháp lý hoặc báo cáo bảo trì thiết bị sẽ chính xác hơn mô hình tổng quát lớn trong lĩnh vực đó — vì có ít nhiễu hơn để lọc.
Đối với triển khai biên, điều này có nghĩa: mô hình đủ nhỏ để chạy trên Jetson Thor hoặc máy tính công nghiệp; phản hồi đủ nhanh để hỗ trợ ứng dụng thời gian thực; và chi phí mỗi suy luận chỉ bằng một phần mười đến một phần ba mười của một cuộc gọi API đám mây.
Đồng thời, mô hình nhỏ không phải cho mọi mục đích. Trong lập luận đa bước phức tạp, tạo nội dung dài và các tác vụ đòi hỏi kiến thức tổng quát rộng, mô hình lớn vẫn vượt trội. Đó là lý do tương lai là lai ghép — không phải thay thế.
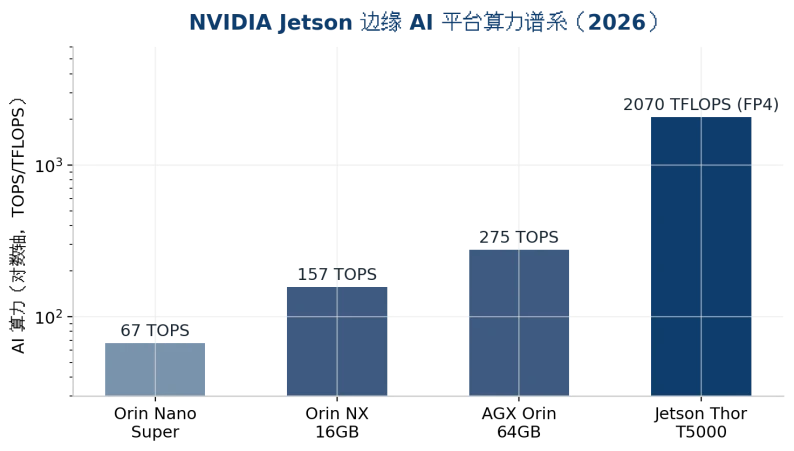
Cấp phần cứng | Nền tảng đại diện | Sức mạnh (TOPS) | RAM khuyến nghị | Tiêu thụ điện |
Giá ước tính | Ứng dụng chính | Nhỏ gọn / cấp nhập môn | Jetson Orin Nano / NUC | 67 TOPS |
8 đến 16GB | 15 đến 30W | 400 đến 800 đô la | Cảm biến, camera | Công nghiệp tầm trung |
Jetson AGX Orin / IPC | 157 đến 275 TOPS | 32 đến 64GB | 30 đến 100W | 1.500 đến 5.000 đô la |
Kiểm tra hình ảnh, robot | Cao cấp / chuyên nghiệp | Jetson Thor / RTX 5090 | 2070 teraflop FP4 | 48GB trở lên |
300 đến 700W | 4.699 đô la trở lên | AI vật lý, suy luận nặng | Doanh nghiệp / trung tâm dữ liệu biên | RTX 6000 Ada / H100 |
Kiến trúc lai ghép trong thực tế
AI lai ghép có nghĩa là các mô hình nhỏ cục bộ xử lý thu thập dữ liệu, tiền xử lý, tác vụ thời gian thực và phản hồi ban đầu, trong khi LLM đám mây được sử dụng cho lập luận phức tạp, tìm kiếm kiến thức và công việc sáng tạo. Kiến trúc này giữ lại lợi ích của cả hai: độ trễ thấp và chủ quyền dữ liệu tại biên, sức mạnh tính toán cao trên đám mây.
Nghiên cứu cho thấy 80 đến 95% khối lượng công việc suy luận sản xuất có thể được thực hiện bởi mô hình nhỏ tại biên, và chỉ 5 đến 20% thực sự cần mô hình đám mây lớn. AT&T đã giảm 90% chi phí suy luận và tăng 70% tốc độ phản hồi thông qua định tuyến thông minh — chỉ gửi các truy vấn phức tạp đến mô hình lớn.
Triển khai riêng tư: chủ quyền dữ liệu như lợi thế cạnh tranh
Đối với sản xuất, năng lượng, vận tải và dịch vụ tài chính, triển khai AI riêng tư không chỉ là yêu cầu quy định — mà là lợi thế cạnh tranh. Khi mô hình chạy trong mạng của tổ chức, dữ liệu không bao giờ rời khỏi: không phải để đào tạo, không phải để xử lý. Điều này loại bỏ rủi ro rò rỉ dữ liệu, vi phạm thỏa thuận bảo mật và phụ thuộc vào nhà cung cấp.
Về mặt chi phí cũng hấp dẫn: triển khai biên được thực hiện với một lần đầu tư phần cứng duy nhất và sau đó chi phí mỗi suy luận gần như bằng không — trong khi API đám mây tính phí mỗi lần gọi. Đối với các ứng dụng lặp lại thường xuyên (kiểm tra hình ảnh, giám sát thiết bị, xử lý tài liệu), sự khác biệt chi phí trở nên rõ ràng trong vài tháng.
Sự trỗi dậy của AI vật lý
AI vật lý — tức là AI chạy trên robot, phương tiện và thiết bị công nghiệp — đòi hỏi phần cứng biên, vì các quyết định vật lý không thể chờ đợi một vòng đi về đám mây. Một cánh tay robot cần phản ứng trong 50 mili giây không thể tin cậy vào API đám mây có độ trễ 200 mili giây.
Đây là nơi máy tính công nghiệp phát huy tác dụng: khác với laptop tiêu dùng, chúng được chế tạo để hoạt động 24/7 trong môi trường khắc nghiệt — nhiệt độ -25 đến 70 độ C, không quạt, chống bụi và rung động. Những tính năng này không phải tùy chọn đối với AI vật lý.
Phần cứng AI biên: hướng dẫn mua năm 2026
ChangFan Industrial Computing cung cấp giải pháp phần cứng AI biên cho môi trường sản xuất, năng lượng và vận tải.
Câu hỏi quan trọng trong việc chọn phần cứng biên là: bạn muốn chạy mô hình nào, với tốc độ suy luận nào?
Đối với mô hình 7 đến 14 tỷ tham số (Phi-4, Mistral, Llama 3.x lượng tử hóa), NVIDIA Jetson AGX Orin (67 TOPS) hoặc Jetson Thor (157 đến 275 TOPS) là đủ. Đối với suy luận nặng hơn với mô hình 30 đến 70 tỷ tham số, cần máy trạm có GPU tiêu dùng cao cấp (RTX 5090, 2070 teraflop FP4) hoặc GPU trung tâm dữ liệu nhỏ gọn (RTX 6000 Ada, khoảng 1 petaflop FP4).
RAM rất quan trọng: mô hình 7 tỷ tham số lượng tử hóa cần 8 đến 16GB, mô hình 14 tỷ cần 32 đến 48GB, và mô hình 70 tỷ lượng tử hóa cần 96GB trở lên. Bộ nhớ thấp là nút thắt thực sự của nhiều triển khai biên.
Đối với môi trường khắc nghiệt (sàn nhà máy, ngoài trời, phương tiện), máy tính công nghiệp không quạt với dải nhiệt độ rộng (-25 đến 70 độ C) và nguồn điện công nghiệp là bắt buộc. Phần cứng tiêu dùng sẽ hỏng trong vài tháng trong những điều kiện này.
Ứng dụng thực tế theo ngành
Sản xuất: kiểm tra hình ảnh thời gian thực trên dây chuyền sản xuất, bảo trì dự đoán bằng phân tích rung động và âm thanh, tối ưu hóa tham số quy trình. Lợi thế biên: quyết định dừng dây chuyền trong mili giây, không phải giây.
Năng lượng và hạ tầng: giám sát thiết bị tại các địa điểm xa xôi không có phủ sóng mạng đáng tin cậy, phát hiện bất thường trong trạm biến áp, dự đoán hỏng hóc tuabin. Lợi thế biên: hoạt động độc lập với kết nối internet.