2026年LLM推理GPU服务器怎么选:显存、拓扑与散热全解析
- 广州长帆智能科技有限公司
- 2026-10-23
引言:AI的账单,最终落在推理上
2026年,AI的焦点已从训练转向推理。训练一个大模型是一次性的资本支出,而把它服务给用户则是长期的运营成本。行业估算显示,AI服务器支出正处在陡峭的上升曲线上,而用于推理而非训练的计算占比,如今已占据部署GPU机时的大多数。对大多数企业而言,真正的问题不再是「哪块GPU最快」,而是「在我这样的并发量、模型规模和机架功耗预算下,哪台GPU服务器能把每百万Token成本压到最低」。本文用数据回答这个问题。
LLM推理到底消耗什么?
一句话答案:推理是「显存带宽受限」,而不是「算力受限」。每生成一个Token,都要把模型权重和KV Cache在GPU中搬运一遍,因此每秒Token数主要随显存带宽和批大小增长,而不是随峰值TFLOPS增长。
推理分为两个阶段:Prefill并行处理整个提示词,属于计算密集型;Decode逐Token生成输出,属于显存带宽密集型。长提示词和长输出压榨的是不同资源。这就是为什么一块峰值TFLOPS很高、但显存小、带宽窄的卡,在真实对话负载下可能输给一块「更慢」但带宽更大的卡。选服务器时,要同时看显存容量、显存带宽和NVLink/PCIe拓扑,而不是只看规格表上的峰值算力。
7B、13B、70B、180B模型各需要多少显存?
一句话答案:按FP16约每参数2字节、INT8约1字节、INT4约0.5字节估算,再为KV Cache和运行时开销预留15%—30%。单个70B模型在INT8下、批处理前就需要约80—100GB显存,即至少2×48GB或4×24GB的卡。
KV Cache是隐藏成本。它随上下文长度×并发序列数×层数增长,因此一台在4K上下文能装下模型的服务器,到了32K或高并发时可能直接显存溢出。要按P95上下文长度和目标并发来规划显存,而不是按演示用的提示词。经验法则是:面向推理优化的部署应保留20%—30%的显存余量,让调度器可以大胆批处理而不触发OOM重启。
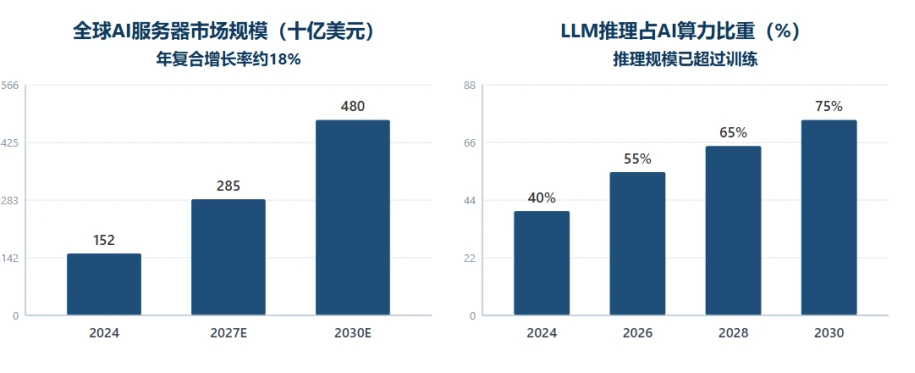
图 1:AI服务器市场规模与LLM推理占比上升趋势(数据来源见附录)
4U多卡还是8卡整机?拓扑、散热与扩展
一句话答案:对大多数私有化LLM部署,一台搭载4—5块双宽GPU的4U服务器就是甜点区;只有当单个模型必须跨4块以上GPU,或需要单机最大吞吐时,才升级到8卡NVLink平台。
拓扑决定多卡推理能否线性扩展。纯PCIe分发对小模型和数据并行服务够用,但70B+模型的张量并行服务需要高带宽GPU互连(NVLink/NVSwitch),否则互连就成了瓶颈。散热决定它能否稳定运行:4U机箱里4—5块350—700W双宽卡,必须配专用后置GPU风扇模块和前后贯通风道。电源按3+1或2+2冗余配置,并确认机架能供足够的电流。
▪ 单卡:适合7B—13B原型验证和低并发内部工具。
▪ 4U内2—4卡:32B—70B模型在容量、冗余与功耗上的最佳平衡。
▪ 8卡NVLink节点:面向70B+张量并行服务、多租户API或Agent集群。
▪ 下单前务必核对PCIe通道分配和后置风扇空间。
LLM推理场景与GPU服务器配置对照(2026)
下表把典型推理负载映射到起步硬件配置。把它当作选型基线,再结合你自己提示词组合下实测的每秒Token数做微调。
场景 | 模型与并发 | GPU配置 | 显存目标 | 推荐平台 |
原型验证/单人开发 | 7B—13B,1—3人 | 1块双宽GPU | 24—48GB | 1U/2U GPU工作站 |
团队推理 | 7B—32B,5—20人 | 1—2块双宽GPU | 48—96GB | 2U GPU服务器 |
部门级大模型 | 70B(INT8),20—50人 | 2—4块GPU | 96—160GB | 4U 4卡服务器 |
企业级服务 | 70B—180B,50—200人 | 4—8块GPU+NVLink | 160—640GB | 4U/8卡NVLink节点 |
多租户/Agent | 不限,200+人 | 8块数据中心GPU | 640GB+ | 8卡HGX/集群 |
表 1:LLM推理负载与GPU服务器配置对照(2026)
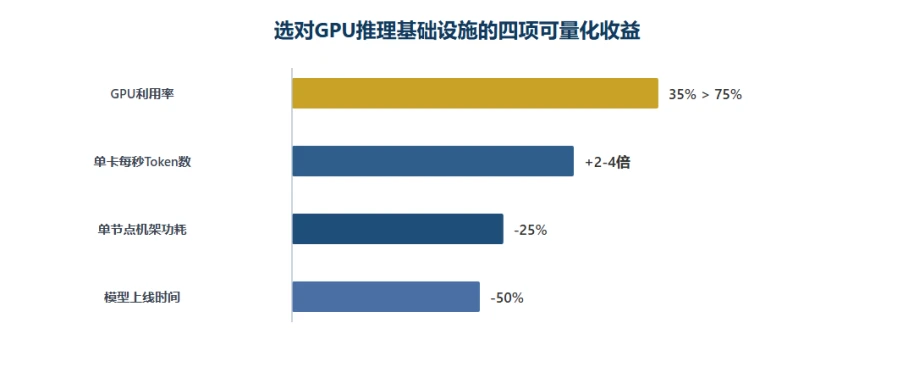
图 2:选对GPU推理基础设施带来的四项可量化收益(示意,数据来源见附录)
功耗、散热,以及你忘了做预算的那间机房
一句话答案:高密度GPU服务器会把机架变成一台取暖器。一台4U节点配4块600W GPU,加上CPU和风扇,功耗可达3—4kW;8卡节点则突破8—10kW。硬件到货前,先确认你的PDU、电路和制冷扛得住。
风道方向、冷热通道封闭和环境温度,都决定GPU在持续推理负载下会不会降频。如果机房撑不起高密度机架,一台功耗适中的4U/4卡节点,往往比一台理论上很强、实际却热降频的8卡怪兽更可靠。噪音是另一个被忽视的约束:后置GPU风扇模块很吵,要把机器放在远离人员的位置。
长帆GPU服务器:为AI推理而生的整机平台
工业AI,七分在负载、三分在硬件,但错的那三分会让七分归零。广州长帆智能科技有限公司(长帆/ChangFan)专注机架式GPU服务器,为持续推理而设计:4U平台支持最多5块双宽GPU,搭载双路Intel Xeon Scalable(第1—5代),最高4TB DDR4/DDR5 ECC内存;单路AMD EPYC 7002/7003/8004平台支持4块双宽GPU;24盘位机箱可选NVMe用于模型存储。每台整机均配专用后置GPU风扇模块、1+1或2+2冗余电源、板载千兆网络、PCIe扩展与IPMI远程管理。
如果您正在评估私有化大模型、推理API或Agent集群,欢迎联系长帆,按「模型规模×并发×机架功耗」获取整机配置建议(仅硬件整机,不含软件订阅)。支持为集成商与品牌客户提供OEM/ODM定制。
常见问题(FAQ)
Q1:7B模型做推理需要几张卡?
A:单张24GB卡即可在INT8下跑7B模型;若用FP16并有一定并发,一张48GB或两张24GB卡能留出充足余量。第一约束是显存,不是FLOPS。
Q2:推理该用消费级RTX卡还是数据中心GPU?
A:原型验证和低并发内部工具,消费级卡每GB价格更优;数据中心GPU胜在显存带宽、NVLink、ECC和7×24可靠性。应按SLA和并发选型,而不是按峰值FLOPS。
Q3:4U 4卡服务器够跑70B模型吗?
A:中等并发下做INT8服务足够:4×48GB(192GB)可从容容纳70B INT8模型加KV Cache。若要FP16、高并发或跑180B模型,则需上8卡NVLink节点。
Q4:显存越大推理一定越快吗?
A:不一定。每秒Token数取决于显存带宽、批大小和互连。更大容量能防止OOM并支撑更大批处理,但吞吐由带宽和拓扑决定。
Q5:能先买标准2U服务器,以后再加GPU吗?
A:通常不能安全地加。标准服务器缺少GPU供电线、后置风扇模块和双宽卡所需的PCIe通道分配。建议第一天就买为GPU设计的机箱。
- 上一篇 2026边缘AI规模化元年:从Orin到Thor,长帆如何卡位“物理AI”算力底座?
- 下一篇 没有了