Cum să alegi un server GPU pentru inferența LLM în 2026: VRAM, topologie și răcire
Introducere: inferența este locul unde ajunge cu adevărat factura AI
În 2026 conversația despre AI s-a mutat de la antrenare la inferență. Antrenarea unui model de frontieră este o investiție unică; servirea lui către utilizatori este un cost operațional permanent. Estimările plasează cheltuielile pe servere AI pe o curbă abruptă, iar ponderea de calcul dedicată inferenței în locul antrenării reprezintă acum majoritatea orelor GPU implementate. Pentru majoritatea companiilor întrebarea practică nu mai este „care GPU este cel mai rapid”, ci „care server GPU menține costul pe milion de tokeni scăzut la concurența, dimensiunea modelului și bugetul de putere din rack”. Acest ghid răspunde cu cifre.
Ce consumă de fapt inferența LLM?
Răspuns scurt: inferența este limitată de lățimea de bandă a memoriei, nu de calcul. Generarea fiecărui token înseamnă transmiterea greutăților modelului și a KV-cache prin GPU, așa că tokenii pe secundă scalează mult mai mult cu lățimea de bandă a memoriei și dimensiunea lotului decât cu TFLOPS brute.
Contează două faze. Prefill procesează întregul prompt în paralel și este intensiv în calcul; decode generează ieșirea token cu token și este intensiv în lățime de bandă. Prin urmare, prompturile lungi și ieșirile lungi solicită resurse diferite. De aceea o placă cu TFLOPS uriași dar VRAM mică și bandă îngustă poate pierde în fața unei plăci „mai lente” cu mai multă lățime de bandă pe sarcini reale de chat. La dimensionarea unui server, urmăriți împreună capacitatea VRAM, lățimea de bandă VRAM și topologia NVLink/PCIe, nu doar vârful FLOPS din fișa tehnică.
Cât VRAM necesită modelele 7B, 13B, 70B și 180B?
Răspuns scurt: calculați aproximativ 2 octeți pe parametru în FP16, 1 octet în INT8 și 0,5 octeți în INT4, apoi adăugați 15-30 % pentru KV-cache și suprasarcina de rulare. Un singur model 70B în INT8 necesită circa 80-100 GB înainte de batching, adică cel puțin plăci 2x48 GB sau 4x24 GB.
KV-cache este costul ascuns. Crește cu lungimea contextului x secvențele concurente x straturile, așa că un server care găzduiește un model la context 4K poate rămâne fără memorie la 32K sau la concurență mare. Planificați VRAM pentru lungimea contextului p95 și concurența țintă, nu pentru promptul demonstrativ. De regulă, implementările optimizate pentru inferență păstrează 20-30 % rezervă de VRAM, astfel încât planificatorul să poată grupa agresiv fără reporniri din cauza OOM.
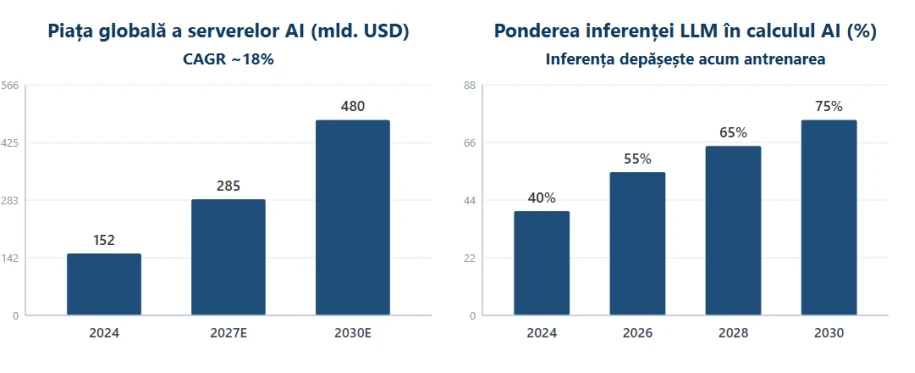
Figura 1: dimensiunea pieței serverelor AI și ponderea crescătoare a inferenței LLM (surse în anexă)
4U multi-GPU sau șasiu cu 8 GPU? Topologie, răcire și extindere
Răspuns scurt: un server 4U cu 4-5 GPU cu lățime dublă este optimul pentru majoritatea implementărilor LLM private; treceți la o platformă cu 8 GPU NVLink doar când un model trebuie să acopere mai mult de patru GPU sau aveți nevoie de debit maxim pe nod.
Topologia decide dacă inferența multi-GPU scalează. Distribuția doar prin PCIe este suficientă pentru modele mici și servire data-parallel, dar servirea tensor-parallel a unui model 70B+ necesită legături GPU-GPU de mare viteză (NVLink/NVSwitch), altfel interconectarea devine blocajul. Termica decide dacă supraviețuiește: patru sau cinci plăci cu lățime dublă de 350-700 W în 4U necesită un modul dedicat de ventilatoare GPU posterior și flux de aer față-spate. Planificați surse redundante 3+1 sau 2+2 și confirmați că rackul livrează amperajul.
▪ GPU unic: ideal pentru prototipuri 7B-13B și instrumente interne cu concurență mică.
▪ 2-4 GPU într-un 4U: cel mai bun echilibru de capacitate, redundanță și putere pentru modele 32B-70B.
▪ Nod cu 8 GPU NVLink: pentru servire tensor-parallel 70B+, API multi-tenant sau flote de agenți.
▪ Verificați întotdeauna alocarea liniilor PCIe și spațiul pentru ventilatoarele posterioare înainte de cumpărare.
Scenarii de inferență LLM vs configurația serverului GPU (2026)
Tabelul de mai jos mapează sarcini tipice de inferență la un anvelopă hardware de pornire. Tratați-l ca bază de dimensionare, apoi rafinați cu tokenii pe secundă măsurați pe propriul mix de prompturi.
Scenariu | Model și concurență | Configurație GPU | VRAM țintă | Platformă recomandată |
Prototip / dezvoltator unic | 7B-13B, 1-3 utilizatori | 1 GPU cu lățime dublă | 24-48 GB | Stație GPU 1U/2U |
Inferență de echipă | 7B-32B, 5-20 utilizatori | 1-2 GPU cu lățime dublă | 48-96 GB | Server GPU 2U |
LLM departamental | 70B (INT8), 20-50 utilizatori | 2-4 GPU | 96-160 GB | Server 4U cu 4 GPU |
Servire enterprise | 70B-180B, 50-200 utilizatori | 4-8 GPU + NVLink | 160-640 GB | Nod 4U/8 GPU NVLink |
Multi-tenant / agenți | Oricare, 200+ utilizatori | 8 GPU de centru de date | 640 GB+ | 8 GPU HGX / cluster |
Tabelul 1: sarcini de inferență LLM vs configurații de server GPU (2026)
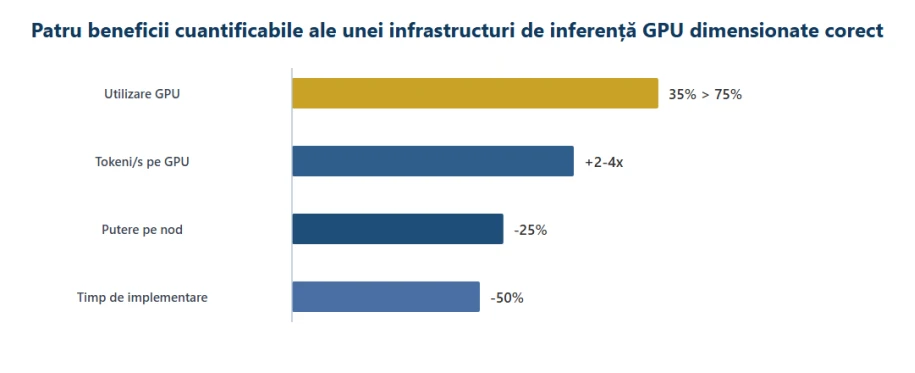
Figura 2: patru beneficii cuantificabile ale unei infrastructuri de inferență GPU dimensionate corect (ilustrativ, surse în anexă)
Putere, răcire și camera pe care ați uitat să o bugetați
Răspuns scurt: serverele GPU dense transformă un rack într-un radiator. Un nod 4U cu patru GPU de 600 W plus CPU și ventilatoare poate consuma 3-4 kW; nodurile cu 8 GPU depășesc 8-10 kW. Confirmați că PDU, circuitul și răcirea rezistă înainte de sosirea hardware-ului.
Direcția fluxului de aer, izolarea culoarelor calde și temperatura ambientală decid dacă GPU-urile vor throttla sub sarcină susținută de inferență. Dacă facilitatea nu suportă rackuri de înaltă densitate, un nod 4U/4 GPU la putere moderată este adesea mai fiabil decât un monstru teoretic cu 8 GPU care throttlază termic. Zgomotul este cealaltă constrângere uitată: modulele de ventilatoare GPU posterioare sunt zgomotoase, așa că planificați amplasarea departe de oameni.
Servere GPU ChangFan: o platformă completă creată pentru inferența AI
AI industrial este 70 % sarcină și 30 % hardware, dar cei 30 % greșiți pot anula cei 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) produce servere GPU rack concepute pentru inferență susținută: platforme 4U cu până la 5 GPU cu lățime dublă pe dublu Intel Xeon Scalable (gen. 1-5) cu până la 4 TB memorie DDR4/DDR5 ECC, variante single-socket AMD EPYC 7002/7003/8004 cu 4 GPU cu lățime dublă și șasiuri cu 24 bay-uri cu NVMe opțional pentru stocarea modelelor. Fiecare unitate are modul dedicat de ventilatoare GPU posterior, alimentare redundantă 1+1 sau 2+2, rețea Gigabit integrată, expansiune PCIe și management remote IPMI.
Dacă evaluați un LLM privat, un API de inferență sau o flotă de agenți, contactați ChangFan pentru o recomandare de configurație completă dimensionată după dimensiunea modelului x concurență x puterea din rack (doar hardware, fără abonament software). Personalizarea OEM/ODM este acceptată pentru integratori și branduri.
Întrebări frecvente (FAQ)
Î1: Câte GPU necesită un model 7B pentru inferență?
R: O singură placă de 24 GB rulează un model 7B în INT8; pentru FP16 și concurență moderată, o placă de 48 GB sau două de 24 GB oferă rezervă confortabilă. VRAM, nu FLOPS, este prima constrângere.
Î2: Plăci RTX de consum sau GPU de centru de date?
R: Plăcile de consum câștigă la preț pe GB pentru prototipuri și instrumente interne cu concurență mică; GPU-urile de centru de date câștigă la lățime de bandă, NVLink, ECC și fiabilitate 24/7. Alegeți după SLA și concurență, nu după vârful FLOPS.
Î3: Este suficient un server 4U cu 4 GPU pentru un model 70B?
R: Pentru servire INT8 la concurență moderată, da: 4x48 GB (192 GB) găzduiesc confortabil un model 70B INT8 plus KV-cache. Pentru FP16, concurență mare sau modele 180B, treceți la un nod cu 8 GPU NVLink.
Î4: Mai mult VRAM înseamnă întotdeauna inferență mai rapidă?
R: Nu. Tokenii pe secundă depind de lățimea de bandă a memoriei, dimensiunea lotului și interconectare. Capacitatea suplimentară previne OOM și permite loturi mai mari, dar lățimea de bandă și topologia decid debitul.
Î5: Pot adăuga GPU mai târziu la un server 2U standard?
R: De obicei nu în siguranță: serverele standard nu au cablare de alimentare GPU, module de ventilatoare posterioare și alocare de linii PCIe pentru plăci cu lățime dublă. Cumpărați de la început un șasiu proiectat pentru GPU.
- Articolul anterior Extinderea Edge AI în 2026: De la Orin la Thor, cum asigură Changfan fundația de calcul pentru „AI Fizic” (Physical AI)
- Articolul următor nu mai există niciunul