Paano Pumili ng GPU Server para sa LLM Inference sa 2026: VRAM, Topology, at Cooling
Panimula: Sa Inference Nahuhulog ang Tunay na Bayarin sa AI
Noong 2026, ang usapan tungkol sa AI ay lumipat mula sa training patungo sa inference. Ang pagsanay ng isang frontier model ay isang one-off capital event; ang pagserbisyo nito sa mga user ay isang permanenteng operating cost. Ayon sa mga pagtantya ng industriya, ang paggasta sa AI server ay nasa matarik na kurva, at ang bahagi ng compute na nakalaan sa inference kaysa sa training ay ngayo'y karamihan na ng deployed GPU hours. Para sa karamihan ng kumpanya, ang praktikal na tanong ay hindi na 'aling GPU ang pinakamabilis' kundi 'alig GPU server ang nagpapanatili ng mababang cost-per-million-tokens sa aking concurrency, model size, at rack power budget.' Sinasagot ng gabay na ito iyon gamit ang mga numero.
Ano ang Talagang Kini-Consume ng LLM Inference?
Mabilisang sagot: ang inference ay memory-bandwidth-bound, hindi compute-bound. Ang pagbuo ng bawat token ay nangangahulugan ng pag-stream ng model weights at KV cache sa GPU, kaya ang tokens per second ay sumusukat sa memory bandwidth at batch size nang mas malaki kaysa sa raw TFLOPS.
Dalawang yugto ang mahalaga. Ang Prefill ay pinoproseso ang buong prompt nang sabay-sabay at mabigat sa compute; ang Decode ay bumubuo ng output na token-isang-token at mabigat sa memory bandwidth. Kaya ang mahahabang prompt at mahahabang output ay nagpapahirap sa magkaibang resources. Iyan ang dahilan kung bakit ang isang card na may malaking TFLOPS ngunit maliit na VRAM at makitid na bandwidth ay maaaring matalo ng isang 'mas mabagal' na card na may mas malaking memory bandwidth sa tunay na chat workloads. Kapag sinukat ang isang server, sabay-sabay na tingnan ang VRAM capacity, VRAM bandwidth, at NVLink/PCIe topology, hindi lang ang spec-sheet peak FLOPS.
Gaano Karaming VRAM ang Kailangan Mo para sa mga Modelong 7B, 13B, 70B, at 180B?
Mabilisang sagot: maglaan ng humigit-kumulang 2 byte bawat parameter sa FP16, 1 byte sa INT8, at 0.5 byte sa INT4, pagkatapos ay magdagdag ng 15-30% para sa KV cache at runtime overhead. Ang isang modelong 70B sa INT8 ay nangangailangan ng humigit-kumulang 80-100 GB bago ang batching, na nangangahulugan ng kailangan ng hindi bababa sa 2x48GB o 4x24GB card.
Ang KV cache ay ang nakatagong gastos. Tumutubo ito kasama ng context length x concurrent sequences x layers, kaya ang isang server na kayang maglaman ng model sa 4K context ay maaaring maubusan ng memory sa 32K o sa mataas na concurrency. Planoing VRAM para sa p95 context length at target concurrency, hindi sa demo prompt. Bilang gabay, ang mga deployment na pinag-optimize para sa inference ay nag-iiwan ng 20-30% VRAM headroom para makapag-batch nang agresibo ang scheduler nang walang out-of-memory restarts.
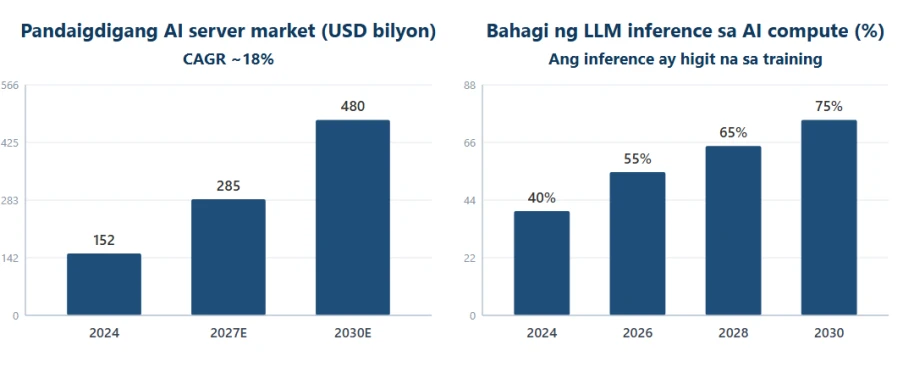
Figure 1: Laki ng AI server market at tumataas na bahagi ng LLM inference (data sources sa appendix)
4U Multi-GPU o 8-GPU Chassis? Topology, Cooling, at Expansion
Mabilisang sagot: isang 4U server na may 4-5 dual-width GPU ang sweet spot para sa karamihan ng private LLM deployments; lumipat sa 8-GPU NVLink platform lamang kapag ang isang model ay kailangang sumakop nang higit sa apat na GPU o kailangan mo ang maximum na per-node throughput.
Ang topology ay nagdedesisyon kung ang multi-GPU inference ay nasusukat. Ang PCIe-only fan-out ay sapat para sa maliliit na model at data-parallel serving, ngunit ang tensor-parallel serving ng isang 70B+ model ay nangangailangan ng high-bandwidth GPU-to-GPU links (NVLink/NVSwitch), o ang interconnect ay magiging bottleneck. Ang thermals ang nagdedesisyon kung ito ay mabubuhay: apat o limang 350-700W dual-width card sa 4U ay nangangailangan ng dedikadong rear GPU fan module at front-to-back airflow. Planoing 3+1 o 2+2 redundant power supplies at kumpirmahing kayang ibigay ng rack ang mga amp.
▪ Single GPU: pinakamainam para sa 7B-13B prototypes at low-concurrency internal tools.
▪ 2-4 GPU sa isang 4U: pinakamahusay na balanse ng capacity, redundancy, at power para sa 32B-70B models.
▪ 8-GPU NVLink node: para sa 70B+ tensor-parallel serving, multi-tenant APIs, o agent fleets.
▪ Laging i-verify ang PCIe lane allocation at rear fan clearance bago bumili.
Mga Sitwasyon ng LLM Inference kumpara sa GPU Server Configuration (2026)
Ang talahanayan sa ibaba ay nagmamapa ng mga karaniwang inference workloads sa isang starting hardware envelope. Ituring ito bilang sizing baseline, pagkatapos ay i-refine ayon sa measured tokens per second sa iyong sariling prompt mix.
Sitwasyon | Modelo & concurrency | GPU configuration | VRAM target | Inirerekomendang platform |
Prototype / single developer | 7B-13B, 1-3 users | 1x dual-width GPU | 24-48 GB | 1U/2U GPU workstation |
Team inference | 7B-32B, 5-20 users | 1-2x dual-width GPU | 48-96 GB | 2U GPU server |
Department LLM | 70B (INT8), 20-50 users | 2-4x GPU | 96-160 GB | 4U 4-GPU server |
Enterprise serving | 70B-180B, 50-200 users | 4-8x GPU + NVLink | 160-640 GB | 4U/8-GPU NVLink node |
Multi-tenant / agents | Anumang, 200+ users | 8x data-center GPU | 640 GB+ | 8-GPU HGX / cluster |
Talahanayan 1: LLM inference workloads kumpara sa GPU server configurations (2026)
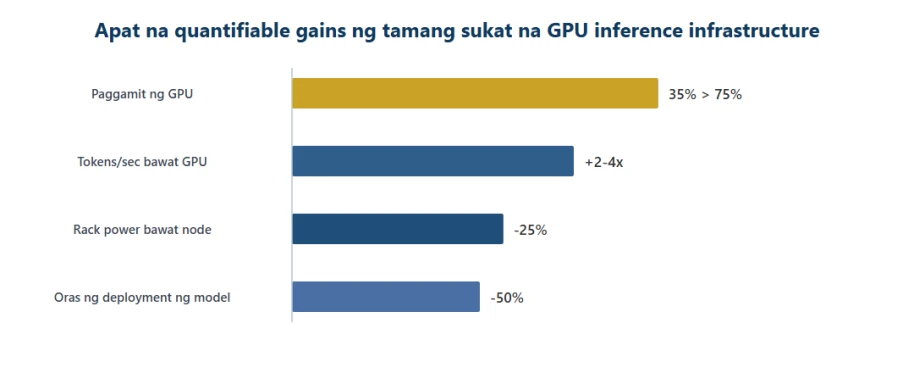
Figure 2: Apat na quantifiable gains ng tamang sukat na GPU inference infrastructure (illustrative, data sources sa appendix)
Power, Cooling, at ang Silid na Nakalimutan Mong I-budget
Mabilisang sagot: ang matitinding GPU servers ay nagbabago ng rack bilang space heater. Ang isang 4U node na may apat na 600W GPU kasama ang CPUs at fans ay maaaring humatak ng 3-4 kW; ang eight-GPU nodes ay tumatawid sa 8-10 kW. Kumpirmahing ang iyong PDU, circuit, at cooling ay kayang humawak nito bago dumating ang hardware.
Ang airflow direction, hot-aisle containment, at ambient temperature ay lahat ay nakakaapekto kung ang mga GPU ay mag-throttle sa ilalim ng patuloy na inference load. Kung ang iyong facility ay hindi kayang sumuporta sa high-density racks, isang 4U/4-GPU node sa katamtamang power ay kadalasang mas mapagkakatiwalaan kaysa sa isang theoretical 8-GPU monster na thermally throttles. Ang ingay ay ang isa pang nakalilimot na constraint: ang mga rear GPU fan modules ay maingay, kaya planuhin ang placement na malayo sa mga tao.
ChangFan GPU Servers: Isang Whole-System Platform na Ginawa para sa AI Inference
Ang industrial AI ay 70% workload at 30% hardware, ngunit ang maling 30% ay maaaring pawiin ang 70%. Ang Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) ay gumagawa ng rackmount GPU servers na in-engineer para sa patuloy na inference: ang mga 4U platforms ay sumusuporta ng hanggang 5 dual-width GPUs sa dual Intel Xeon Scalable (1st-5th Gen) na may hanggang 4TB DDR4/DDR5 ECC memory, single-socket AMD EPYC 7002/7003/8004 variants na may 4 dual-width GPUs, at 24-bay chassis na may opsyonal na NVMe para sa model storage. Ang bawat unit ay ishhip nang may dedikadong rear GPU fan module, 1+1 o 2+2 redundant power, onboard Gigabit networking, PCIe expansion, at IPMI remote management.
Kung ikaw ay nagsusuri ng isang private LLM, isang inference API, o isang agent fleet, makipag-ugnayan sa ChangFan para sa isang whole-system configuration recommendation na sinukat ayon sa model size x concurrency x rack power (hardware lamang, walang software subscription). Sinusuportahan ang OEM/ODM customization para sa mga integrator at brand.
Mga Madalas Itanong (FAQ)
Q1: Ilang GPU ang kailangan ng isang 7B model para sa inference?
A: Ang isang 24GB card ay nagpapatakbo ng 7B model sa INT8; para sa FP16 at katamtamang concurrency, isang 48GB card o dalawang 24GB card ay nagbibigay ng komportableng headroom. Ang VRAM, hindi ang FLOPS, ang unang constraint.
Q2: Dapat bang gamitin ang consumer RTX cards o data-center GPUs para sa inference?
A: Ang mga consumer cards ay nananalo sa presyo bawat GB para sa prototypes at low-concurrency internal tools; ang mga data-center GPUs ay nananalo sa memory bandwidth, NVLink, ECC, at 24/7 reliability. Pumili ayon sa SLA at concurrency, hindi sa peak FLOPS.
Q3: Sapat ba ang isang 4U 4-GPU server para sa 70B model?
A: Para sa INT8 serving sa katamtamang concurrency, oo: ang 4x48GB (192GB) ay komportableng naglalaman ng 70B INT8 model kasama ang KV cache. Para sa FP16, mataas na concurrency, o 180B models, lumipat sa 8-GPU NVLink node.
Q4: Laging ba ibig sabihin ng mas maraming VRAM ay mas mabilis na inference?
A: Hindi. Ang tokens per second ay depende sa memory bandwidth, batch size, at interconnect. Ang karagdagang capacity ay pumipigil sa OOM at nagpapahintulot ng mas malaking batches, ngunit ang bandwidth at topology ang nagdedesisyon ng throughput.
Q5: Maaari ba akong magdagdag ng GPU sa isang standard 2U server sa susunod?
A: Karaniwan ay hindi ligtas: ang mga standard servers ay kulang sa GPU power cabling, rear fan modules, at PCIe lane allocation para sa dual-width cards. Bumili ng chassis na dinisenyo para sa GPUs mula unang araw.
- Nakaraang artikulo Ang Paglawak ng Edge AI sa 2026: Mula Orin hanggang Thor, Paano Sinisiguro ng Changfan ang Pundasyon ng Computing para sa "Physical AI"
- Susunod na artikulo wala nang natitira