Jak vybrat GPU server pro LLM inferenci v roce 2026: VRAM, topologie a chlazení
Úvod: inference je místo, kde skutečně přichází účet za AI
V roce 2026 se debata o AI posunula od trénování k inferenci. Natrénovat špičkový model je jednorázová kapitálová investice; provozovat jej pro uživatele je trvalý provozní náklad. Odhady staví výdaje na AI servery na strmou křivku a podíl výpočtů věnovaných inferenci namísto trénování nyní tvoří většinu nasazených GPU hodin. Pro většinu firem už praktická otázka nezní „který GPU je nejrychlejší“, ale „který GPU server udrží nízké náklady na milion tokenů při mé souběžnosti, velikosti modelu a rozpočtu na příkon racku“. Tento průvodce odpovídá čísly.
Co LLM inference skutečně spotřebovává?
Krátká odpověď: inference je omezena propustností paměti, nikoli výpočtem. Generování každého tokenu znamená protlačit váhy modelu a KV-cache přes GPU, takže tokeny za sekundu škálují mnohem více s propustností paměti a velikostí dávky než se surovými TFLOPS.
Záleží na dvou fázích. Prefill zpracovává celý prompt paralelně a je výpočetně náročný; decode generuje výstup token po tokenu a je náročný na propustnost paměti. Dlouhé prompty a dlouhé výstupy proto zatěžují různé zdroje. Proto může karta s obrovskými TFLOPS, ale malou VRAM a úzkou propustností prohrát s „pomalejší“ kartou s větší propustností paměti na reálných chatových zátěžích. Při dimenzování serveru sledujte kapacitu VRAM, propustnost VRAM a topologii NVLink/PCIe společně, ne jen špičkové FLOPS z datasheetu.
Kolik VRAM potřebují modely 7B, 13B, 70B a 180B?
Krátká odpověď: počítejte zhruba 2 bajty na parametr v FP16, 1 bajt v INT8 a 0,5 bajtu v INT4, pak přidejte 15-30 % na KV-cache a režijní náklady. Jediný model 70B v INT8 potřebuje před batchováním asi 80-100 GB, tedy alespoň karty 2x48 GB nebo 4x24 GB.
KV-cache je skrytý náklad. Roste s délkou kontextu x počtem souběžných sekvencí x počtem vrstev, takže server, který model udrží při kontextu 4K, může dojít paměť při 32K nebo vysoké souběžnosti. Plánujte VRAM pro délku kontextu p95 a cílovou souběžnost, ne pro demo prompt. Zpravidla inferenčně optimalizovaná nasazení nechávají 20-30 % rezervu VRAM, aby plánovač mohl agresivně batchovat bez restartů kvůli OOM.
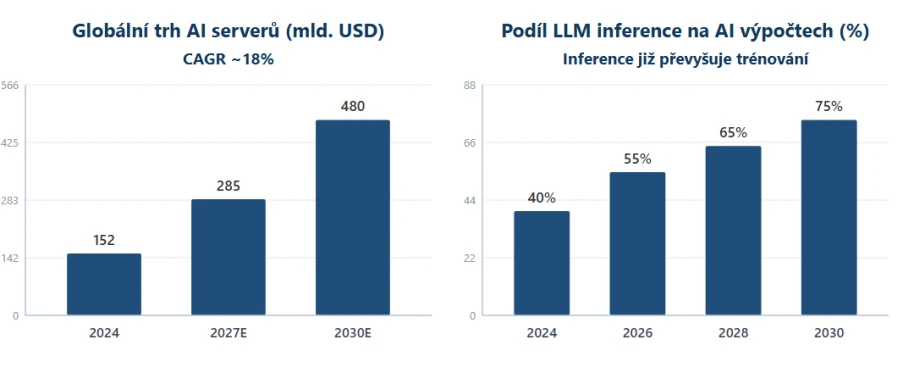
Obrázek 1: velikost trhu AI serverů a rostoucí podíl LLM inference (zdroje v příloze)
4U multi-GPU, nebo šasi s 8 GPU? Topologie, chlazení a rozšíření
Krátká odpověď: jeden 4U server se 4-5 dvouslotovými GPU je optimem pro většinu privátních nasazení LLM; na platformu 8 GPU NVLink přejděte jen tehdy, když jeden model musí přesáhnout čtyři GPU nebo potřebujete maximální propustnost na uzel.
Topologie rozhoduje, zda multi-GPU inference škáluje. Distribuce pouze přes PCIe stačí pro malé modely a data-parallel obsluhu, ale tensor-parallel obsluha modelu 70B+ vyžaduje vysokorychlostní propojení GPU-GPU (NVLink/NVSwitch), jinak se propojení stane úzkým hrdlem. Termika rozhoduje o přežití: čtyři nebo pět dvouslotových karet 350-700 W ve 4U vyžadují vyhrazený zadní modul ventilátorů GPU a proudění vzduchu zepředu dozadu. Naplánujte redundanci napájení 3+1 nebo 2+2 a ověřte, že rack dodá potřebné ampéry.
▪ Jeden GPU: nejlepší pro prototypy 7B-13B a interní nástroje s nízkou souběžností.
▪ 2-4 GPU v jednom 4U: nejlepší rovnováha kapacity, redundance a příkonu pro modely 32B-70B.
▪ Uzel 8 GPU NVLink: pro tensor-parallel obsluhu 70B+, multi-tenant API nebo flotily agentů.
▪ Před nákupem vždy ověřte přidělení linek PCIe a prostor pro zadní ventilátory.
Scénáře LLM inference vs konfigurace GPU serveru (2026)
Tabulka níže mapuje typické inferenční zátěže na výchozí hardwarový rozsah. Berte ji jako základ dimenzování a doladěte podle naměřených tokenů za sekundu na vaší vlastní směsi promptů.
Scénář | Model a souběžnost | Konfigurace GPU | Cílová VRAM | Doporučená platforma |
Prototyp / jeden vývojář | 7B-13B, 1-3 uživatelé | 1 dvouslotová GPU | 24-48 GB | GPU stanice 1U/2U |
Týmová inference | 7B-32B, 5-20 uživatelů | 1-2 dvouslotové GPU | 48-96 GB | GPU server 2U |
Oddělení / LLM | 70B (INT8), 20-50 uživatelů | 2-4 GPU | 96-160 GB | Server 4U se 4 GPU |
Podniková obsluha | 70B-180B, 50-200 uživatelů | 4-8 GPU + NVLink | 160-640 GB | Uzel 4U/8 GPU NVLink |
Multi-tenant / agenti | Libovolný, 200+ uživatelů | 8 GPU datového centra | 640 GB+ | 8 GPU HGX / cluster |
Tabulka 1: inferenční zátěže LLM vs konfigurace GPU serveru (2026)
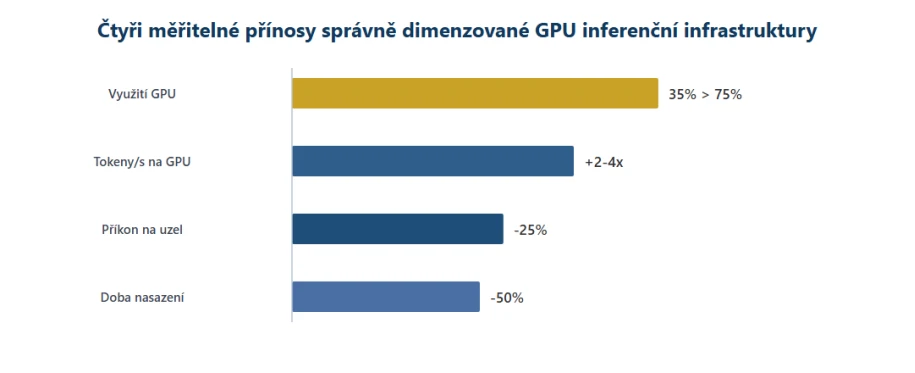
Obrázek 2: čtyři měřitelné přínosy správně dimenzované GPU inferenční infrastruktury (ilustrativní, zdroje v příloze)
Napájení, chlazení a místnost, kterou jste zapomněli rozpočtovat
Krátká odpověď: husté GPU servery mění rack v topidlo. Uzel 4U se čtyřmi GPU po 600 W plus CPU a ventilátory může odebírat 3-4 kW; uzly s 8 GPU překračují 8-10 kW. Ověřte, že PDU, obvod a chlazení to zvládnou, než hardware dorazí.
Směr proudění vzduchu, uzavření horkých uliček a okolní teplota rozhodují, zda GPU budou pod trvalou inferenční zátěží throttlovat. Pokud váš prostor nepodporuje racky s vysokou hustotou, uzel 4U/4 GPU s mírným příkonem bývá spolehlivější než teoretické monstrum s 8 GPU, které tepelně throttluje. Hluk je dalším zapomenutým omezením: zadní moduly ventilátorů GPU jsou hlučné, proto plánujte umístění mimo osoby.
GPU servery ChangFan: celosystémová platforma pro AI inferenci
Průmyslová AI je ze 70 % zátěž a z 30 % hardware, ale špatných 30 % může vynulovat 70 %. Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) vyrábí rackové GPU servery navržené pro trvalou inferenci: platformy 4U s až 5 dvouslotovými GPU na dvou Intel Xeon Scalable (1.-5. generace) s pamětí DDR4/DDR5 ECC až 4 TB, jednozásuvkové varianty AMD EPYC 7002/7003/8004 se 4 dvouslotovými GPU a šasi s 24 pozicemi s volitelným NVMe pro úložiště modelů. Každá jednotka má vyhrazený zadní modul ventilátorů GPU, redundantní napájení 1+1 nebo 2+2, integrovanou síť Gigabit, rozšíření PCIe a vzdálenou správu IPMI.
Pokud zvažujete privátní LLM, inferenční API nebo flotilu agentů, kontaktujte ChangFan pro doporučení celosystémové konfigurace dimenzované podle velikosti modelu x souběžnosti x příkonu racku (pouze hardware, bez softwarového předplatného). Podporujeme OEM/ODM přizpůsobení pro integrátory a značky.
Časté dotazy (FAQ)
Q1: Kolik GPU potřebuje model 7B pro inferenci?
O: Jedna karta 24 GB provozuje model 7B v INT8; pro FP16 a mírnou souběžnost dává jedna karta 48 GB nebo dvě 24 GB pohodlnou rezervu. Prvním omezením je VRAM, ne FLOPS.
Q2: Použít spotřebitelské RTX, nebo datové GPU?
O: Spotřebitelské karty vyhrávají cenou za GB u prototypů a interních nástrojů s nízkou souběžností; datová GPU vyhrávají propustností paměti, NVLink, ECC a spolehlivostí 24/7. Vybírejte podle SLA a souběžnosti, ne podle špičkových FLOPS.
Q3: Stačí server 4U se 4 GPU pro model 70B?
O: Pro INT8 obsluhu při mírné souběžnosti ano: 4x48 GB (192 GB) pohodlně udrží model 70B INT8 plus KV-cache. Pro FP16, vysokou souběžnost nebo modely 180B přejděte na uzel 8 GPU NVLink.
Q4: Znamená více VRAM vždy rychlejší inferenci?
O: Ne. Tokeny za sekundu závisí na propustnosti paměti, velikosti dávky a propojení. Větší kapacita brání OOM a umožňuje větší dávky, ale propustnost a topologie rozhodují o výkonu.
Q5: Mohu později přidat GPU do standardního 2U serveru?
O: Obvykle ne bezpečně: standardní servery nemají kabeláž napájení GPU, zadní moduly ventilátorů ani přidělení linek PCIe pro dvouslotové karty. Kupujte šasi navržené pro GPU od začátku.
- Předchozí článek Rozšíření Edge AI v roce 2026: Od Orin po Thor, jak Changfan zajišťuje výpočetní základ pro „Fyzickou AI“ (Physical AI)
- Další článek už žádné nejsou