العنوان 1: كيف تختار خادم GPU لاستدلال LLM في 2026: الذاكرة VRAM والطوبولوجيا والتبريد
ما الذي يستهلكه استدلال LLM فعليًا؟
إجابة سريعة: الاستدلال محدود بعرض نطاق الذاكرة لا بقوة الحوسبة. توليد كل رمز يعني تمرير أوزان النموذج وذاكرة KV عبر GPU، لذا يتناسب عدد الرموز في الثانية مع عرض نطاق الذاكرة وحجم الدفعة أكثر بكثير من TFLOPS الخام.
تهمّ مرحلتان. تعالج Prefill المطالبة كاملة على التوازي وهي كثيفة الحوسبة؛ وتولّد Decode المخرجات رمزًا برمز وهي كثيفة عرض النطاق. لذلك ترهق المطالبات الطويلة والمخرجات الطويلة موارد مختلفة. ولهذا قد تخسر بطاقة ذات TFLOPS هائلة لكن بذاكرة VRAM صغيرة وعرض نطاق ضيق أمام بطاقة «أبطأ» بعرض نطاق أكبر في أحمال المحادثة الواقعية. عند تحديد حجم الخادم، راقب سعة VRAM وعرض نطاق VRAM وطوبولوجيا NVLink/PCIe معًا، وليس ذروة FLOPS في ورقة المواصفات فقط.
كم من VRAM تحتاج نماذج 7B و13B و70B و180B؟
إجابة سريعة: احسب نحو 2 بايت لكل معامل في FP16، وبايت واحد في INT8، ونصف بايت في INT4، ثم أضف 15-30% لذاكرة KV والنفقات التشغيلية. يحتاج نموذج 70B واحد في INT8 إلى نحو 80-100 غيغابايت قبل التجميع، أي بطاقات 2×48 غيغابايت أو 4×24 غيغابايت على الأقل.
ذاكرة KV هي التكلفة الخفية. تنمو مع طول السياق × التسلسلات المتزامنة × الطبقات، لذا قد ينفد خادم يستوعب نموذجًا عند سياق 4K من الذاكرة عند 32K أو مع التزامن العالي. خطّط لـ VRAM وفق طول السياق p95 والتزامن المستهدف، لا وفق مطالبة العرض التجريبي. وكقاعدة عامة، تترك عمليات النشر المحسّنة للاستدلال هامشًا 20-30% من VRAM حتى يتمكن المجدول من التجميع بقوة دون إعادة تشغيل بسبب نفاد الذاكرة.
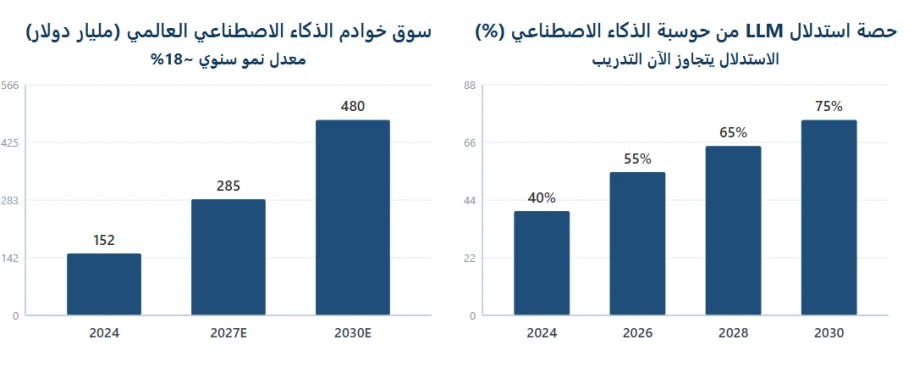
الشكل 1: حجم سوق خوادم الذكاء الاصطناعي وتزايد حصة استدلال LLM (المصادر في الملحق)
4U متعدد GPU أم هيكل 8 GPU؟ الطوبولوجيا والتبريد والتوسعة
إجابة سريعة: خادم 4U واحد بأربع إلى خمس بطاقات GPU مزدوجة العرض هو الخيار الأمثل لمعظم عمليات نشر LLM الخاصة؛ انتقل إلى منصة 8 GPU بتقنية NVLink فقط عندما يجب أن يمتد نموذج واحد على أكثر من أربع بطاقات أو تحتاج أقصى إنتاجية لكل عقدة.
تحسم الطوبولوجيا ما إذا كان استدلال GPU المتعدد يتوسّع. يكفي التوزيع عبر PCIe فقط للنماذج الصغيرة والخدمة المتوازية بياناتيًا، لكن الخدمة المتوازية تنسوريًا لنموذج 70B+ تتطلب روابط GPU-GPU عالية النطاق (NVLink/NVSwitch)، وإلا يصبح الترابط عنق الزجاجة. ويحسم التبريد بقاءه: أربع أو خمس بطاقات مزدوجة العرض بقدرة 350-700 واط في 4U تتطلب وحدة مراوح GPU خلفية مخصصة وتدفق هواء من الأمام إلى الخلف. خطّط لمصادر طاقة احتياطية 3+1 أو 2+2 وتأكد من أن الرف يوفّر الأمبيرات.
▪ GPU واحد: الأفضل لنماذج 7B-13B الأولية والأدوات الداخلية منخفضة التزامن.
▪ 2-4 GPU في 4U واحد: أفضل توازن بين السعة والتكرار والطاقة لنماذج 32B-70B.
▪ عقدة 8 GPU NVLink: للخدمة المتوازية تنسوريًا 70B+ أو واجهات متعددة المستأجرين أو أسطول الوكلاء.
▪ تحقّق دائمًا من تخصيص مسارات PCIe ومساحة المراوح الخلفية قبل الشراء.
سيناريوهات استدلال LLM مقابل تكوين خادم GPU (2026)
يربط الجدول أدناه أحمال الاستدلال النموذجية بمظروف عتاد مبدئي. اعتبره خط أساس للحجم، ثم اضبطه بعدد الرموز في الثانية المقاس على مزيج مطالباتك.
السيناريو | النموذج والتزامن | تكوين GPU | هدف VRAM | المنصة الموصى بها |
نموذج أولي / مطور واحد | 7B-13B، 1-3 مستخدمين | 1 GPU مزدوج العرض | 24-48 غيغابايت | محطة GPU 1U/2U |
استدلال الفريق | 7B-32B، 5-20 مستخدمًا | 1-2 GPU مزدوج العرض | 48-96 غيغابايت | خادم GPU 2U |
LLM قسمي | 70B (INT8)، 20-50 مستخدمًا | 2-4 GPU | 96-160 غيغابايت | خادم 4U بـ4 GPU |
خدمة مؤسسية | 70B-180B، 50-200 مستخدم | 4-8 GPU + NVLink | 160-640 غيغابايت | عقدة 4U/8 GPU NVLink |
متعدد المستأجرين / وكلاء | أي، 200+ مستخدم | 8 GPU لمركز بيانات | 640 غيغابايت+ | 8 GPU HGX / عنقود |
الجدول 1: أحمال استدلال LLM مقابل تكوينات خادم GPU (2026)
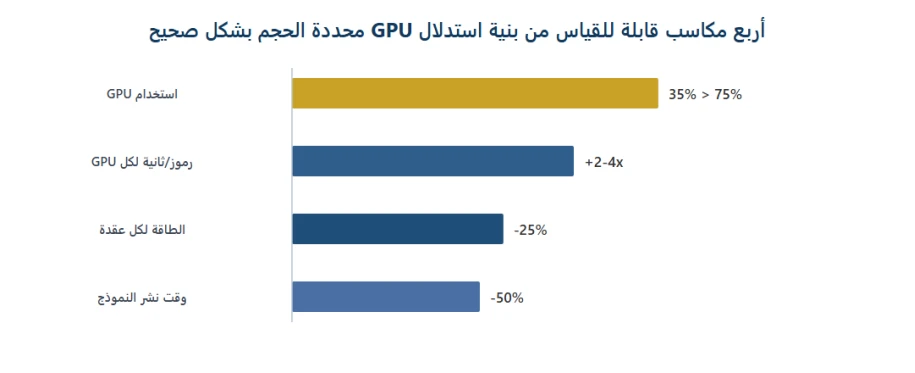
الشكل 2: أربع مكاسب قابلة للقياس من بنية استدلال GPU محددة الحجم بشكل صحيح (توضيحي، المصادر في الملحق)
الطاقة والتبريد والغرفة التي نسيت تخصيص ميزانية لها
إجابة سريعة: تحوّل خوادم GPU الكثيفة الرف إلى مدفأة. قد تسحب عقدة 4U بأربع بطاقات 600 واط إضافة إلى المعالجات والمراوح 3-4 كيلوواط؛ وتتجاوز عقد 8 GPU عتبة 8-10 كيلوواط. تأكد من أن PDU والدائرة والتبريد تتحمل ذلك قبل وصول العتاد.
يحدد اتجاه تدفق الهواء واحتواء الممرات الساخنة ودرجة الحرارة المحيطة ما إذا كانت بطاقات GPU ستخفض ترددها تحت حمل الاستدلال المستمر. إذا كانت منشأتك لا تدعم رفوف الكثافة العالية، فغالبًا ما تكون عقدة 4U/4 GPU بقدرة معتدلة أكثر موثوقية من وحش نظري بـ8 GPU يخنق حراريًا. الضوضاء قيد آخر منسي: وحدات مراوح GPU الخلفية صاخبة، لذا خطّط لوضعها بعيدًا عن الأشخاص.
خوادم ChangFan GPU: منصة متكاملة صُممت لاستدلال الذكاء الاصطناعي
الذكاء الاصطناعي الصناعي 70% حمل عمل و30% عتاد، لكن الـ30% الخاطئة قد تمحو الـ70%. تصنّع Guangzhou ChangFan Intelligent Technology Co., Ltd. (ChangFan) خوادم GPU مثبتة على الرفوف مصممة للاستدلال المستمر: منصات 4U تدعم حتى 5 بطاقات GPU مزدوجة العرض على معالجي Intel Xeon Scalable (الجيل 1-5) بذاكرة DDR4/DDR5 ECC تصل إلى 4 تيرابايت، ونسخ أحادية المقبس AMD EPYC 7002/7003/8004 بأربع بطاقات GPU مزدوجة العرض، وهياكل بـ24 فتحة مع NVMe اختياري لتخزين النماذج. تأتي كل وحدة بوحدة مراوح GPU خلفية مخصصة، وطاقة احتياطية 1+1 أو 2+2، وشبكة Gigabit مدمجة، وتوسعة PCIe، وإدارة عن بُعد IPMI.
إذا كنت تقيّم LLM خاصًا أو واجهة استدلال API أو أسطول وكلاء، تواصل مع ChangFan للحصول على توصية تكوين متكاملة محددة وفق حجم النموذج × التزامن × طاقة الرف (عتاد فقط، دون اشتراك برمجي). ندعم تخصيص OEM/ODM للمتكاملين والعلامات التجارية.
الأسئلة الشائعة (FAQ)
س1: كم بطاقة GPU يحتاج نموذج 7B للاستدلال؟
ج: تكفي بطاقة واحدة بسعة 24 غيغابايت لتشغيل نموذج 7B في INT8؛ ولـFP16 مع تزامن معتدل، توفّر بطاقة 48 غيغابايت أو بطاقتان 24 غيغابايت هامشًا مريحًا. القيد الأول هو VRAM لا FLOPS.
س2: هل أستخدم بطاقات RTX الاستهلاكية أم GPU مراكز البيانات؟
ج: تتفوق البطاقات الاستهلاكية في السعر لكل غيغابايت للنماذج الأولية والأدوات الداخلية منخفضة التزامن؛ وتتفوق GPU مراكز البيانات في عرض نطاق الذاكرة وNVLink وECC والموثوقية على مدار الساعة. اختر وفق SLA والتزامن لا وفق ذروة FLOPS.
س3: هل يكفي خادم 4U بـ4 GPU لنموذج 70B؟
ج: لخدمة INT8 بتزامن معتدل نعم: 4×48 غيغابايت (192 غيغابايت) تستوعب بارتياح نموذج 70B INT8 إضافة إلى ذاكرة KV. ولـFP16 أو التزامن العالي أو نماذج 180B، انتقل إلى عقدة 8 GPU NVLink.
س4: هل يعني VRAM أكبر دائمًا استدلالًا أسرع؟
ج: لا. يعتمد عدد الرموز في الثانية على عرض نطاق الذاكرة وحجم الدفعة والترابط. تمنع السعة الإضافية نفاد الذاكرة وتتيح دفعات أكبر، لكن عرض النطاق والطوبولوجيا يحددان الإنتاجية.
س5: هل يمكنني إضافة GPU لخادم 2U قياسي لاحقًا؟
ج: عادةً لا بأمان: تفتقر الخوادم القياسية إلى كابلات طاقة GPU ووحدات المراوح الخلفية وتخصيص مسارات PCIe للبطاقات مزدوجة العرض. اشترِ هيكلًا مصممًا لبطاقات GPU من البداية.
الملحق: استراتيجية النشر SEO وGEO
1. مصفوفة الكلمات المفتاحية (T1/T2/T3)
المستوى | الكلمات المفتاحية | نية البحث |
T1 (أساسي) | خادم GPU لاستدلال LLM، خادم استدلال الذكاء الاصطناعي، اختيار خادم GPU | بحث تجاري |
T2 (سيناريو) | نشر LLM خاص، استدلال LLM على نطاق واسع، خادم 8 GPU، خادم GPU 4U | مقارنة حلول |
T3 (عتاد) | خادم GPU ثنائي Xeon، خادم GPU من AMD EPYC، تصنيع OEM/ODM لخادم GPU | البحث عن مورد |
ربط المنظومة: اقرن مصطلحات عالية النية مثل vLLM وTensorRT-LLM وOllama وKubernetes لتظهر الصفحة في استعلامات النشر لا العتاد فقط.
2. خطة النشر حسب القناة
▪ Google / cfitsi.com (EN): استخدم slug gpu-server-llm-inference-2026؛ أبقِ الجدول 1 كجدول HTML؛ روابط داخلية إلى صفحتي منتج خادم GPU 4U وخادم 8 GPU.
▪ Baidu / الموقع الصيني: ضع اختيار خادم GPU في أول 12 حرفًا من العنوان؛ أضف نص alt محليًا للشكل 1؛ أرفق نموذج استفسار لتكوين خادم استدلال LLM.
▪ LinkedIn: انشر جدول اختيار العتاد كعرض دوّار؛ واجذب الانتباه بعبارة «نموذج 70B على 4 بطاقات GPU: هكذا يكون الحساب».
▪ YouTube / TikTok: 3 مقاطع قصيرة - حساب VRAM في 60 ثانية، ولماذا لا يمكن لحاسوب مكتبي خدمة LLM، و4U مقابل 8 GPU: الفرق الحقيقي.
- المقال السابق العنوان الرئيسي: توسيع نطاق الذكاء الاصطناعي الطرفي في 2026: من Orin إلى Thor، كيف تؤمن Changfan قاعدة الحوسبة لـ "الذكاء الاصطناعي الفيزيائي" (Physical AI)
- المقال التالي لا يوجد المزيد